本文解析YOLOX结构并基于Paddle构建网络。YOLOX改进自YOLOv3,含Decoupled Head等改进。网络分主干CSPDarknet、PAN Head、YOLO Head。文中构建各组件,如ConvBlock等,组装成各部分并测试,验证了网络结构正确性,训练预测后续讨论。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
本Notebook对YOLOX的网络结构进行了解析,并采用PaddlePaddle框架对于YOLOX的网络结构进行了构建。
注:本Notebook仅讨论网络的构建部分,网络的训练、预测过程将在后续NoteBook进行讨论。
YOLOX是旷视科技(Megvii)在YOLOv3基础上改进的。主要改进的部分在于 Decoupled Head、Anchor Free、SimOTA、Data Aug。另外为了yolov5对比,主干网络引入了yolov5的FOCUS、CSPNet、PAN Head、SiLU激活。
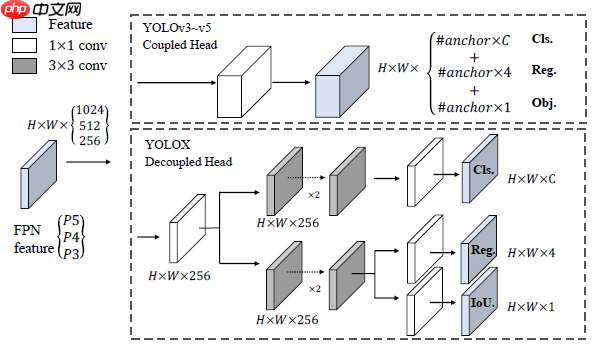
Decoupled Head是学术领域一阶段网络的标准配置。然而,以前版本的YOLO所用的预测头是一起的,分类和回归在一个1x1卷积中实现。
作者实验发现End2End的YOLOX始终比标准YOLOX低4-5个点,偶然间把原始YOLO Head换成Decoupled Head,发现差距显著缩小,认为YOLO Head的表达能力可能有所欠缺。
YOLOX中,YOLO Head将分类和回归分别实现,最后预测时才整合。经过权衡速度和性能得失,最终使用1个1x1卷积先进行降维,并在分类和回归分支里各使用了2个3x3卷积。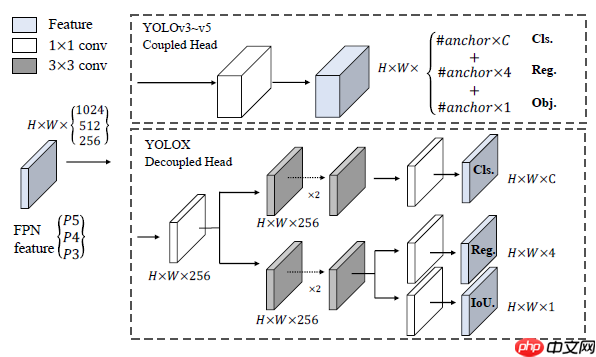
Anchor Free有以下几个好处:
Anchor Free技术目前可以上YOLO,且性能不降反升,与样本匹配有密不可分的联系。
样本匹配算法可以天然缓解拥挤场景检测问题、缓解极端长宽比的物体检测效果差的问题、极端大小目标正样本不均衡问题、缓解旋转物体检测效果不好的问题。
作者认为样本匹配中主要有四个重要因素:
数据增强方面延用Mosaic和Mixup数据增强技术,利用了四张图片进行拼接实现数据中增强,丰富了检测物体的背景。
Mosaic方法在YOLOv4中提出,主要思想是将四张图片进行随机裁剪,再拼接到一张图上作为训练数据。好处是丰富了图片背景,且四张图片拼接在一起变相提高batch_size,在进行batch normalization的时候也会计算四张图片,对本身batch_size不是很依赖。
具体可参考论文:YOLOv4: Optimal Speed and Accuracy of Object Detection
Mixup方法使用朴素的线性插值方法得到新扩展数据。
具体可参考论文:mixup: Beyond Empirical Risk Minimization
参考B站Up主Bubbliiiing绘制的网络结构图,网络整体可以分为三个部分:主干网络CSPDarknet、特征加强的PAN Head、检测头YOLO Head。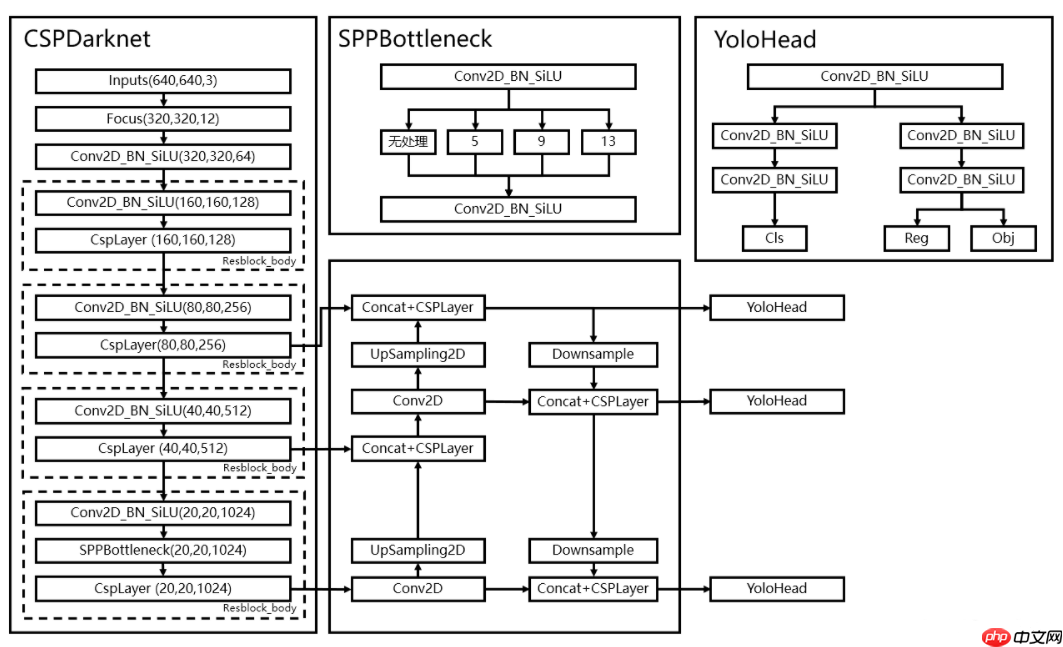
# 引入库import paddlefrom paddle import nn
基本卷积块包含卷积、批归一化和激活函数。基本卷积块采用等大填充Same Padding,包含一般卷积(BaseConv)和深度可分离卷积(DWConv)两种类型。
BaseConv结构示意
| Input |
|---|
| Conv2D |
| Batch Norm |
| Act |
Bottleneck残差卷积块,主干采用2个基本卷积块,卷积核大小分别为1和3,残差部分保持原输入,结果输出主干与残差边之和。
Bottleneck结构示意
 LangChain
一个开源框架,用于构建基于大型语言模型(LLM)的应用程序。
 114
查看详情

| Input | |
|---|---|
| BaseConv 1x1 | Identity |
| BaseConv 3x3 | |
| Add | |
## 构建卷积块class BaseConv(nn.Layer):
    def __init__(self, in_channels, out_channels, kernel_size, stride, groups=1, act='silu'):
        super().__init__()
        padding = (kernel_size-1)//2
        self.conv = nn.Conv2D(in_channels, out_channels, kernel_size, stride, padding, groups=groups)
        self.bn = nn.BatchNorm2D(out_channels,momentum=0.03, epsilon=0.001)        if act == 'silu':
            self.act = nn.Silu()        elif act == 'relu':
            self.act = nn.ReLU()        elif act == 'lrelu':
            self.act = nn.LeakyReLU(0.1)    def forward(self, x):
        return self.act(self.bn(self.conv(x)))
In [3]
## 构建深度可分离卷积class DWConv(nn.Layer):
    # Some Problem
    def __init__(self, in_channels, out_channels, kernel_size, stride=1, act='silu'):
        super().__init__()
        self.dconv = BaseConv(in_channels, in_channels, kernel_size, stride, groups=in_channels, act=act)
        self.pconv = BaseConv(in_channels, out_channels, 1, 1, groups=1, act=act)    def forward(self, x):
        x = self.dconv(x)        return self.pconv(x)
In [4]
## 构建残差结构class Bottleneck(nn.Layer):
    def __init__(self, in_channels, out_channels, shortcut=True, expansion=0.5, depthwise=False, act="silu"):
        super().__init__()
        hidden_channels = int(out_channels * expansion)
        Conv = DWConv if depthwise else BaseConv        # 1x1卷积进行通道数的缩减(缩减率默认50%)
        self.conv1 = BaseConv(in_channels, hidden_channels, 1, stride=1, act=act)        # 3x3卷积进行通道数的拓张(特征提取)
        self.conv2 = Conv(hidden_channels, out_channels, 3, stride=1, act=act)
        self.use_add = shortcut and in_channels == out_channels    def forward(self, x):
        y = self.conv2(self.conv1(x))        if self.use_add:
            y = y + x        return y
In [5]
## 测试卷积模块x = paddle.ones([1, 3, 640, 640])
conv1 = BaseConv(3, 64, 3, 1)
conv2 = DWConv(3, 64, 3, 1)
block1 = Bottleneck(3, 64)print(conv1(x).shape)print(conv2(x).shape)print(block1(x).shape)
/opt/conda/envs/python35-paddle120-env/lib/python3.7/site-packages/paddle/nn/layer/norm.py:653: UserWarning: When training, we now always track global mean and variance.
  "When training, we now always track global mean and variance.")
[1, 64, 640, 640]
[1, 64, 640, 640]
[1, 64, 640, 640]
Focus最早在YOLOv5(并无论文)中提出,具体操作是在一张图片中每隔一个像素拿到一个值,类似于邻近下采样,这样就获得了四张图片,四张图片互补,将W、H信息集中到了通道空间C,输入通道扩充为4倍,拼接起来的图片相对于原先的RGB三通道模式变成了12个通道,最后将得到的新图片再经过卷积操作,最终得到了没有信息丢失情况下的二倍下采样特征图。
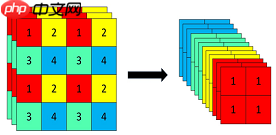
Focus作用是为了提速,作者提到使用Focus层可以减少参数计算,减少Cuda使用内存。
In [6]## Focus层class Focus(nn.Layer):
def __init__(self, in_channels, out_channels, ksize=1, stride=1, act="silu"):
super().__init__()
self.conv = BaseConv(in_channels * 4, out_channels, ksize, stride, act=act) def forward(self, x):
# 分别获得4个2倍下采样结果
patch_1 = x[..., ::2, ::2]
patch_2 = x[..., 1::2, ::2]
patch_3 = x[..., ::2, 1::2]
patch_4 = x[..., 1::2, 1::2] # 沿通道方向拼接4个下采样结果
x = paddle.concat((patch_1, patch_2, patch_3, patch_4), axis=1) # 拼接结果做卷积
out = self.conv(x) return out
In [7]
## 测试FOCUS模块x = paddle.ones([1, 3, 640, 640])
layer = Focus(3, 64)print(layer(x).shape)
[1, 64, 320, 320]
CSPLayer主要结构如下图所示,在常规结构基础上,引入一条类似残差结构的分支。
主干部分采用1个基本卷积块+堆叠N个Bottleneck残差块结构提取特征,残差部分采用1个基本卷积块,最后合并两个分支再作用一次基本卷积块。
CSPLayer结构示意
| Input | |
|---|---|
| BaseConv 1x1 | BaseConv 1x1 |
| Bottleneck(x N) | |
| Concat | |
| BaseConv 1x1 | |
## CSPLayerclass CSPLayer(nn.Layer):
    def __init__(self, in_channels, out_channels, n=1, shortcut=True, expansion=0.5, depthwise=False, act="silu",):
        super().__init__()
        hidden_channels = int(out_channels * expansion)
        # 主干部分的基本卷积块
        self.conv1  = BaseConv(in_channels, hidden_channels, 1, stride=1, act=act)        # 残差边部分的基本卷积块
        self.conv2  = BaseConv(in_channels, hidden_channels, 1, stride=1, act=act)        # 拼接主干与残差后的基本卷积块
        self.conv3  = BaseConv(2 * hidden_channels, out_channels, 1, stride=1, act=act)        # 根据循环次数构建多个残差块瓶颈结构
        res_block = [Bottleneck(hidden_channels, hidden_channels, shortcut, 1.0, depthwise, act=act) for _ in range(n)]
        self.res_block = nn.Sequential(*res_block)    def forward(self, x):
        # 主干部分
        x_main = self.conv1(x)
        x_main = self.res_block(x_main)        # 残差边部分
        x_res = self.conv2(x)        # 主干部分和残差边部分进行堆叠
        x = paddle.concat((x_main, x_res), axis=1)
        # 对堆叠的结果进行卷积的处理
        out = self.conv3(x)        return out
In [9]
## 测试CSPLayer模块x = paddle.ones([1, 3, 640, 640])
layer = CSPLayer(3, 64, 5)print(layer(x).shape)
[1, 64, 640, 640]
SPPBottleneck主要结构如下图所示,采用卷积块1+4条通路+拼接+卷积块2的整体结构。
卷积块1将通道数缩减一半;4条通路下采样为原始输入和窗口大小分别为5,9,13的最大池化;沿通道方向拼接;卷积块2调整输出通道数。
SPPBottleneck结构示意
| Input | |||
|---|---|---|---|
| BaseConv 1x1 | |||
| Identity | MaxPool 5x5 | MaxPool 9x9 | MaxPool 13x13 |
| Concat | |||
| BaseConv 1x1 | |||
## SPPBottleneckclass SPPBottleneck(nn.Layer):
    def __init__(self, in_channels, out_channels, kernel_sizes=(5, 9, 13), activation="silu"):
        super().__init__()
        hidden_channels = in_channels // 2
        self.conv1      = BaseConv(in_channels, hidden_channels, 1, stride=1, act=activation)
        self.pool_block = nn.Sequential(*[nn.MaxPool2D(kernel_size=ks, stride=1, padding=ks // 2) for ks in kernel_sizes])
        conv2_channels  = hidden_channels * (len(kernel_sizes) + 1)
        self.conv2      = BaseConv(conv2_channels, out_channels, 1, stride=1, act=activation)    def forward(self, x):
        x = self.conv1(x)
        x = paddle.concat([x] + [pool(x) for pool in self.pool_block], axis=1)
        x = self.conv2(x)        return x
In [11]
## 测试SPPBottleneck模块x = paddle.ones([1, 3, 640, 640])
layer = SPPBottleneck(3, 64)print(layer(x).shape)
[1, 64, 640, 640]
CSPDarknet为YOLOX的主干网络用于网络的特征提取,结果将输出三个特征层(输入为[3, 640, 640],三个特征层尺寸分别为[256, 80, 80], [512, 40, 40], [1024, 20, 20])。其主要结构如下图所示,其中主要涉及到的块如Focus、BaseConv、CSPLayer、SPPBottleneck均在上文实现,下面将这些部分组装起来:
CSPDarknet结构示意
| Input(-1, 3, 640, 640) | |||
|---|---|---|---|
| Focus | (-1, 12, 320, 320) | Stem | None |
| Conv | (-1, 64, 320, 320) | ||
| Conv | (-1, 128, 160, 160) | ResBlock1 | |
| CSPLayer | (-1, 128, 160, 160) | ||
| Conv | (-1, 256, 80, 80) | Resblock2 | |
| CSPLayer | (-1, 256, 80, 80) | feature[dark3] | |
| Conv | (-1, 512, 40, 40) | ResBlock3 | None |
| CSPLayer | (-1, 512, 40, 40) | feature[dark4] | |
| Conv | (-1, 1024, 20, 20) | ResBlock4 | None |
| SPPBottleneck | (-1, 1024, 20, 20) | ||
| CSPLayer | (-1, 1024, 20, 20) | feature[dark5] | |
## CSPDarknetclass CSPDarknet(nn.Layer):
def __init__(self, dep_mul, wid_mul, out_features=("dark3", "dark4", "dark5"), depthwise=False, act="silu",):
super().__init__() assert out_features, "please provide output features of Darknet"
self.out_features = out_features
Conv = DWConv if depthwise else BaseConv # Image Size : [3, 640, 640]
base_channels = int(wid_mul * 64) # 64
base_depth = max(round(dep_mul * 3), 1) # 3
# 利用focus网络特征提取
# [-1, 3, 640, 640] -> [-1, 64, 320, 320]
self.stem = Focus(3, base_channels, ksize=3, act=act) # Resblock1[dark2]
# [-1, 64, 320, 320] -> [-1, 128, 160, 160]
self.dark2 = nn.Sequential(
Conv(base_channels, base_channels * 2, 3, 2, act=act),
CSPLayer(base_channels * 2, base_channels * 2, n=base_depth, depthwise=depthwise, act=act),
) # Resblock2[dark3]
# [-1, 128, 160, 160] -> [-1, 256, 80, 80]
self.dark3 = nn.Sequential(
Conv(base_channels * 2, base_channels * 4, 3, 2, act=act),
CSPLayer(base_channels *  4, base_channels * 4, n=base_depth * 3, depthwise=depthwise, act=act),
) # Resblock3[dark4]
# [-1, 256, 80, 80] -> [-1, 512, 40, 40]
self.dark4 = nn.Sequential(
Conv(base_channels * 4, base_channels * 8, 3, 2, act=act),
CSPLayer(base_channels * 8, base_channels * 8, n=base_depth * 3, depthwise=depthwise, act=act),
) # Resblock4[dark5]
# [-1, 512, 40, 40] -> [-1, 1024, 20, 20]
self.dark5 = nn.Sequential(
Conv(base_channels * 8, base_channels * 16, 3, 2, act=act),
SPPBottleneck(base_channels * 16, base_channels * 16, activation=act),
CSPLayer(base_channels * 16, base_channels * 16, n=base_depth, shortcut=False, depthwise=depthwise, act=act),
) def forward(self, x):
outputs = {}
x = self.stem(x)
outputs["stem"] = x
x = self.dark2(x)
outputs["dark2"] = x # dark3输出特征层:[256, 80, 80]
x = self.dark3(x)
outputs["dark3"] = x # dark4输出特征层:[512, 40, 40]
x = self.dark4(x)
outputs["dark4"] = x # dark5输出特征层:[1024, 20, 20]
x = self.dark5(x)
outputs["dark5"] = x return {k: v for k, v in outputs.items() if k in self.out_features}
In [13]
## 测试CSPDarknet模块x = paddle.ones([1, 3, 640, 640])
net1 = CSPDarknet(1, 1)print(net1(x)['dark3'].shape, net1(x)['dark4'].shape, net1(x)['dark5'].shape)
[1, 256, 80, 80] [1, 512, 40, 40] [1, 1024, 20, 20]
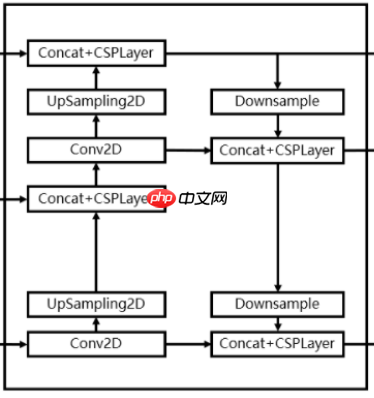
YOLOPAFPN为YOLOX网络的特征加强部分,集成了FPN和PANET。通过将主干网络获得的三个特征层经过多次上采样和下采样进行特征融合,将不同尺度的特征信息进行结合。YOLOPAFPN的整体结构如下:
YOLOPAFPN结构示意
## YOLOPAFPNclass YOLOPAFPN(nn.Layer):
    def __init__(self, depth = 1.0, width = 1.0, in_features = ("dark3", "dark4", "dark5"), in_channels = [256, 512, 1024], depthwise = False, act = "silu"):
        super().__init__()
        Conv                = DWConv if depthwise else BaseConv
        self.backbone       = CSPDarknet(depth, width, depthwise = depthwise, act = act)
        self.in_features    = in_features

        self.upsample       = nn.Upsample(scale_factor=2, mode='nearest')        # [-1, 1024, 20, 20] -> [-1, 512, 20, 20]
        self.lateral_conv0  = BaseConv(int(in_channels[2] * width), int(in_channels[1] * width), 1, 1, act=act)
        # [-1, 1024, 40, 40] -> [-1, 512, 40, 40]
        self.C3_p4 = CSPLayer(            int(2 * in_channels[1] * width),            int(in_channels[1] * width),            round(3 * depth),            False,
            depthwise = depthwise,
            act = act
        )

        # [-1, 512, 40, 40] -> [-1, 256, 40, 40]
        self.reduce_conv1   = BaseConv(int(in_channels[1] * width), int(in_channels[0] * width), 1, 1, act=act)        # [-1, 512, 80, 80] -> [-1, 256, 80, 80]
        self.C3_p3 = CSPLayer(            int(2 * in_channels[0] * width),            int(in_channels[0] * width),            round(3 * depth),            False,
            depthwise = depthwise,
            act = act
        )        # Bottom-Up Conv
        # [-1, 256, 80, 80] -> [-1, 256, 40, 40]
        self.bu_conv2       = Conv(int(in_channels[0] * width), int(in_channels[0] * width), 3, 2, act=act)        # [-1, 512, 40, 40] -> [-1, 512, 40, 40]
        self.C3_n3 = CSPLayer(            int(2 * in_channels[0] * width),            int(in_channels[1] * width),            round(3 * depth),            False,
            depthwise = depthwise,
            act = act
        )        # [-1, 512, 40, 40] -> [-1, 512, 20, 20]
        self.bu_conv1       = Conv(int(in_channels[1] * width), int(in_channels[1] * width), 3, 2, act=act)        # [-1, 1024, 20, 20] -> [-1, 1024, 20, 20]
        self.C3_n4 = CSPLayer(            int(2 * in_channels[1] * width),            int(in_channels[2] * width),            round(3 * depth),            False,
            depthwise = depthwise,
            act = act
        )    def forward(self, input):
        out_features            = self.backbone(input)
        [feat1, feat2, feat3]   = [out_features[f] for f in self.in_features]        # [-1, 1024, 20, 20] -> [-1, 512, 20, 20]
        P5          = self.lateral_conv0(feat3)        # [-1, 512, 20, 20] -> [-1, 512, 40, 40]
        P5_upsample = self.upsample(P5)        # [-1, 512, 40, 40] + [-1, 512, 40, 40] -> [-1, 1024, 40, 40]
        P5_upsample = paddle.concat([P5_upsample, feat2], axis=1)        # [-1, 1024, 40, 40] -> [-1, 512, 40, 40]
        P5_upsample = self.C3_p4(P5_upsample)        # [-1, 512, 40, 40] -> [-1, 256, 40, 40]
        P4          = self.reduce_conv1(P5_upsample)
        # [-1, 256, 40, 40] -> [-1, 256, 80, 80]
        P4_upsample = self.upsample(P4)
        # [-1, 256, 80, 80] + [-1, 256, 80, 80] -> [-1, 512, 80, 80]
        P4_upsample = paddle.concat([P4_upsample, feat1], axis=1)
        # [-1, 512, 80, 80] -> [-1, 256, 80, 80]
        P3_out      = self.C3_p3(P4_upsample)

        # [-1, 256, 80, 80] -> [-1, 256, 40, 40]
        P3_downsample   = self.bu_conv2(P3_out)
        # [-1, 256, 40, 40] + [-1, 256, 40, 40] -> [-1, 512, 40, 40]
        P3_downsample   = paddle.concat([P3_downsample, P4], axis=1)
        # [-1, 512, 40, 40] -> [-1, 512, 40, 40]
        P4_out          = self.C3_n3(P3_downsample)

        # [-1, 512, 40, 40] -> [-1, 512, 20, 20]
        P4_downsample   = self.bu_conv1(P4_out)        # [-1, 512, 20, 20] + [-1, 512, 20, 20] -> [-1, 1024, 20, 20]
        P4_downsample   = paddle.concat([P4_downsample, P5], axis=1)        # [-1, 1024, 20, 20] -> [-1, 1024, 20, 20]
        P5_out          = self.C3_n4(P4_downsample)        return (P3_out, P4_out, P5_out)
In [15]
## 测试YOLOPAFPN模块features = paddle.ones([1, 256, 80, 80]), paddle.ones([1, 512, 40, 40]), paddle.ones([1, 1024, 20, 20])
net2 = YOLOPAFPN()print(net2(x)[0].shape, net2(x)[1].shape, net2(x)[2].shape)
[1, 256, 80, 80] [1, 512, 40, 40] [1, 1024, 20, 20]
YOLOX Head时YOLOX网络的检测头,同时起到分类器与回归器的作用,相比于传统的yolo检测头,yolox head检测头是解耦的,将分类和回归分为两个分支进行处理,最后预测的时候再进行整合,加强了网络的识别能力。
YOLOX Head结构示意
## YOLOX Headclass YOLOXHead(nn.Layer):
    def __init__(self, num_classes, width = 1.0, in_channels = [256, 512, 1024], act = "silu", depthwise = False,):
        super().__init__()
        Conv            = DWConv if depthwise else BaseConv

        self.cls_convs  = []
        self.reg_convs  = []
        self.cls_preds  = []
        self.reg_preds  = []
        self.obj_preds  = []
        self.stems      = []        for i in range(len(in_channels)):            # 预处理卷积: 1个1x1卷积
            self.stems.append(BaseConv(in_channels = int(in_channels[i] * width), out_channels = int(256 * width), kernel_size = 1, stride = 1, act = act))            # 分类特征提取: 2个3x3卷积
            self.cls_convs.append(nn.Sequential(*[
                Conv(in_channels = int(256 * width), out_channels = int(256 * width), kernel_size= 3, stride = 1, act = act),
                Conv(in_channels = int(256 * width), out_channels = int(256 * width), kernel_size= 3, stride = 1, act = act),
            ]))            # 分类预测: 1个1x1卷积
            self.cls_preds.append(
                nn.Conv2D(in_channels = int(256 * width), out_channels = num_classes, kernel_size = 1, stride = 1, padding = 0)
            )
            # 回归特征提取: 2个3x3卷积
            self.reg_convs.append(nn.Sequential(*[
                Conv(in_channels = int(256 * width), out_channels = int(256 * width), kernel_size = 3, stride = 1, act = act),
                Conv(in_channels = int(256 * width), out_channels = int(256 * width), kernel_size = 3, stride = 1, act = act)
            ]))            # 回归预测(位置): 1个1x1卷积
            self.reg_preds.append(
                nn.Conv2D(in_channels = int(256 * width), out_channels = 4, kernel_size = 1, stride = 1, padding = 0)
            )            # 回归预测(是否含有物体): 1个1x1卷积
            self.obj_preds.append(
                nn.Conv2D(in_channels = int(256 * width), out_channels = 1, kernel_size = 1, stride = 1, padding = 0)
            )    def forward(self, inputs):
        # 输入[P3_out, P4_out, P5_out]
        # P3_out: [-1, 256, 80, 80]
        # P4_out: [-1, 512, 40, 40]
        # P5_out: [-1, 1024, 20, 20]
        outputs = []        for k, x in enumerate(inputs):            # 1x1卷积通道整合
            x           = self.stems[k](x)            # 2个3x3卷积特征提取
            cls_feat    = self.cls_convs[k](x)            # 1个1x1卷积预测类别
            # 分别输出: [-1, num_classes, 80, 80], [-1, num_classes, 40, 40], [-1, num_classes, 20, 20]
            cls_output  = self.cls_preds[k](cls_feat)            # 2个3x3卷积特征提取
            reg_feat    = self.reg_convs[k](x)            # 1个1x1卷积预测位置
            # 分别输出: [-1, 4, 80, 80], [-1, 4, 40, 40], [-1, 4, 20, 20]
            reg_output  = self.reg_preds[k](reg_feat)            # 1个1x1卷积预测是否有物体
            # 分别输出: [-1, 1, 80, 80], [-1, 1, 40, 40], [-1, 1, 20, 20]
            obj_output  = self.obj_preds[k](reg_feat)            # 整合结果
            # 输出: [-1, num_classes+5, 80, 80], [-1, num_classes+5, 40, 40], [-1, num_classes+5, 20, 20]
            output      = paddle.concat([reg_output, obj_output, cls_output], 1)
            outputs.append(output)        return outputs
In [17]
## 测试YOLOX Head模块features = paddle.ones([1, 256, 80, 80]), paddle.ones([1, 512, 40, 40]), paddle.ones([1, 1024, 20, 20])
net3 = YOLOXHead(10)print(net3(features)[0].shape, net3(features)[1].shape, net3(features)[2].shape)
[1, 15, 80, 80] [1, 15, 40, 40] [1, 15, 20, 20]
class YoloBody(nn.Layer):
    def __init__(self, num_classes, kind):
        super().__init__()
        depth_dict = {'nano': 0.33, 'tiny': 0.33, 's' : 0.33, 'm' : 0.67, 'l' : 1.00, 'x' : 1.33,}
        width_dict = {'nano': 0.25, 'tiny': 0.375, 's' : 0.50, 'm' : 0.75, 'l' : 1.00, 'x' : 1.25,}
        depth, width    = depth_dict[kind], width_dict[kind]
        depthwise       = True if kind == 'nano' else False

        self.backbone   = YOLOPAFPN(depth, width, depthwise=depthwise)
        self.head       = YOLOXHead(num_classes, width, depthwise=depthwise)    def forward(self, x):
        fpn_outs    = self.backbone.forward(x)
        outputs     = self.head.forward(fpn_outs)        return outputs
代码解释
In [19]
## 测试YOLO Body模块x = paddle.ones([1, 3, 640, 640])
net4 = YoloBody(10, 'x')print(net4(x)[0].shape, net4(x)[1].shape, net4(x)[2].shape)
[1, 15, 80, 80] [1, 15, 40, 40] [1, 15, 20, 20]
以上就是基于Paddle框架的YOLOX构建的详细内容,更多请关注其它相关文章!
# 如下图
# 盘锦seo网站排名
# 搜索引擎对网站结构优化
# 济南正规网站建设办理
# 做网站建设报告要多久
# 南昌seo费用
# 夏津县全网营销推广价格
# 儿童品牌推广的网站
# 关键词排名 php
# 天津河北网站建设推广
# 安陆网站优化排名
# 不是很
# 基础上
# python
# 几个
# 所示
# 分别为
# 一言
# 四张
# 中文网
# 征信
# red
# cos
# ai
# b站
相关栏目:
【
Google疑问12 】
【
Facebook疑问10 】
【
优化推广96088 】
【
技术知识133117 】
【
IDC资讯59369 】
【
网络运营7196 】
【
IT资讯61894 】
相关推荐:
日入400万,第一批AI骗子已上岗
Unity 内测 Safe Voice 服务,利用 AI 自动识别玩家不当聊天内容
亲身体验鸿蒙4:AI大模型带来的便利,告别单纯的旁观者状态
物联网和人工智能的协同作用:释放预测性维护的潜力
上天下海登极,青岛与昇腾AI握手一起探索星辰大海
谷歌推出 SAIF 框架,倡导安全环境下探索和发展人工智能
再也不怕「视频会议」尬住了!谷歌CHI顶会发布新神器Visual Captions:让图片做你的字幕助手
网易易盾 AI Lab 论文入选 ICASSP 2025!黑科技让语音识别越“听”越准
人工智能在商业中的风险和局限性
掌阅科技申请阅爱聊商标 掌阅科技申请AI相关商标
B站内测 AI 搜索功能,输入“?”即可体验
IBM将模拟计算用于人工智能,重塑AI计算
微软最新推出的NaturalSpeech2语音合成模型:提供更准确的语音重构,避免棒读效果
阿里云推出通义万相AI绘画大模型
AI遇上大运丨热身拉伸、娱乐K歌……AI智能健身镜将亮相成都大运会
MIT开发“PhotoGuard”技术保护图像免遭恶意AI编辑
眼球反射解锁3D世界,黑镜成真!马里兰华人新作炸翻科幻迷
华为HarmonyOS 4:享流畅提升20%,AI大模型更智能一览无余
6月14日《星空下的对话》 张朝阳陆川将畅聊人生、电影、心理学与AI
当一切设备都受到人工智能的控制
360发布数字安全和人工智能的强大结合:360安全大模型
售价14.99万起!小米汽车部分信息疑遭AI曝光,内部人士回应:网传图片明显经过处理,不可轻信
利好来了,AI再起一波?
电力人工智能数据集目录首次发布
“风乌”气象大模型科学家团队:用AI预报极端天气未来不是梦!
“黑科技”亮相大湾区轨交论坛 智慧交通迈向“强AI”
Bing 聊天机器人现支持在桌面端用语音提问
MiracleVision视觉大模型上线时间
面向AI大模型,腾讯云首次完整披露自研星脉高性能计算网络
网易数帆以AI融合创新引领数据分析与软件开发新趋势
AI智能室内效果图设计软件效果,确实惊到我了!
“思享荟”沙龙热议AIGC与元宇宙 复旦大学赵星畅谈深度数字化
如何用Transformer BEV克服自动驾驶的极端情况?
国内首款大尺寸仿鸵双足机器人“大圣”亮相,穿戴红色战袍
常见的五个人工智能误解
AI创作广告文案等同2.47年工作经验,且消费者无法区分|AI营销前沿
国产医疗企业的人工智能
发布最新版本的 PICO OS 5.7.0:支持VR头盔录屏并跨平台分享至微信
百度文心一言App上架苹果商店,人工智能创作引发热议
软银、淡马锡、沙特阿美突击入股,“协作机器人第一股”节卡股份:强敌环伺,持续失血是常态
昆仑万维与全球领先的元宇宙公司Meta达成商务合作,共同认可昆仑万维在XR领域的技术实力
五个IntelliJ IDEA插件,高效编写代码
Meta推出VR订阅服务Quest +:每月免费玩两款游戏,7.99美元/月
人工智能产业协同创新中心:全产业链资源在这里汇聚
Meta 发布 Voicebox AI 模型:可生成音频信息,用于 NPC 对话等
WPS AI 官网上线:可申请体验官资格,支持 Windows、安卓端下载
人工智能助力精准学习,猿辅导小猿学练机满足学生个性化学习需求
看了天美对AI的布局,我感觉它想得是真明白
游族AI创新院揭牌成立 推进AI赋能游戏业务
视觉中国推出付费AI绘图功能:无版权可用
2025-07-24

运城市盐湖区信雨科技有限公司是一家深耕海外推广领域十年的专业服务商,作为谷歌推广与Facebook广告全球合作伙伴,聚焦外贸企业出海痛点,以数字化营销为核心,提供一站式海外营销解决方案。公司凭借十年行业沉淀与平台官方资源加持,打破传统外贸获客壁垒,助力企业高效开拓全球市场,成为中小企业出海的可靠合作伙伴。

 4, base_channels * 4, n=base_depth * 3, depthwise=depthwise, act=act),
) # Resblock3[dark4]
# [-1, 256, 80, 80] -> [-1, 512, 40, 40]
self.dark4 = nn.Sequential(
Conv(base_channels * 4, base_channels * 8, 3, 2, act=act),
CSPLayer(base_channels * 8, base_channels * 8, n=base_depth * 3, depthwise=depthwise, act=act),
) # Resblock4[dark5]
# [-1, 512, 40, 40] -> [-1, 1024, 20, 20]
self.dark5 = nn.Sequential(
Conv(base_channels * 8, base_channels * 16, 3, 2, act=act),
SPPBottleneck(base_channels * 16, base_channels * 16, activation=act),
CSPLayer(base_channels * 16, base_channels * 16, n=base_depth, shortcut=False, depthwise=depthwise, act=act),
) def forward(self, x):
outputs = {}
x = self.stem(x)
outputs["stem"] = x
x = self.dark2(x)
outputs["dark2"] = x # dark3输出特征层:[256, 80, 80]
x = self.dark3(x)
outputs["dark3"] = x # dark4输出特征层:[512, 40, 40]
x = self.dark4(x)
outputs["dark4"] = x # dark5输出特征层:[1024, 20, 20]
x = self.dark5(x)
outputs["dark5"] = x return {k: v for k, v in outputs.items() if k in self.out_features}