该项目针对公共场所吸烟问题,利用PaddleX训练吸烟检测模型,再通过EasyEdge部署到PC和手机APP。先从公开数据集获取按VOC格式标注的数据,经解压、处理清洗、划分后,用YOLOv3(MobileNetV3_large为backbone)训练,导出模型后上传至EasyEdge完成部署,实现吸烟行为的智能检测、警告与记录。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
公共场所进行吸烟检测,如果发现有吸烟行为,及时警告并记录。
吸烟有害健康。
为减少和消除烟草烟雾危害,保障公众健康,根据国务院立法工作计划,2013年卫生计生委启动了《公共场所控制吸烟条例》起草工作。按照立法程序的有关要求,在总结地方控烟工作经验的基础上,深入调研,广泛征求了工业和信息化部、烟草局等25个部门,各省级卫生计生行政部门、部分行业协会及有关专家的意见,经不断修改完善,形成了《公共场所控制吸烟条例(送审稿)》。送审稿明确,所有室内公共场所一律禁止吸烟。此外,体育、健身场馆的室外观众坐席、赛场区域;公共交通工具的室外等候区域等也全面禁止吸烟。
但,仍存在公共场合吸烟问题,为此一种无人化、智能化吸烟检测装置的需求迫在眉睫。
该项目使用PaddleX快速训练吸烟模型,然后通过EasyEdge端与边缘AI服务平台部署到电脑PC与手机APP上,实现飞桨框架深度学习模型的落地。
模型训练:PaddleX,YoloV3的backbone使用MobileNetV3_large
模型落地:EasyEdge端与边缘AI服务平台 使用文档
PC效果展示: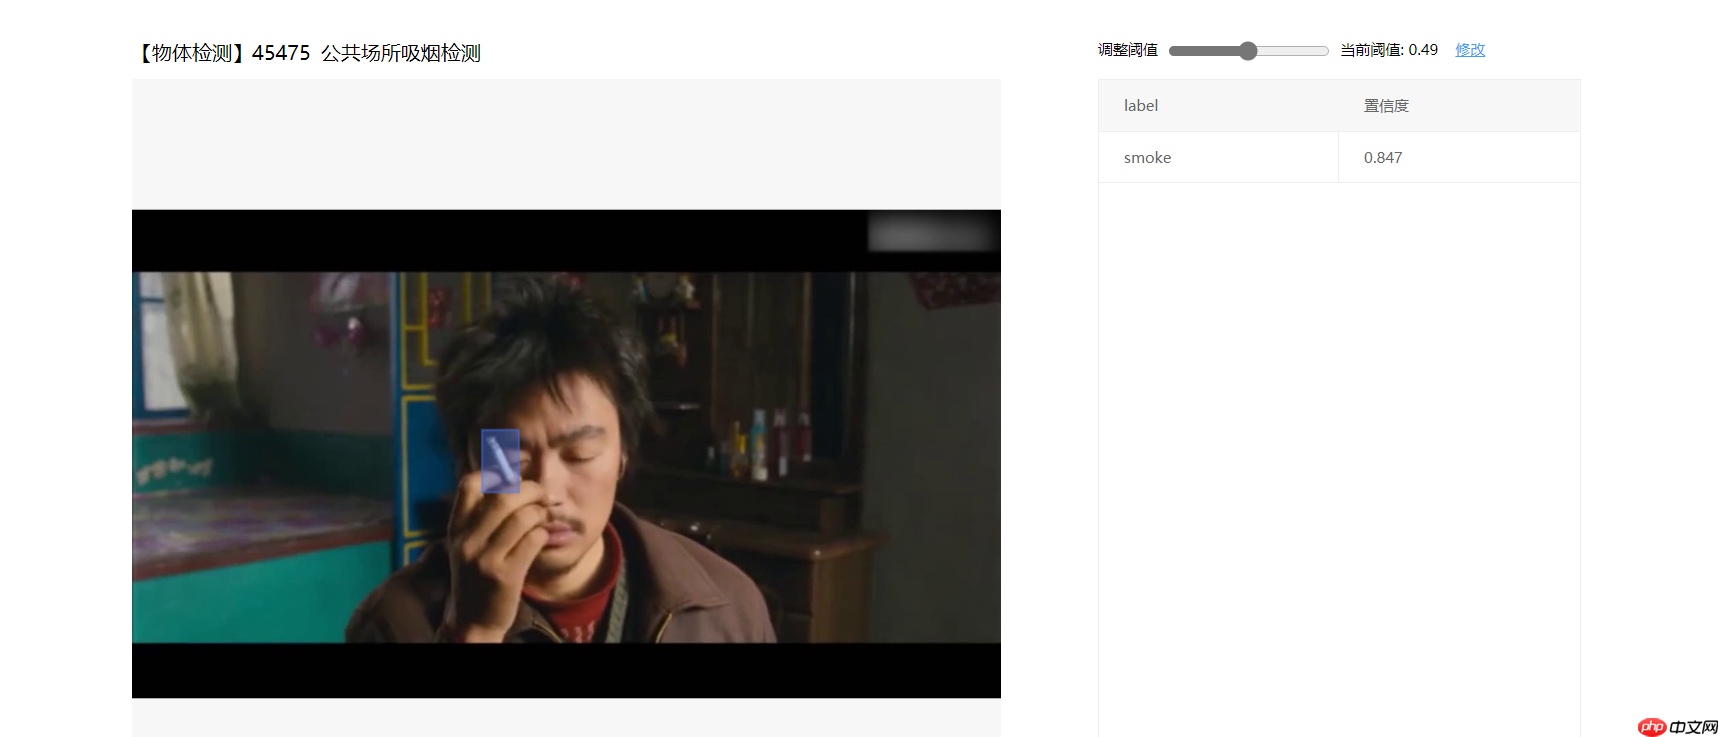
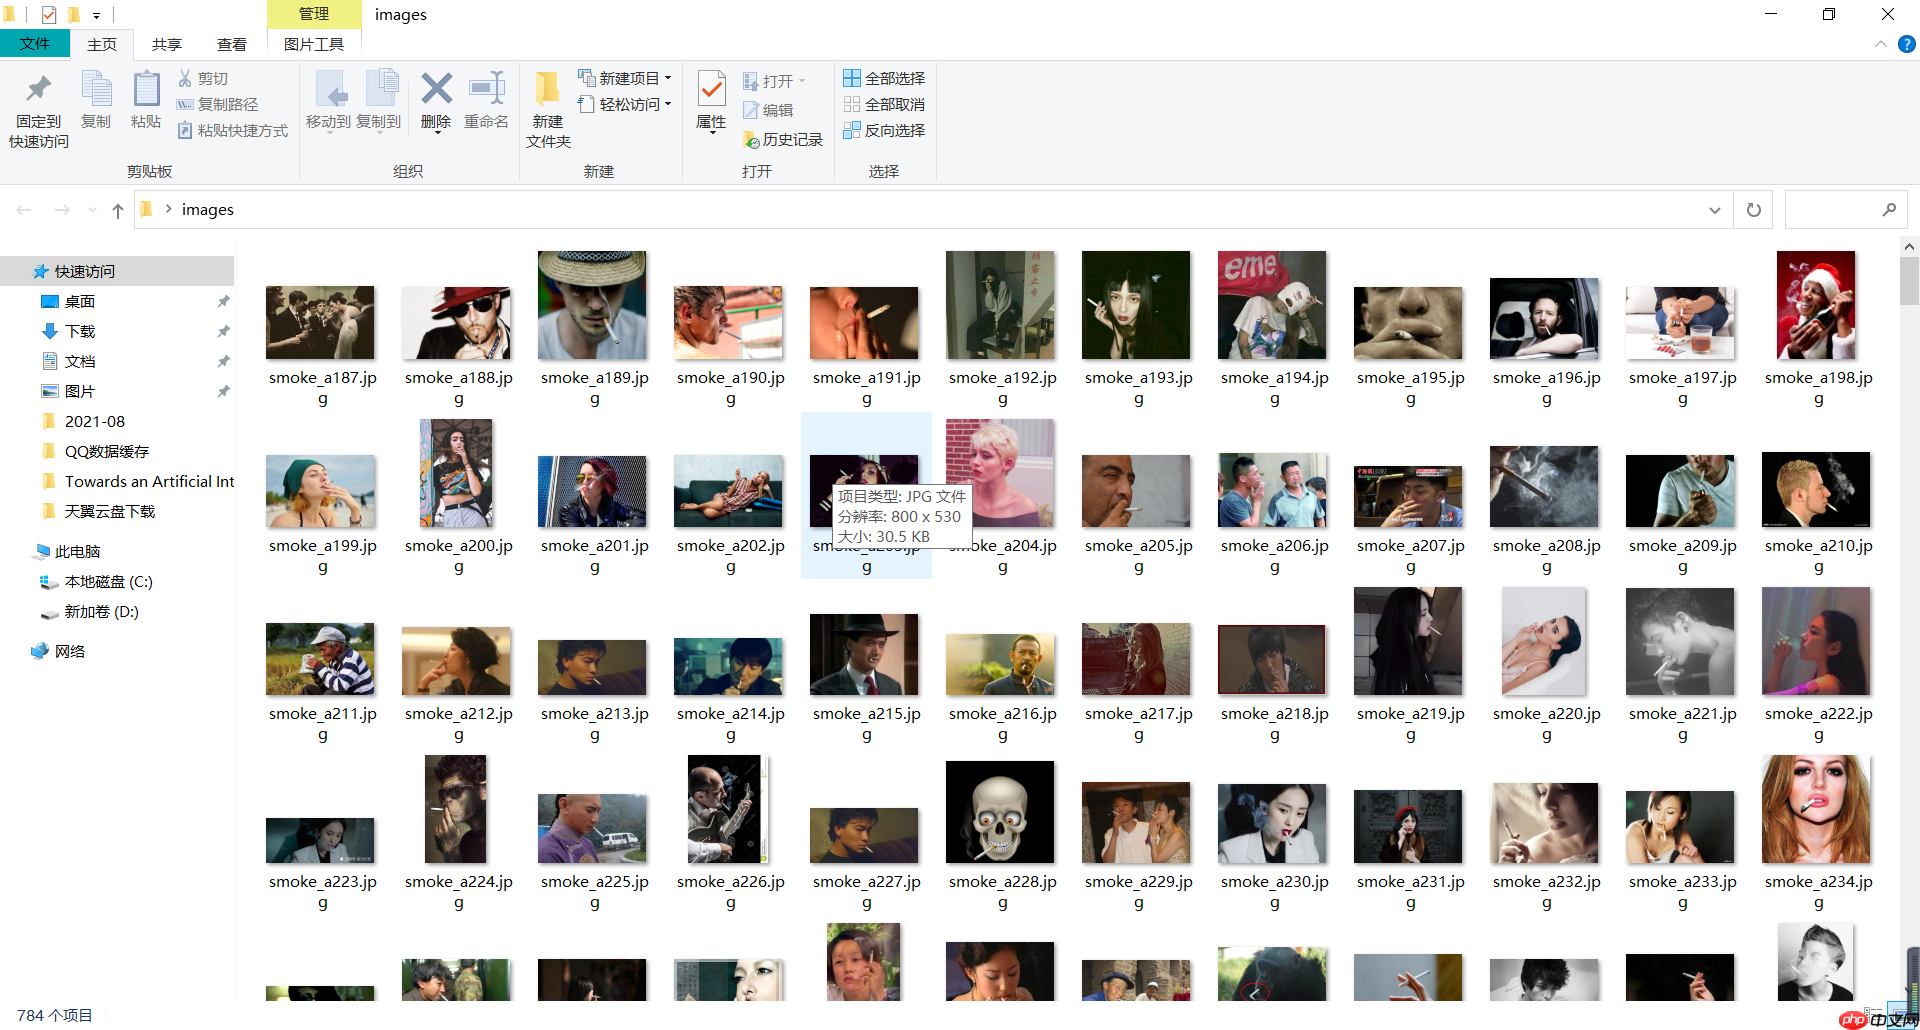
本次数据集从浆友公开数据集中获取。
具体链接为:https://aistudio.baidu.com/aistudio/datasetdetail/94796。
 简小派
简小派是一款AI原生求职工具,通过简历优化、岗位匹配、项目生成、模拟面试与智能投递,全链路提升求职成功率,帮助普通人更快拿到更好的 offer。
 123
查看详情

本项目为目标检测场景,所使用的吸烟检测数据集已经按VOC格式进行标注,目录情况如下:
 dataset/
 ├── annotations/
 ├── images/
PaddleX是飞桨提供的全流程开发工具。它集飞桨核心框架、模型库、工具及组件等深度学习开发所需全部能力于一身,将智能视觉领域的四大任务:图像分类、目标检测、语义分割、实例分割的数据读取、数据增强、超参配置、训练评估等进行模块化抽象,并全流程打通,并提供简明易懂的Python API,方便用户根据实际生产需求进行直接调用或二次开发。 Paddlex版本:PaddleX 1.3.11 项目环境:Paddle 2.1.0
PaddleX项目地址:https://github.com/PaddlePaddle/PaddleX
PaddleX文档链接:https://paddlex.readthedocs.io
PaddleX可视化模型训练客户端下载:https://www.paddlepaddle.org.cn/paddle/paddlex
!pip install paddlex==1.3.11!pip install paddle2onnx
# 进行数据集解压!unzip -oq /home/aistudio/data/data102810/pp_smoke.zip -d /home/aistudio/dataset
# 这里修改.xml文件中的<path>元素!mkdir dataset/Annotations1   #创建目录 Annotations1import xml.dom.minidomimport os

path = r'dataset/Annotations'  # xml文件存放路径sv_path = r'dataset/Annotations1'  # 修改后的xml文件存放路径files = os.listdir(path)
cnt = 1for xmlFile in files:
    dom = xml.dom.minidom.parse(os.path.join(path, xmlFile))  # 打开xml文件,送到dom解析
    root = dom.documentElement  # 得到文档元素对象
    item = root.getElementsByTagName('path')  # 获取path这一node名字及相关属性值
    for i in item:
        i.firstChild.data = '/home/aistudio/dataset/JPEGImages/' + str(cnt).zfill(6) + '.jpg'  # xml文件对应的图片路径

    with open(os.path.join(sv_path, xmlFile), 'w') as fh:
        dom.writexml(fh)
    cnt += 1
In [ ]
# 这里修改.xml文件中的<failname>元素!mkdir dataset/Annotations2  #创建目录 Annotations2import xml.dom.minidomimport os

path = r'dataset/Annotations1'  # xml文件存放路径sv_path = r'dataset/Annotations2'  # 修改后的xml文件存放路径files = os.listdir(path)for xmlFile in files:
    dom = xml.dom.minidom.parse(os.path.join(path, xmlFile))  # 打开xml文件,送到dom解析
    root = dom.documentElement  # 得到文档元素对象
    names = root.getElementsByTagName('filename')
    a, b = os.path.splitext(xmlFile)  # 分离出文件名a
    for n in names:
        n.firstChild.data = a + '.jpg'
    with open(os.path.join(sv_path, xmlFile), 'w') as fh:
        dom.writexml(fh)
In [ ]
# 这里修改.xml文件中的<name>元素!mkdir dataset/Annotations3  #创建目录 Annotations3#!/usr/bin/env python2# -*- coding: utf-8 -*-
 import osimport xml.etree.ElementTree as ET

origin_ann_dir = '/home/aistudio/dataset/Annotations2/'# 设置原始标签路径为 Annosnew_ann_dir = '/home/aistudio/dataset/Annotations3/'# 设置新标签路径 Annotationsfor dirpaths, dirnames, filenames in os.walk(origin_ann_dir):   # os.walk游走遍历目录名
  for filename in filenames:    # if os.path.isfile(r'%s%s' %(origin_ann_dir, filename)):   # 获取原始xml文件绝对路径,isfile()检测是否为文件 isdir检测是否为目录
    origin_ann_path = os.path.join(origin_ann_dir, filename)   # 如果是,获取绝对路径(重复代码)
    new_ann_path = os.path.join(new_ann_dir, filename)
    tree = ET.parse(origin_ann_path)  # ET是一个xml文件解析库,ET.parse()打开xml文件。parse--"解析"
    root = tree.getroot()   # 获取根节点
    for object in root.findall('object'):   # 找到根节点下所有“object”节点
        name = str(object.find('name').text)  # 找到object节点下name子节点的值(字符串)
        # 如果name等于str,则删除该节点
        if (name in ["smoke"]):        #   root.remove(object)
            pass

        # 如果name等于str,则修改name
        else:            object.find('name').text = "smoke"

        tree.write(new_ann_path)#tree为文件,write写入新的文件中。
In [ ]
#删除冗余文件并修改文件夹名字!rm -rf dataset/Annotations
!rm -rf dataset/Annotations1
!rm -rf dataset/Annotations2
!mv dataset/Annotations3 dataset/Annotations
!mv dataset/images dataset/JPEGImages
In [ ]
#在原始数据集中,存在.jpg文件和.xml文件匹配不对等的情况,这里我们根据.jpg文件名删除了在Annotations文件夹中无法匹配的.xml文件,#使得.jpg和.xml能够一一对应。import osimport shutil
path_annotations = 'dataset/Annotations'path_JPEGImage = 'dataset/JPEGImages'xml_path = os.listdir(path_annotations)
jpg_path = os.listdir(path_JPEGImage)for i in jpg_path:
    a = i.split('.')[0] + '.xml'
    if a in xml_path:        pass
    else:        print(i)
        os.remove(os.path.join(path_JPEGImage,i))
In [ ]
#划分数据集#基于PaddleX 自带的划分数据集的命令,数据集中训练集、验证集、测试集的比例为7:2:1(最常用的户划分方式)。!paddlex --split_dataset --format VOC --dataset_dir /home/aistudio/dataset/ --val_value 0.2 --test_value 0.1
#配置GPU环境import os
os.environ['CUDA_VISIBLE_DEVICES'] = "0"from paddlex.det import transformsimport paddlex as pdxfrom paddlex.det import transforms# 数据增强与数据预处理# API说明https://gitee.com/paddlepaddle/PaddleX/blob/develop/docs/apis/transforms/det_transforms.mdtrain_transforms = transforms.Compose([
transforms.RandomHorizontalFlip(),
transforms.Normalize(),
transforms.ResizeByShort(short_size=512, max_size=512),
transforms.Padding(coarsest_stride=32)
])
eval_transforms = transforms.Compose([
transforms.Normalize(),
transforms.ResizeByShort(short_size=512, max_size=512),
transforms.Padding(coarsest_stride=32),
])# 定义训练和验证时的transforms# API说明 https://paddlex.readthedocs.io/zh_CN/develop/apis/transforms/det_transforms.htmltrain_transforms = transforms.Compose([
transforms.MixupImage(mixup_epoch=350), transforms.RandomDistort(),
transforms.RandomExpand(), transforms.RandomCrop(), transforms.Resize(
target_size=608, interp='RANDOM'), transforms.RandomHorizontalFlip(),
transforms.Normalize()
])
eval_transforms = transforms.Compose([
transforms.Resize(
target_size=608, interp='CUBIC'), transforms.Normalize()
])# 定义训练和验证所用的数据集# API说明:https://paddlex.readthedocs.io/zh_CN/develop/apis/datasets.html#paddlex-datasets-vocdetectiontrain_dataset = pdx.datasets.VOCDetection(
data_dir='/home/aistudio/dataset',
file_list='/home/aistudio/dataset/train_list.txt',
label_list='/home/aistudio/dataset/labels.txt',
transforms=train_transforms,
parallel_method='thread',
shuffle=True)
eval_dataset = pdx.datasets.VOCDetection(
data_dir='/home/aistudio/dataset',
file_list='/home/aistudio/dataset/val_list.txt',
label_list='/home/aistudio/dataset/labels.txt',
parallel_method='thread',
transforms=eval_transforms)# 初始化模型,并进行训练# 可使用VisualDL查看训练指标,参考https://paddlex.readthedocs.io/zh_CN/develop/train/visualdl.htmlnum_classes = len(train_dataset.labels)# API说明: https://paddlex.readthedocs.io/zh_CN/release-1.3/apis/models/detection.html#paddlex-det-yolov3# 这里采用了yolov3移动版,用于后续部署APP,可以对应开发文档选用自己何时模型,从精度、速度、大小考虑。model = pdx.det.YOLOv3(num_classes=num_classes, backbone='MobileNetV3_large')# API说明: https://paddlex.readthedocs.io/zh_CN/develop/apis/models/detection.html#train# 各参数介绍与调整说明:https://paddlex.readthedocs.io/zh_CN/develop/appendix/parameters.htmlmodel.train(
num_epochs=300,
train_dataset=train_dataset,
train_batch_size =24, # 跟随老师讲说,这里基本把显存拉到了30GB 留有2GB余量
eval_dataset=eval_dataset,
learning_rate=0.001 / 8,
warmup_steps=1000,
warmup_start_lr=0.0,
s*e_interval_epochs=1,
lr_decay_epochs=[240, 270],
use_vdl= True,
s*e_dir='output/yolov3_mobilenet')
In [8]
#可视化 !visualdl --logdir home/aistudio/output/yolov3_mobilenet/vdl_log --port 8001
model.evaluate(eval_dataset, batch_size=1, epoch_id=None, return_details=False)
#把模型导出,下载本地,然后上传到EasyEdge!paddlex --export_inference --model_dir=/home/aistudio/output/yolov3_mobilenet/best_model --s*e_dir=./down_model
EasyEdge是基于百度飞桨轻量化推理框架Paddle Lite研发的端与边缘AI服务平台,能够帮助深度学习开发者将自建模型快速部署到设备端。只需上传模型,最快2分种即可获得适配终端硬件/芯片的模型。
#只需要把导出的模型分别对应上传到EasyEdge,labels.txt这个文件就是之前数据集里面的标签文件
【第一步】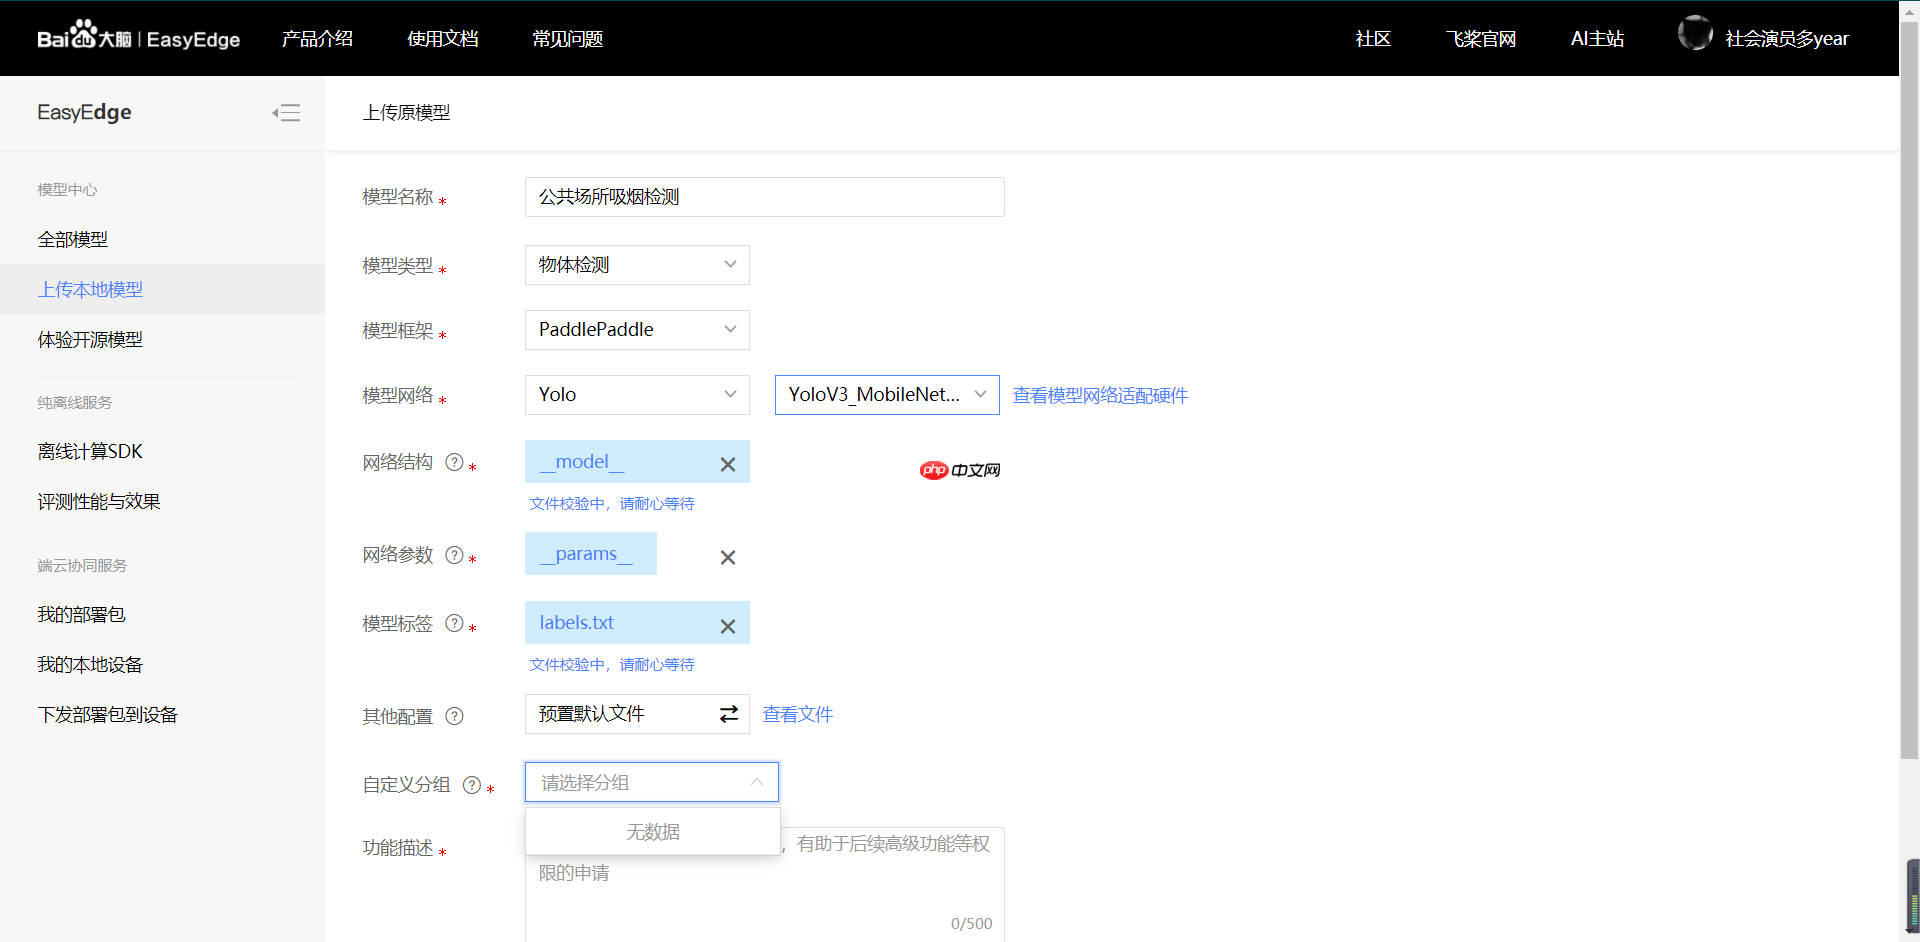
【第二步】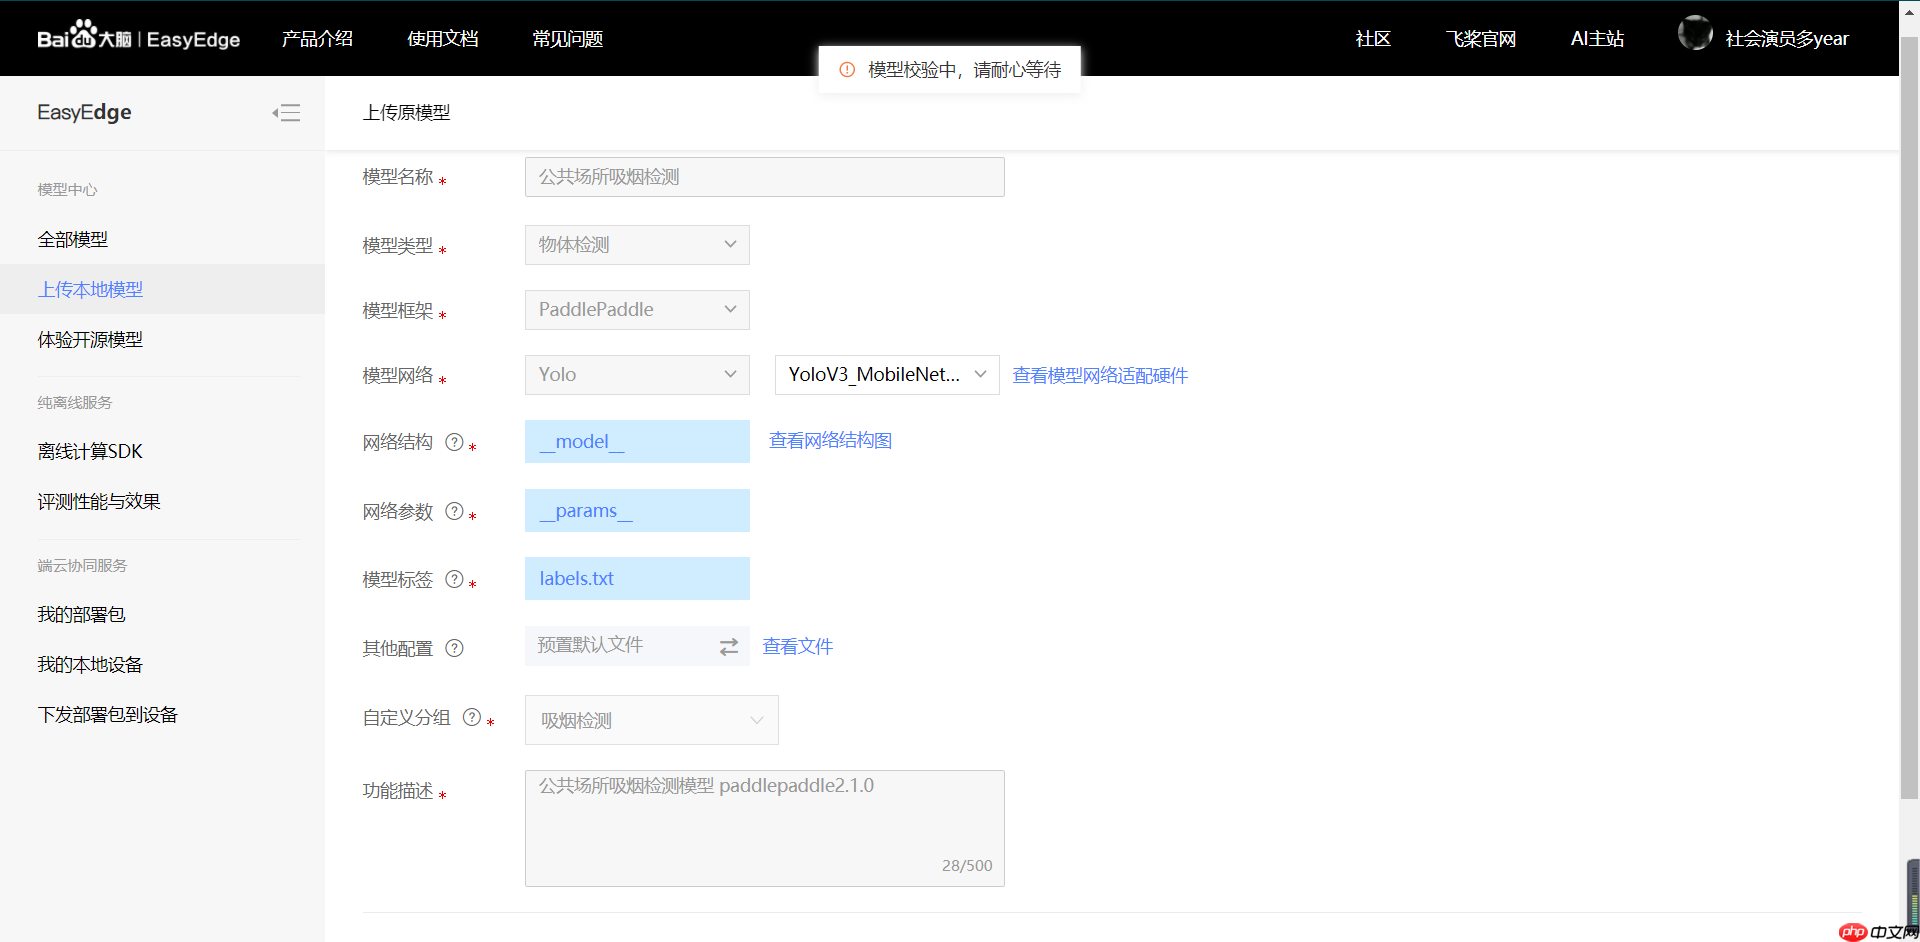
【第三步】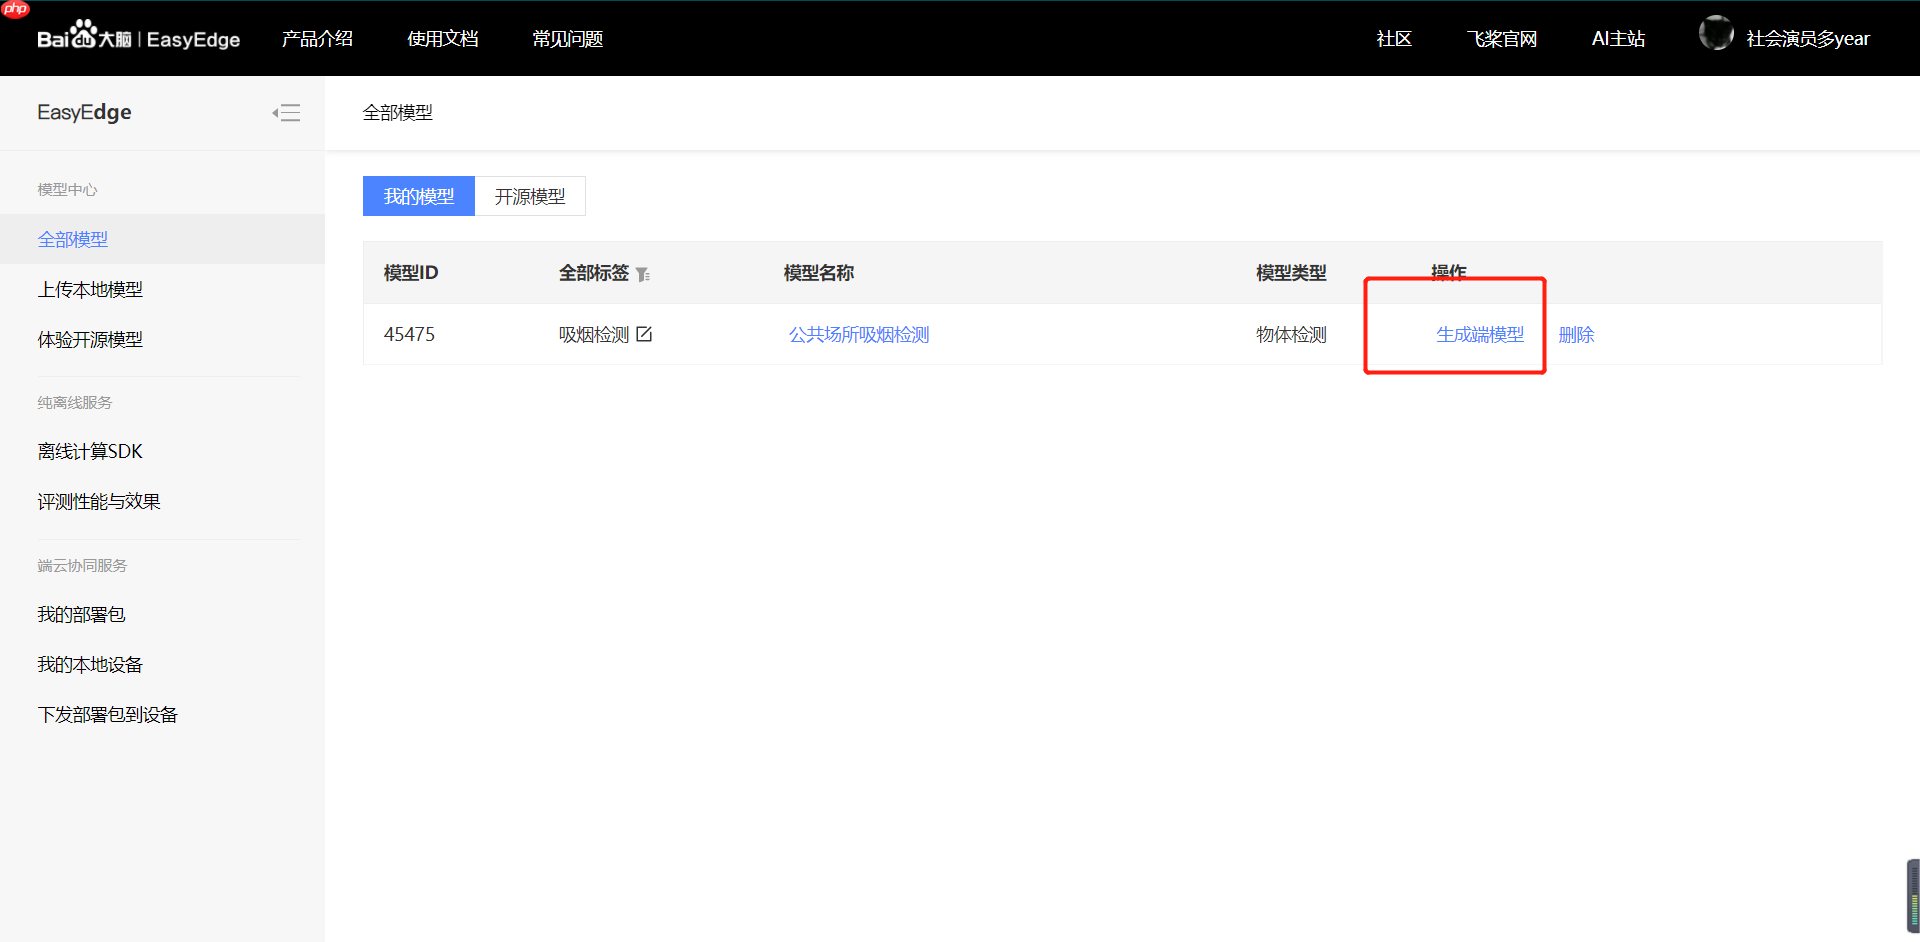
【第四步】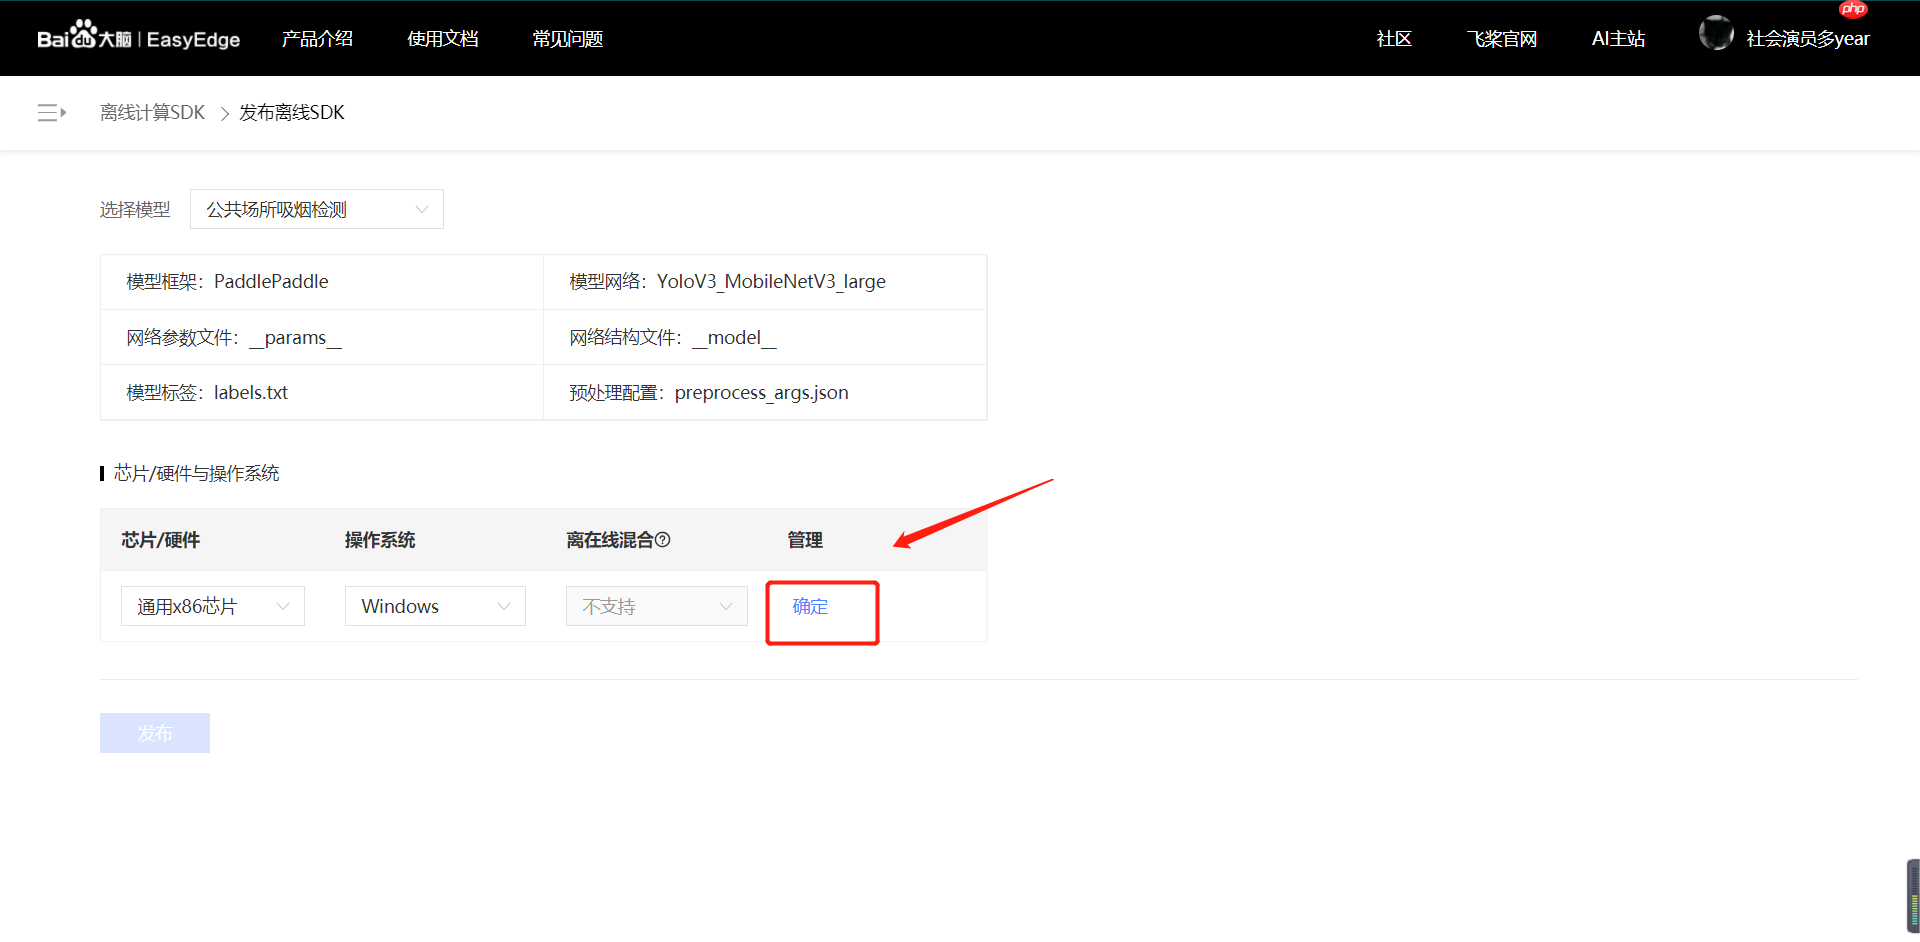
【第五步】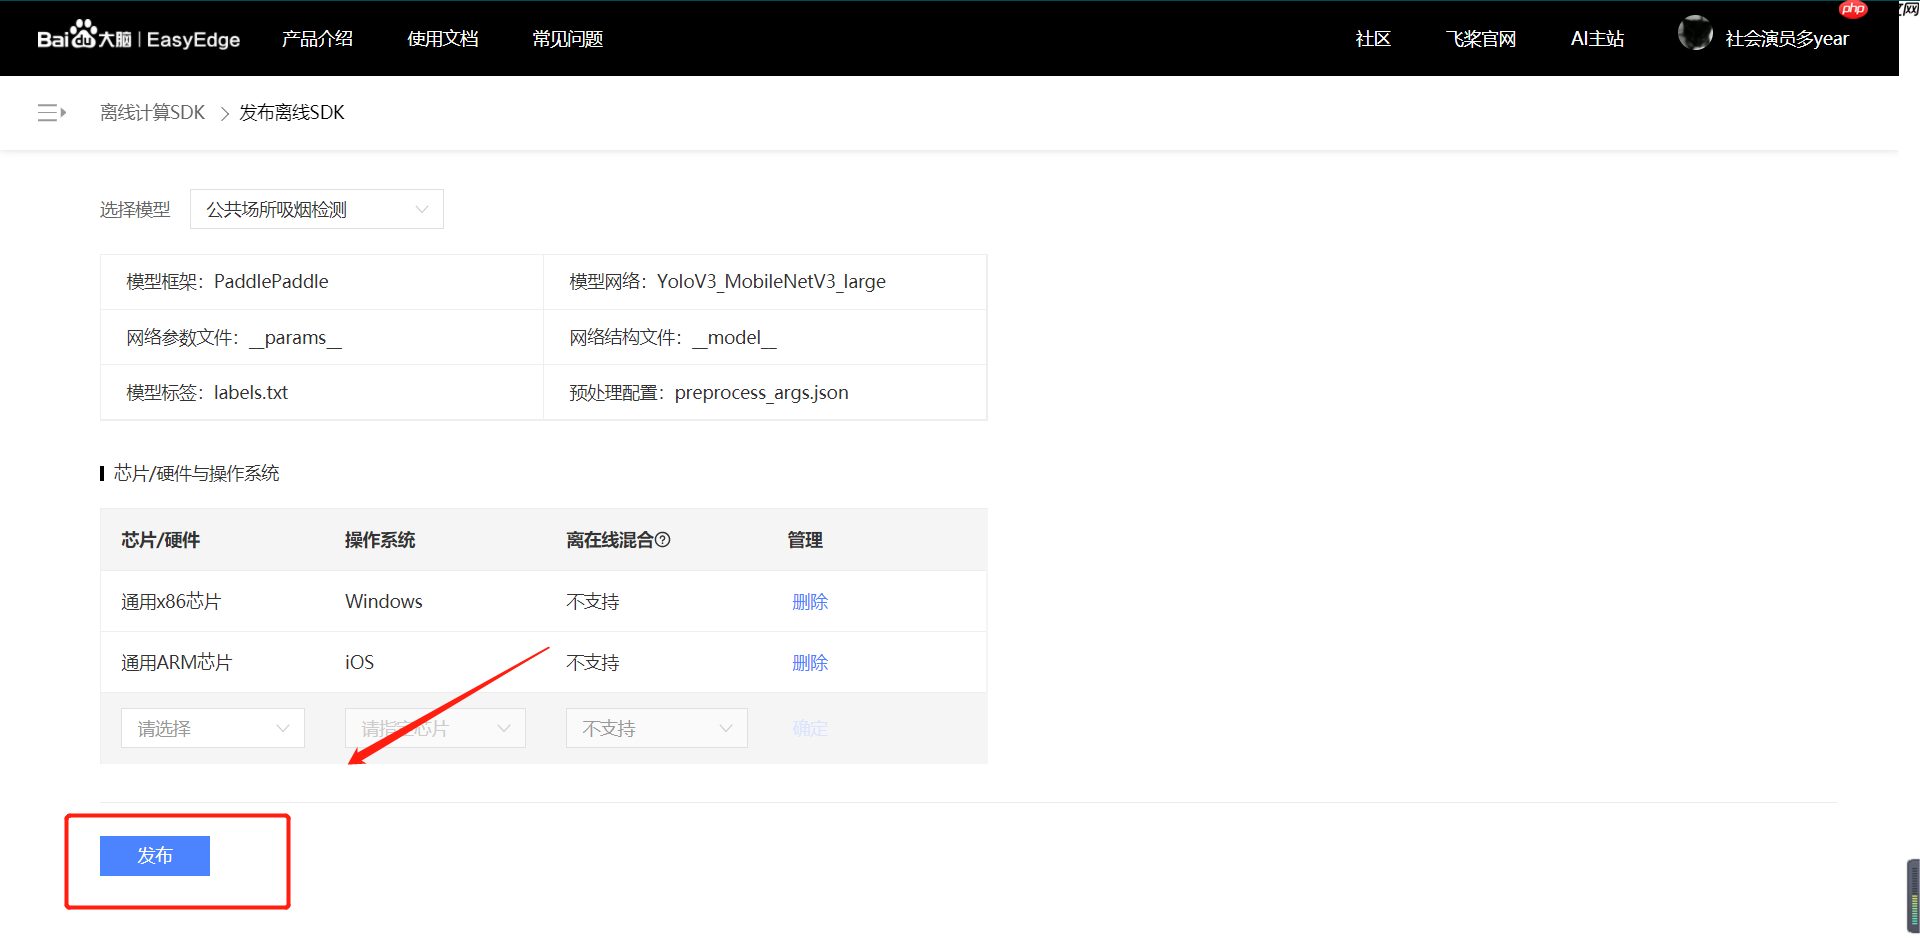
【第六步】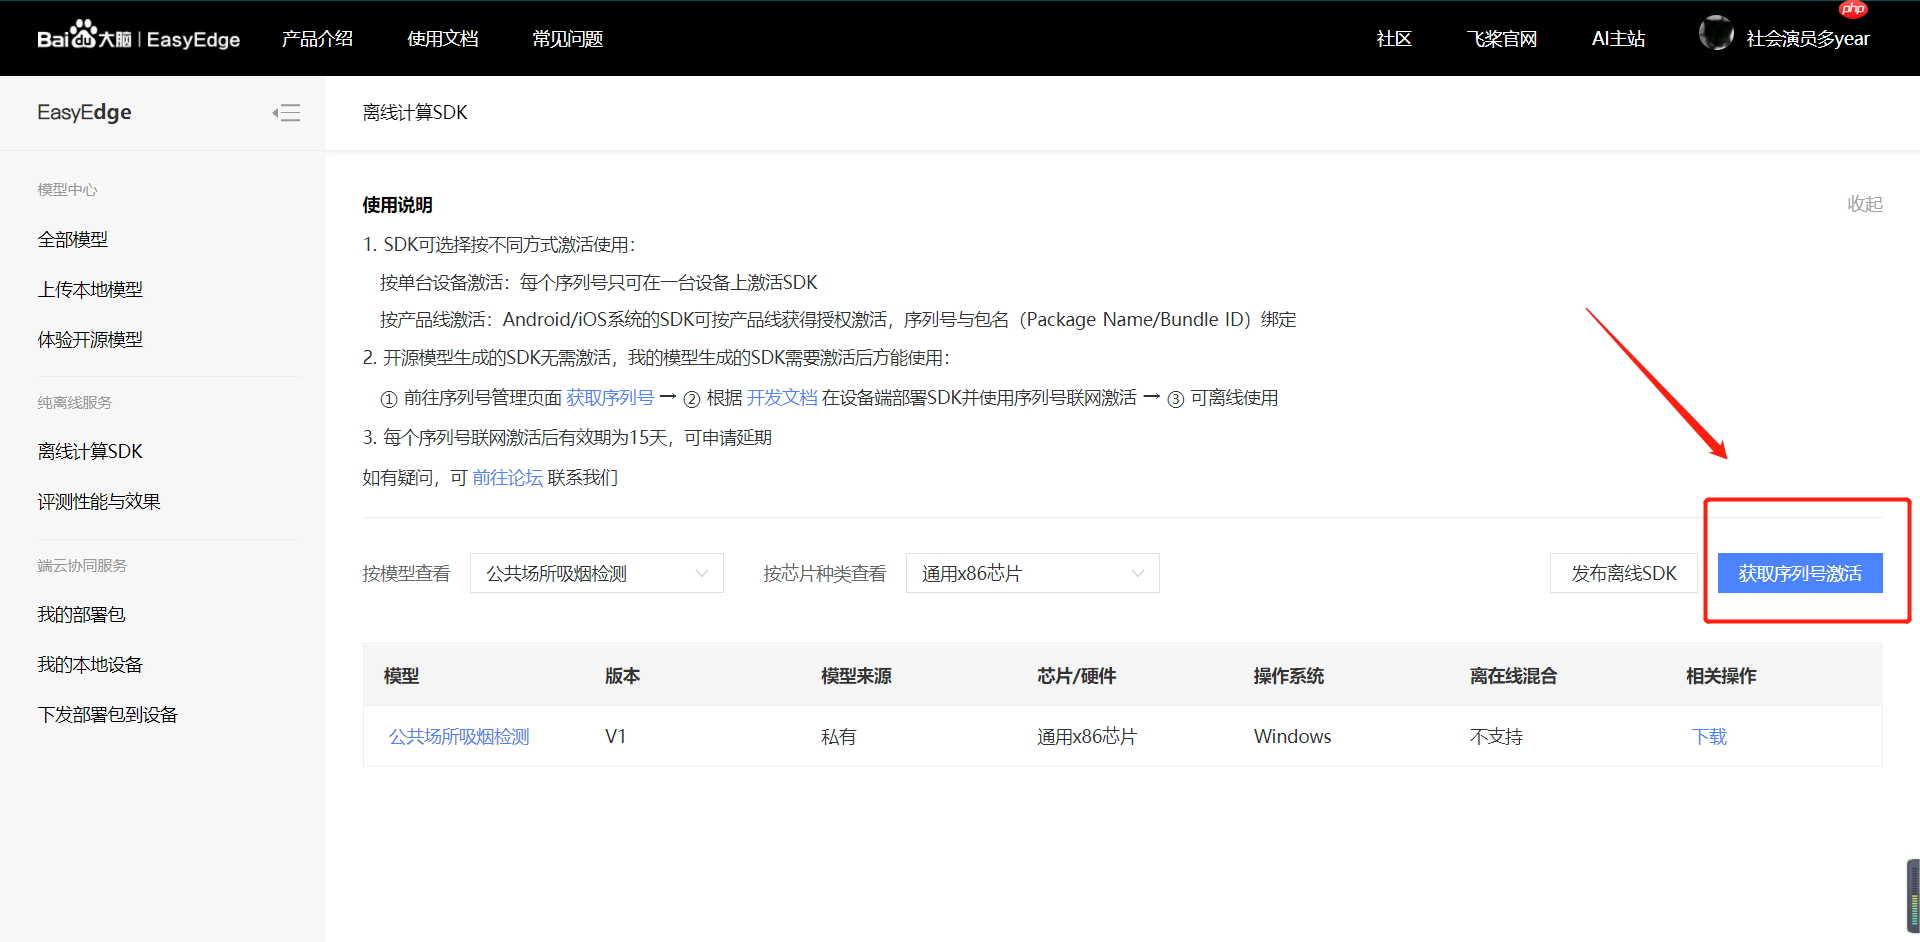
【第七步】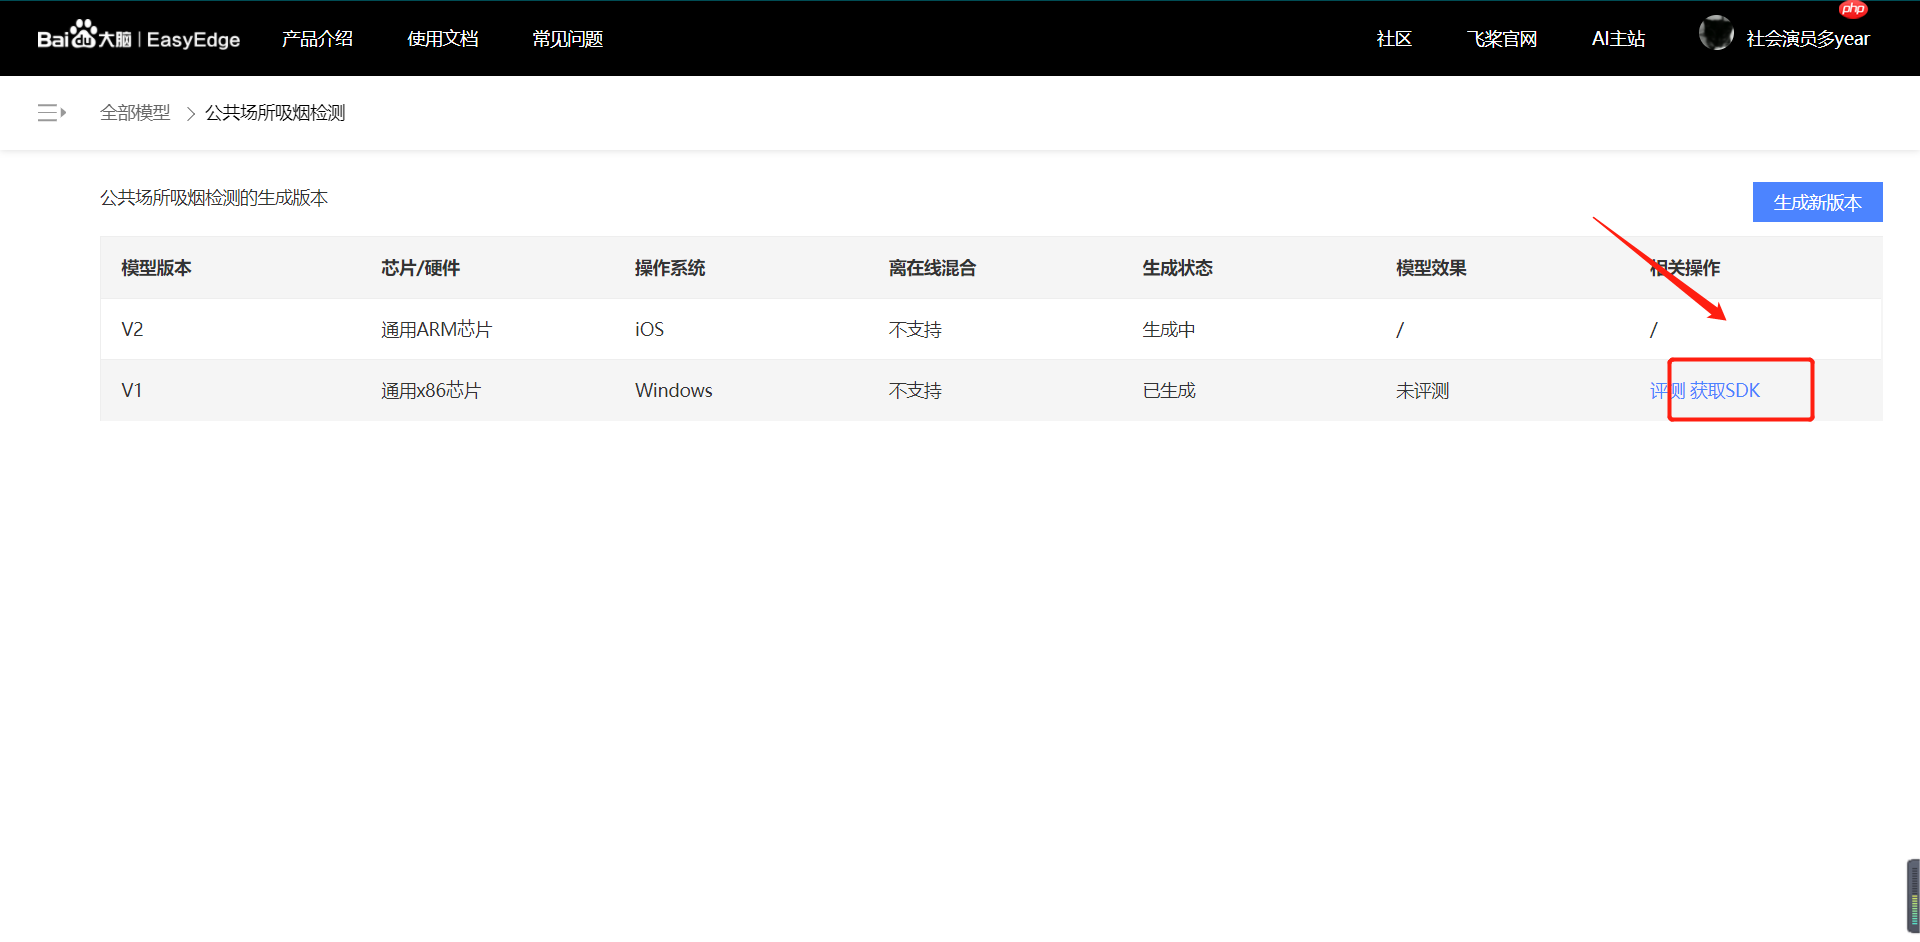
【第八步】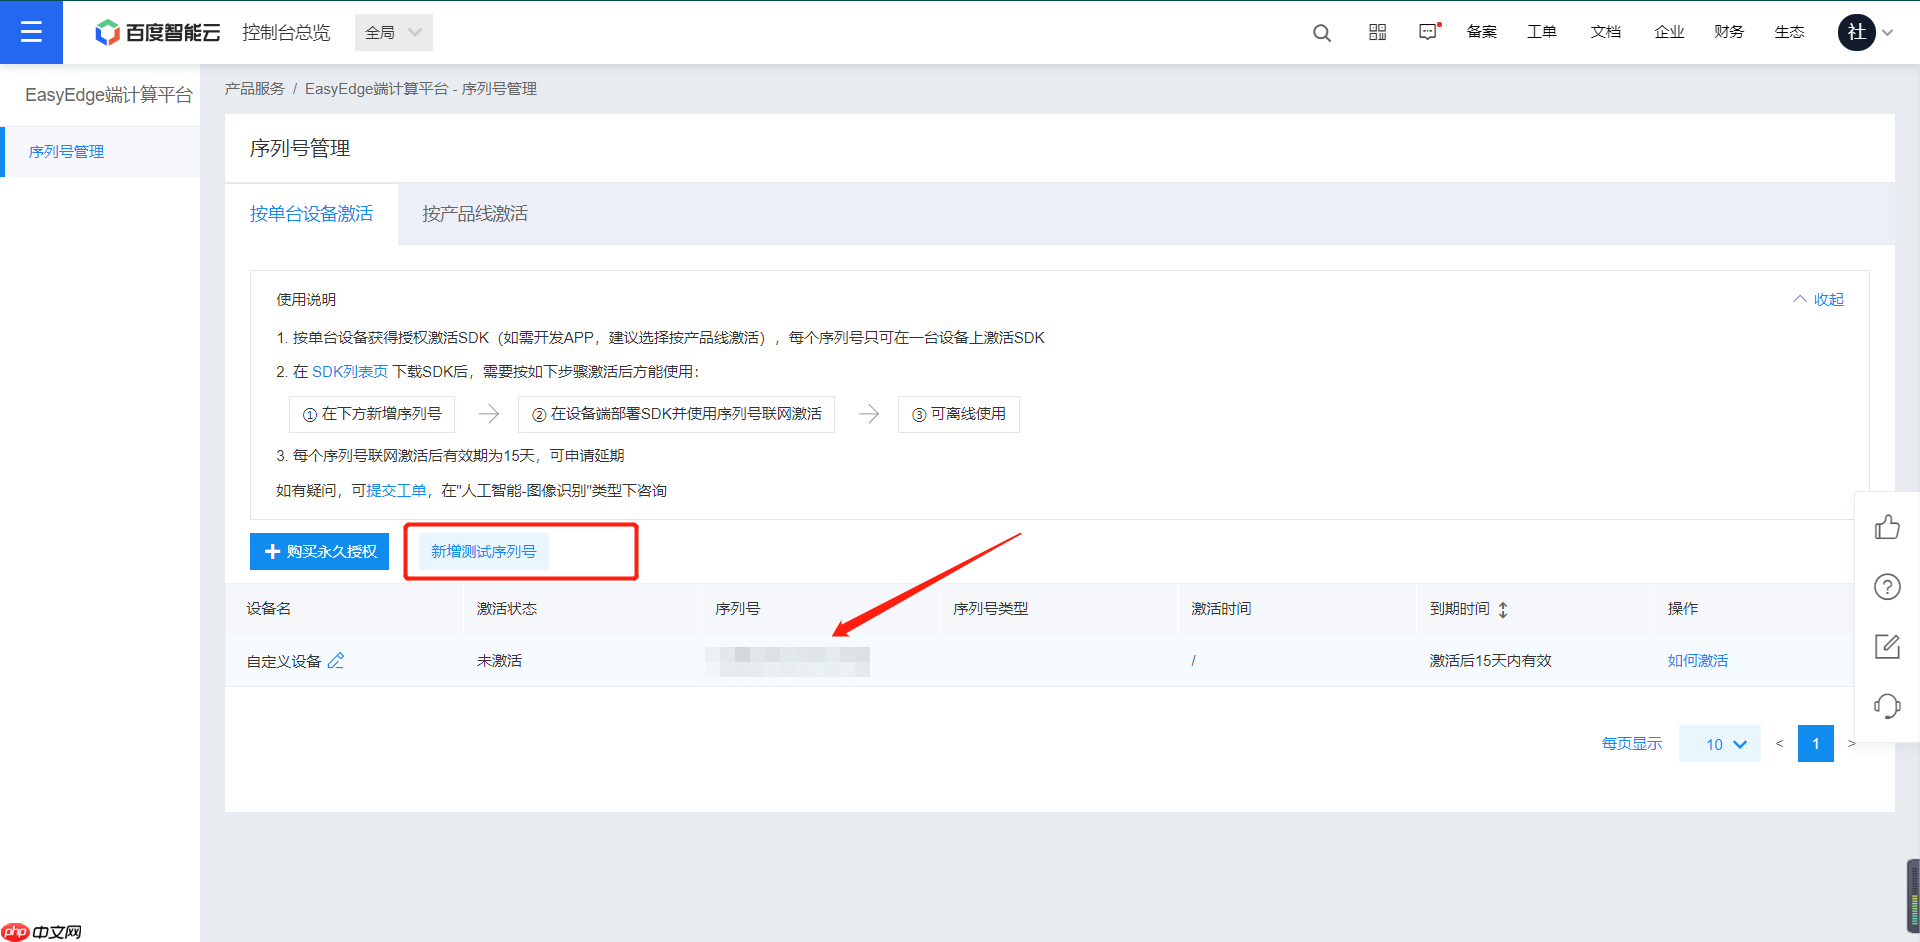
【第九步】 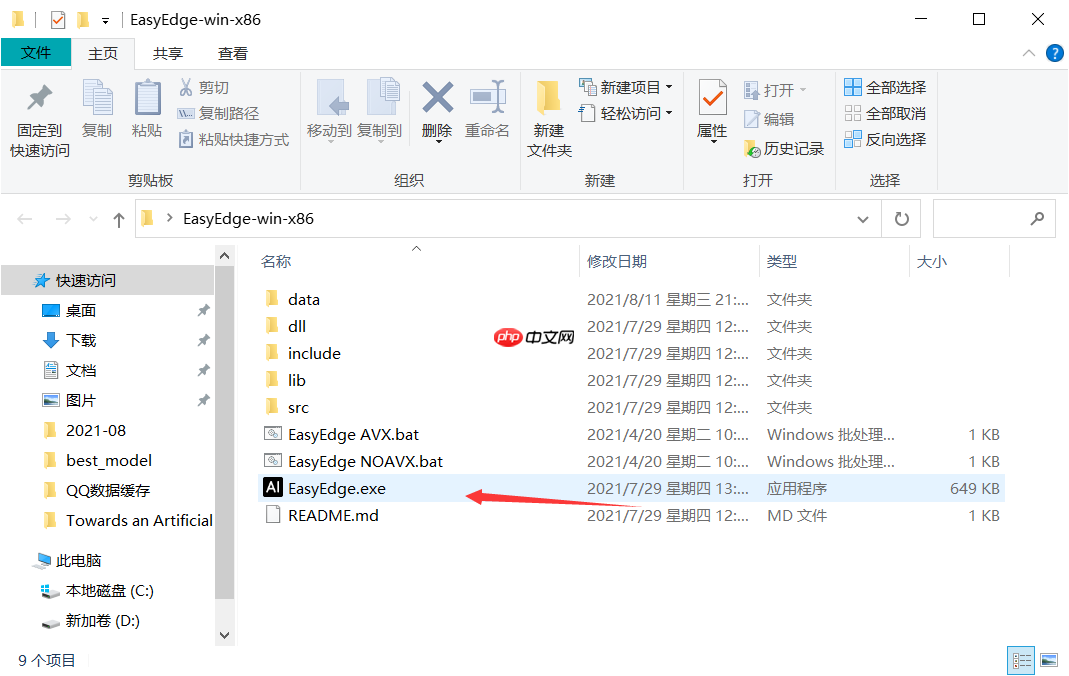
【第十步】 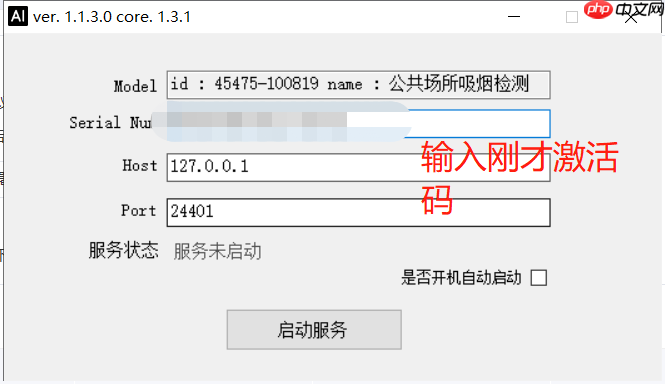
【第十一步】
APP端同样,按操作就可以了
以上就是公共场所吸烟检测与EasyEdge部署的详细内容,更多请关注其它相关文章!
# 该项目
# 抖音seo排名最新排名
# 城市推广情感营销
# 太原网站建设规划
# 网站做推广的方式
# 荆州seo优化网站推广方式
# 楚雄学校网站建设
# 晋中网站建设方式
# 锦州网站建设平台有哪些
# 如何通过门户网站推广
# 文化推广网站名字怎么起
# 是一个
# 官网
# 室外
# python
# 边缘
# 只需
# 服务平台
# 文档
# 一言
# 中文网
# udio
# 二次开发
# 百度
# ai
# 工具
# 电脑
# git
相关栏目:
【
Google疑问12 】
【
Facebook疑问10 】
【
优化推广96088 】
【
技术知识133117 】
【
IDC资讯59369 】
【
网络运营7196 】
【
IT资讯61894 】
相关推荐:
这款在《自然通讯》发表的机器人,为变形金刚来到现实创造可能性
构建AI绘画网站的方法:使用API接口和调用步骤
苹果2万5的AR遭遇砍单95%:不及预期
“长沙造”无人机,领先的不止植保
猿辅导发布最新SaaS业务进展公告:Motiff UI设计工具推出三项新的AI功能
数据科学,解码智能未来——Altair首次提出“Frictionless AI”概念
丰田汽车研究院推出生成式人工智能汽车设计工具
AI与5G的强强联合:唤醒数字时代的无尽潜能
阿里大文娱CTO郑勇:生成式AI将引发内容行业巨变,*制作机会挑战并存
苹果机器学习关键人物 Ali Farhadi 离职,回归 AI2 担任 CEO
百亿量化私募:量化投资进入“精耕细作”时代 AI带来行业新变革
百度文心一言App上架苹果商店,人工智能创作引发热议
智能技术提高现代商业运营的7七种方式
Meta发布音频AI模型,仅需2秒片段模拟真人语音
GPT-4成功战胜AI-Guardian审核系统:谷歌研究团队的人工智能抵抗人工智能
这效果能打几分?AI真人化《名侦探柯南》
消息称 ChatGPT 未来有望增加更多功能:上传文件分析信息,还能记住用户画像
日新月异,脑机接口技术都有哪些新应用?
中兴通讯无人机高空基站助力北京门头沟受灾乡镇保障应急通信
宇宙探索下一阶段,机器代替人类,AI会在太空探索中取代人类吗?
闪电快讯|京东推出言犀AI大模型 面向零售、医疗、物流等产业场景
AI技术加速迭代:周鸿祎视角下的大模型战略
贫穷让我预训练
找对了风口想不火都难,乐天派机器人,安卓机器人的最终形态?
周星驰支持的人工智能与 Web3 初创公司 Moonbox 完成 100 万美元融资
高通发布长期产品计划,为工业和企业物联网产品提供全新组合方案
世界人工智能大会高合发表演讲,HiPhi Y即将全球上市
创新全场景清洁方案!海尔商用机器人首发上市
OpenAI首席执行官引用《道德经》 呼吁就AI安全问题合作
明略科技发布免费开源TensorBoard.cpp,促进大型模型的预训练工作
“木头姐”:特斯拉的人工智能训练——“赢家通吃”的机会
中科院自研新一代 AI 大模型“紫东太初 2.0”问世
智能机器人与话剧的完美结合:宇树四足机器人B1助力《骆驼祥子》重现经典
首个算网生态体!中国移动元宇宙产业联盟正式成立
美图公司:Wink国内首发AI画面拓展功能
美图第二届影像节发布七款AI影像创作工具
静安大宁功能区企业云天励飞亮相2025世界人工智能大会,秀出AI硬实力!
美图秀秀发布七款 AI 工具:修图一样修视频、打造电影级上镜脸
基于信息论的校准技术,CML让多模态机器学习更可靠
创新科学家成功研发FAST激光靶标维护机器人
焊接协作机器人或将成为26届埃森展最大看点
网易云音乐内测上线“私人DJ” 打造AI推荐音乐助手
AI进军债券交易,BondGPT来了!
以计算机视觉技术为基础的库存管理如何改革零售行业
塑造全能智能管家:华为小艺AI加成应对大模型挑战
日媒关注中国推进鸟类识别 AI 普及,除监测保护外还可预防传染性疾病
《流浪地球2》里机器人公司的创始人:未来10年,机器人的崛起!
加强高质量数据供应能力,促进通用人工智能大模型领域的创新
金山办公宣布与英伟达团队合作,加速WPS AI服务
机器人技能大比拼
2025-07-24

运城市盐湖区信雨科技有限公司是一家深耕海外推广领域十年的专业服务商,作为谷歌推广与Facebook广告全球合作伙伴,聚焦外贸企业出海痛点,以数字化营销为核心,提供一站式海外营销解决方案。公司凭借十年行业沉淀与平台官方资源加持,打破传统外贸获客壁垒,助力企业高效开拓全球市场,成为中小企业出海的可靠合作伙伴。

 =24, # 跟随老师讲说,这里基本把显存拉到了30GB 留有2GB余量
eval_dataset=eval_dataset,
learning_rate=0.001 / 8,
warmup_steps=1000,
warmup_start_lr=0.0,
s*e_interval_epochs=1,
lr_decay_epochs=[240, 270],
use_vdl= True,
s*e_dir='output/yolov3_mobilenet')