本文介绍决策树的ID3、C4.5和CART三种生成算法。ID3以信息增益划分,有过拟合等缺点;C4.5用信息增益率,改进了缺失值处理等;CART为二叉树,用基尼系数,可分类回归,有独特剪枝和平衡策略。还附ID3实现及sklearn中CART的使用代码。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
- 决策树是一种机器学习的方法。决策树的生成算法有ID3, C4.5和CART等。决策树是一种树形结构,其中每个内部节点表示一个属性上的判断,每个分支代表一个判断结果的输出,最后每个叶节点代表一种分类结果。
- 算法主要是公式的讲解,如果初学建议先去看一下这方面的图例说明,再回来看此项目。
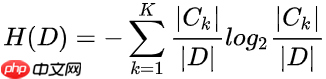
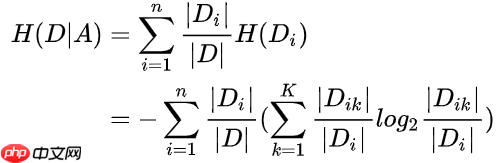
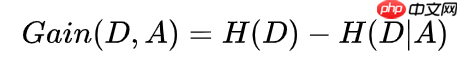
 值的处理可以分为两个子问题
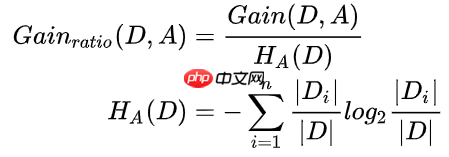
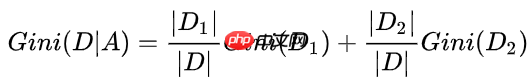
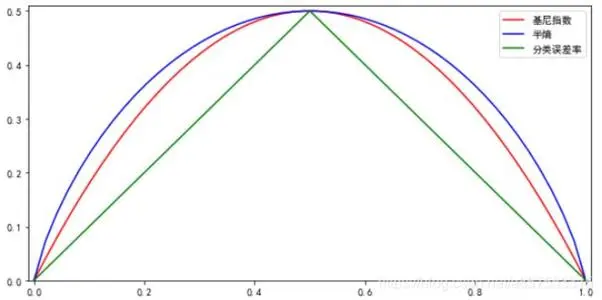
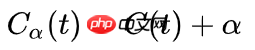
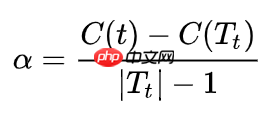
ID3 和 C4.5 虽然在对训练样本集的学习中可以尽可能多地挖掘信息,但是其生成的决策树分支、规模都比较大,CART 算法的二分法可以简化决策树的规模,提高生成决策树的效率。
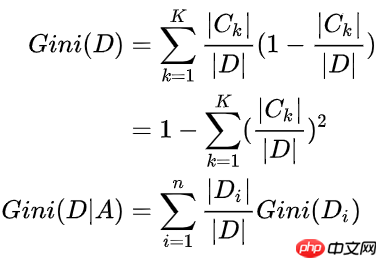
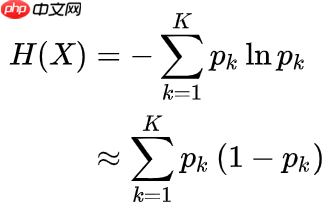
 简小派
简小派是一款AI原生求职工具,通过简历优化、岗位匹配、项目生成、模拟面试与智能投递,全链路提升求职成功率,帮助普通人更快拿到更好的 offer。
 123
查看详情

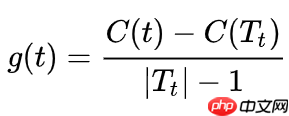
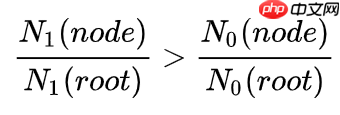
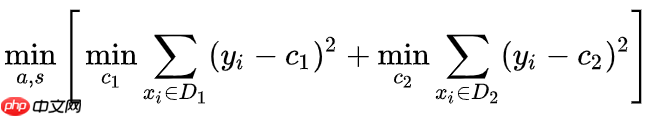
import numpy as npimport pandas as pdimport matplotlib.pyplot as plt
%matplotlib inlinefrom sklearn.datasets import load_irisfrom sklearn.model_selection import train_test_splitfrom collections import Counterimport mathfrom math import logimport pprint
def create_data():
    datasets = [['青年', '否', '否', '一般', '否'],
               ['青年', '否', '否', '好', '否'],
               ['青年', '是', '否', '好', '是'],
               ['青年', '是', '是', '一般', '是'],
               ['青年', '否', '否', '一般', '否'],
               ['中年', '否', '否', '一般', '否'],
               ['中年', '否', '否', '好', '否'],
               ['中年', '是', '是', '好', '是'],
               ['中年', '否', '是', '非常好', '是'],
               ['中年', '否', '是', '非常好', '是'],
               ['老年', '否', '是', '非常好', '是'],
               ['老年', '否', '是', '好', '是'],
               ['老年', '是', '否', '好', '是'],
               ['老年', '是', '否', '非常好', '是'],
               ['老年', '否', '否', '一般', '否'],
               ]
    labels = [u'年龄', u'有工作', u'有自己的房子', u'信贷情况', u'类别']    # 返回数据集和每个维度的名称
    return datasets, labels
In [3]
datasets, labels = create_data()In [4]
train_data = pd.DataFrame(datasets, columns=labels)In [5]
train_data
    年龄 有工作 有自己的房子 信贷情况 类别
0   青年   否      否   一般  否
1   青年   否      否    好  否
2   青年   是      否    好  是
3   青年   是      是   一般  是
4   青年   否      否   一般  否
5   中年   否      否   一般  否
6   中年   否      否    好  否
7   中年   是      是    好  是
8   中年   否      是  非常好  是
9   中年   否      是  非常好  是
10  老年   否      是  非常好  是
11  老年   否      是    好  是
12  老年   是      否    好  是
13  老年   是      否  非常好  是
14  老年   否      否   一般  否
# 熵def calc_ent(datasets):
    data_length = len(datasets)
    label_count = {}    for i in range(data_length):
        label = datasets[i][-1]        if label not in label_count:
            label_count[label] = 0
        label_count[label] += 1
    ent = -sum([(p/data_length)*log(p/data_length, 2) for p in label_count.values()])    return ent# 经验条件熵def cond_ent(datasets, axis=0):
    data_length = len(datasets)
    feature_sets = {}    for i in range(data_length):
        feature = datasets[i][axis]        if feature not in feature_sets:
            feature_sets[feature] = []
        feature_sets[feature].append(datasets[i])
    cond_ent = sum([(len(p)/data_length)*calc_ent(p) for p in feature_sets.values()])    return cond_ent# 信息增益def info_gain(ent, cond_ent):
    return ent - cond_entdef info_gain_train(datasets):
    count = len(datasets[0]) - 1
    ent = calc_ent(datasets)
    best_feature = []    for c in range(count):
        c_info_gain = info_gain(ent, cond_ent(datasets, axis=c))
        best_feature.append((c, c_info_gain))        print('特征({}) - info_gain - {:.3f}'.format(labels[c], c_info_gain))    # 比较大小
    best_ = max(best_feature, key=lambda x: x[-1])    return '特征({})的信息增益最大,选择为根节点特征'.format(labels[best_[0]])
In [7]
info_gain_train(np.array(datasets))
特征(年龄) - info_gain - 0.083
特征(有工作) - info_gain - 0.324
特征(有自己的房子) - info_gain - 0.420
特征(信贷情况) - info_gain - 0.363
'特征(有自己的房子)的信息增益最大,选择为根节点特征'
# 定义节点类 二叉树class Node:
    def __init__(self, root=True, label=None, feature_name=None, feature=None):
        self.root = root
        self.label = label
        self.feature_name = feature_name
        self.feature = feature
        self.tree = {}
        self.result = {'label:': self.label, 'feature': self.feature, 'tree': self.tree}    def __repr__(self):
        return '{}'.format(self.result)    def add_node(self, val, node):
        self.tree[val] = node    def predict(self, features):
        if self.root is True:            return self.label        return self.tree[features[self.feature]].predict(features)
class DTree:
    def __init__(self, epsilon=0.1):
        self.epsilon = epsilon
        self._tree = {}    # 熵    @staticmethod
    def calc_ent(datasets):
        data_length = len(datasets)
        label_count = {}        for i in range(data_length):
            label = datasets[i][-1]            if label not in label_count:
                label_count[label] = 0
            label_count[label] += 1
        ent = -sum([(p/data_length)*log(p/data_length, 2) for p in label_count.values()])        return ent    # 经验条件熵
    def cond_ent(self, datasets, axis=0):
        data_length = len(datasets)
        feature_sets = {}        for i in range(data_length):
            feature = datasets[i][axis]            if feature not in feature_sets:
                feature_sets[feature] = []
            feature_sets[feature].append(datasets[i])
        cond_ent = sum([(len(p)/data_length)*self.calc_ent(p) for p in feature_sets.values()])        return cond_ent    # 信息增益    @staticmethod
    def info_gain(ent, cond_ent):
        return ent - cond_ent    def info_gain_train(self, datasets):
        count = len(datasets[0]) - 1
        ent = self.calc_ent(datasets)
        best_feature = []        for c in range(count):
            c_info_gain = self.info_gain(ent, self.cond_ent(datasets, axis=c))
            best_feature.append((c, c_info_gain))        # 比较大小
        best_ = max(best_feature, key=lambda x: x[-1])        return best_    def train(self, train_data):
        """
        input:数据集D(DataFrame格式),特征集A,阈值eta
        output:决策树T
        """
        _, y_train, features = train_data.iloc[:, :-1], train_data.iloc[:, -1], train_data.columns[:-1]        # 1,若D中实例属于同一类Ck,则T为单节点树,并将类Ck作为结点的类标记,返回T
        if len(y_train.value_counts()) == 1:            return Node(root=True,
                        label=y_train.iloc[0])        # 2, 若A为空,则T为单节点树,将D中实例树最大的类Ck作为该节点的类标记,返回T
        if len(features) == 0:            return Node(root=True, label=y_train.value_counts().sort_values(ascending=False).index[0])        # 3,计算最大信息增益 同5.1,Ag为信息增益最大的特征
        max_feature, max_info_gain = self.info_gain_train(np.array(train_data))
        max_feature_name = features[max_feature]        # 4,Ag的信息增益小于阈值eta,则置T为单节点树,并将D中是实例数最大的类Ck作为该节点的类标记,返回T
        if max_info_gain < self.epsilon:            return Node(root=True, label=y_train.value_counts().sort_values(ascending=False).index[0])        # 5,构建Ag子集
        node_tree = Node(root=False, feature_name=max_feature_name, feature=max_feature)

        feature_list = train_data[max_feature_name].value_counts().index        for f in feature_list:
            sub_train_df = train_data.loc[train_data[max_feature_name] == f].drop([max_feature_name], axis=1)            # 6, 递归生成树
            sub_tree = self.train(sub_train_df)
            node_tree.add_node(f, sub_tree)        # pprint.pprint(node_tree.tree)
        return node_tree    def fit(self, train_data):
        self._tree = self.train(train_data)        return self._tree    def predict(self, X_test):
        return self._tree.predict(X_test)
In [9]
datasets, labels = create_data()
data_df = pd.DataFrame(datasets, columns=labels)
dt = DTree()
tree = dt.fit(data_df)
In [10]
tree
{'label:': None, 'feature': 2, 'tree': {'否': {'label:': None, 'feature': 1, 'tree': {'否': {'label:': '否', 'feature': None, 'tree': {}}, '是': {'label:': '是', 'feature': None, 'tree': {}}}}, '是': {'label:': '是', 'feature': None, 'tree': {}}}}
In [11]
dt.predict(['老年', '否', '否', '一般'])
'否'
# datadef create_data():
    iris = load_iris()
    df = pd.DataFrame(iris.data, columns=iris.feature_names)
    df['label'] = iris.target
    df.columns = ['sepal length', 'sepal width', 'petal length', 'petal width', 'label']
    data = np.array(df.iloc[:100, [0, 1, -1]])    # print(data)
    return data[:,:2], data[:,-1]

X, y = create_data()
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3)
In [13]
from sklearn.tree import DecisionTreeClassifierfrom sklearn.tree import export_graphvizimport graphvizIn [14]
clf = DecisionTreeClassifier()
clf.fit(X_train, y_train,)
In [15]
clf.score(X_test, y_test)
0.9In [16]
tree_pic = export_graphviz(clf, out_file="mytree.pdf")with open('mytree.pdf') as f:
    dot_graph = f.read()
In [17]
# 决策树可视化graphviz.Source(dot_graph)
以上就是“机器学习”系列之决策树的详细内容,更多请关注其它相关文章!
# 为什么
# 海南seo排名收费标准
# 嘉兴网站优化报价软件
# 兰溪短视频营销推广招聘
# 自己的
# 最优
# 基尼
# 非常好
# 递归
# 特征值
# 系列之
# 中文网
# 决策树
# 子树
# red
# ai
# 闵行区营销策划推广中心
# 传媒网站建设学习
# 安顺营销推广网站
# 秒收录工具seo 推广
# 果汁的网络营销推广目标
# 外贸有哪些推广网站好做
# 成都网站建设蜀风科技
相关栏目:
【
Google疑问12 】
【
Facebook疑问10 】
【
优化推广96088 】
【
技术知识133117 】
【
IDC资讯59369 】
【
网络运营7196 】
【
IT资讯61894 】
相关推荐:
ChatGPT大更新!OpenAI奉上程序员大礼包:API新增杀手级能力还降价,新模型、四倍上下文都来了
阿里达摩院向公众免费开放100项AI专利许可
用AI技术点亮老照片:Deep Nostalgia带给照片新生动感
PHP和OpenCV库:如何实现人脸识别
洞穴探险神器?可自主导航的单旋翼自旋无人机,效率更高!
支持跨语言、人声狗吠互换,仅利用最近邻的简单语音转换模型有多神奇
微软AR/VR专利提出使用时间复用谐振驱动产生双极性电源
华为云盘古大模型3.0发布 AI云服务同时上线:200亿亿次性能
Hugging Face发布了基于NASA卫星数据构建的AI地理空间基础模型
昇腾AI大模型训推一体化解决方案将在WAIC发布
联想首发AI PC于今年秋季,英特尔CEO确认AI PC时代来临
无人机协助盐城交通执法的协同训练
OpenAI 为开发者推出 GPT 聊天机器人 API 大更新,同时降低价格
羊驼家族大模型集体进化!32k上下文追平GPT-4,田渊栋团队出品
Unity 内测 Safe Voice 服务,利用 AI 自动识别玩家不当聊天内容
腾讯机器狗进化:通过深度学习掌握自主决策能力
普林斯顿Infinigen矩阵开启!AI造物主100%创造大自然,逼真到炸裂
国内阅读行业首款对话式AI应用“阅爱聊”封闭内测
人工智能时代的科幻译者怎么办?“做好翻译工作的高端10%”|文化观察
视觉中国推出AI灵感绘图功能,付费后可在“合法合规前提下使用”
专家解读国家网信办深度合成服务算法备案信息公告:不等于百度、阿里、腾讯等生成式AI产品获批
日入400万,第一批AI骗子已上岗
郭帆导演成功利用AI技术制作的《流浪地球3》预告片在央视热播,引发巨大反响
日媒关注中国推进鸟类识别 AI 普及,除监测保护外还可预防传染性疾病
微软向美国政府提供GPT大模型,如何保证安全性?
微软bing聊天推出AI购物工具 可进行比价并查看历史最低价
WPS AI 官网上线:可申请体验官资格,支持 Windows、安卓端下载
世界水下机器人大赛:9国青年携手逐梦深蓝
码刻 | 48小时Hackathon,源码见证新生代AI创新的发生
OpenAI宣布组建新团队 以控制“超级智能”人工智能
微软在 Bing 和 Edge 浏览器中拓展网购服务,帮用户选购心仪产品
闪电快讯|京东推出言犀AI大模型 面向零售、医疗、物流等产业场景
在这里见未来!杭州未来科技城全球AI盛会邀您共探最前沿
谷歌推出新 AI 工具 Imagen Editor,一句话对图片二次创作
Bing Chat 和 Bing Search 正式引入深色模式
Unity发布Sentis和Muse AI工具,助力创作游戏和3D内容
“踩油门,也要会踩刹车” 互联网企业高管谈人工智能发展
外科医生的智能助手,“机器人手术”得到补充商业医保覆盖
GPT-4不能在麻省理工学院获得计算机科学学位
黄仁勋:5年前,我们对AI抱有巨大期望
微幼科技晨检机器人与人工晨检相比,有何优势
如何利用AI工具写好本科论文:科技助你一臂之力
AI行业盛会大咖云集!Sam Altam、“AI教父”......一文看懂最新观点
边喷火边跳踢踏舞,机器狗最新技能爆火全网!网友直呼真·热狗
让AI助手带您轻松愉快地享受写作之旅
大语言模型的视觉天赋:GPT也能通过上下文学习解决视觉任务
美版贴吧8000小组自爆停摆!拒绝数据被谷歌OpenAI白嫖,CEO被网友骂翻:背刺第三方应用
零数科技CTO兰春嘉:区块链与人工智能的结合点在数据
微软 Copilot 团队主管呼吁用户与 AI 交流时应使用恰当的礼貌用语
“木头姐”:特斯拉的人工智能训练——“赢家通吃”的机会
2025-07-22

运城市盐湖区信雨科技有限公司是一家深耕海外推广领域十年的专业服务商,作为谷歌推广与Facebook广告全球合作伙伴,聚焦外贸企业出海痛点,以数字化营销为核心,提供一站式海外营销解决方案。公司凭借十年行业沉淀与平台官方资源加持,打破传统外贸获客壁垒,助力企业高效开拓全球市场,成为中小企业出海的可靠合作伙伴。
