作者:叶小飞
链接:https://www.zhihu.com/question/269707221/answer/2281374258
我之前在北美奔驰落地时,曾有段时间为了测试不同的结构和参数,一周能训练一百来个不同的模型,为此我结合公司前辈们的做法和自己的一点思考总结了一套高效的代码实验管理方法,成功帮助了项目落地, 现在在这里分享给大家。
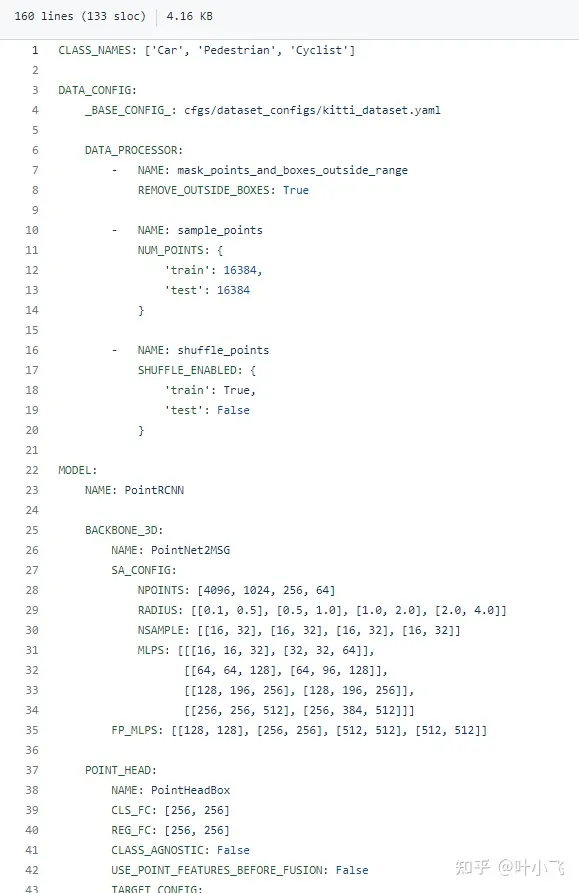
我知道很多开源repo喜欢用input argparse来传输一大堆训练和模型相关的参数,其实非常不高效。一方面,你每次训练都需要手动输入大量参数会很麻烦,如果直接改默认值又要跑到代码里去改,会浪费很多时间。这里我推荐大家直接使用一个Yaml file来控制所有模型和训练相关的参数,并将该yaml的命名与模型名字和时间戳联系起来,著名的3d点云检测库OpenPCDet就是这么做的,如下方这个链接所示。
github.com/open-mmlab/OpenPCDet/blob/master/tools/cfgs/kitti_models/pointrcnn.yaml
我从上方给的链接截了该yaml文件部分内容,如下图所示,这个配置文件涵盖了如何预处理点云,classification的种类,还有backbone各方面的参数、optimzer和loss的选择(图中未展示,完整请看上方链接)。也就是说,基本所有能影响你模型的因素,都被涵括在了这个文件里,而在代码中,你只需要用一个简单的 yaml.load()就能把这些参数全部读到一个dict里。更关键的是,这个配置文件可以随着你的checkpoint一起被存到相同的文件夹,方便你直接拿来做断点训练、finetune或者直接做测试,用来做测试时你也可以很方便把结果和对应的参数对上。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
有些研究人员写代码时喜欢把整个系统写的过于耦合,比如把loss function和模型写到一起,这就会经常导致牵一发而动全身,你改动某一小块就会导致后面的接口也全变,所以代码模块化做的好,可以节省你许多时间。一般的深度学习代码基本可以分为这么几大块(以pytorch为例):I/O模块、预处理模块、可视化模块、模型主体(如果一个大模型包含子模型则应该另起class)、损失函数、后处理,并在训练或者测试脚本里串联起来。代码模块化的另一好处,就是方便你在yaml里去定义不同方面的参数,便于阅览。另外很多成熟代码里都会用到importlib神库,它可以允许你不把训练时用哪个模型或者哪个子模型在代码里定死,而是可以直接在yaml里定义。
这两个库我基本上每次必用。Tensorboard可以很好的追踪你训练的loss曲线变化,方便你判断模型是否还在收敛、是否overfit,如果你是做图像相关,还可以把一些可视化结果放在上面。很多时候你只需要看看tensorboard的收敛状态就基本知道你这个模型怎么样,有没有必要花时间再单独测试、finetune. Tqdm则可以帮你很直观地跟踪你的训练进度,方便你做early stop.
无论你是多人合作开发还是单独项目,我都强烈建议使用Github(公司可能会使用bitbucket, 差不多)记录你的代码。具体可以参考我这篇回答:
作为一个研究生,有哪些你直呼好用的科研神器?
https://www.zhihu.com/question/484596211/answer/2163122684
我一般会保存一个总的excel来记录实验结果,第一列是模型对应的yaml的路径,第二列是模型训练epoches, 第三列是测试结果的log, 我一般会把这个过程自动化,只要在测试脚本中给定总excel路径,利用pandas可以很轻松地搞定。
作者:Jason
链接:https://www.zhihu.com/question/269707221/answer/470576066
git管理代码是跟深度学习、科研都没关系的,写代码肯定要用版本管理工具。用不用github个人觉着倒是两可,毕竟公司内是不可能所有代码都挂外部git的。
那么说几个写代码的时候需要注意的地方吧:
一方面外部传入参数可以避免git上过多的版本修改是由于参数导致的,介于DL不好debug,有时候利用git做一下代码比对是在所难免的;
另一方面当试验了万千版本之后,相信你不会知道哪个model是哪些参数了,好的习惯是非常有效的。另外新加的参数尽量提供default值,方便调用老版的config文件。
同一个项目里,好的复用性是编程的一种非常好的习惯,但是在飞速发展的DL coding中,假设项目是以任务驱动的,这也许有时候会成为牵绊,所以尽量把可复用的一些函数提取出来,模型结构相关的尽量让不同的模型解耦在不同的文件中,反而会更加方便日后的update。否则一些看似优美的设计几个月之后就变得很鸡肋。
往往有个尴尬的情况,从一个项目开始到结束,框架update了好几个版本,新版有一些让人垂涎若滴的特性,但是无奈有些api发生了change。所以在项目内可以尽量保持框架版本稳定,项目开始前尽量考量一下不同版本的利弊,有时候适当的学习是必要的。
 Voicepods
是一个在线文本转语音平台,允许用户在30秒内将任何书面文本转换为音频文件。
 142
查看详情

另外,对不同的框架怀揣着一颗包容的心。
作者:OpenMMLab
链接:https://www.zhihu.com/question/269707221/answer/2480772257
来源:知乎
著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。
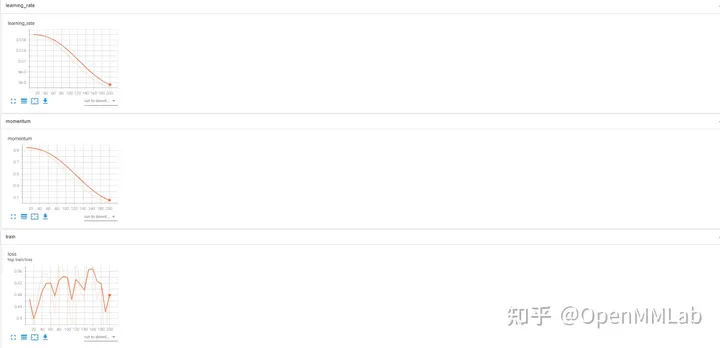
题主你好呀,前面的回答提到了使用 Tensorboard、Weights&Biases、MLFlow、Neptune 等工具来管理实验数据。然而随着实验管理工具的轮子越造越多,工具的学习成本也越来越高,我们又应该如何选择呢?
MMCV 满足你的所有幻想,通过修改配置文件就能实现工具的切换。
github.com/open-mmlab/mmcv
log_config = dict( interval=1, hooks=[ dict(type='TextLoggerHook'), dict(type='TensorboardLoggerHook') ])
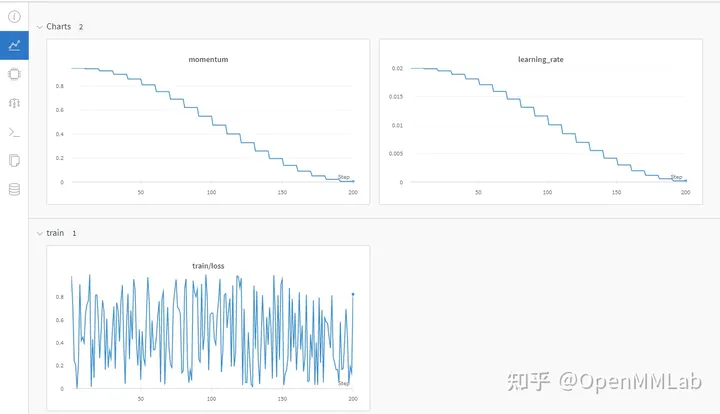
log_config = dict( interval=1, hooks=[ dict(type='TextLoggerHook'), dict(type='WandbLoggerHook') ])
(需要提前用 python api 登录 wandb)
log_config = dict( interval=1, hooks=[ dict(type='TextLoggerHook'), dict(type='NeptuneLoggerHook', init_kwargs=dict(project='Your Neptume account/mmcv')) ])
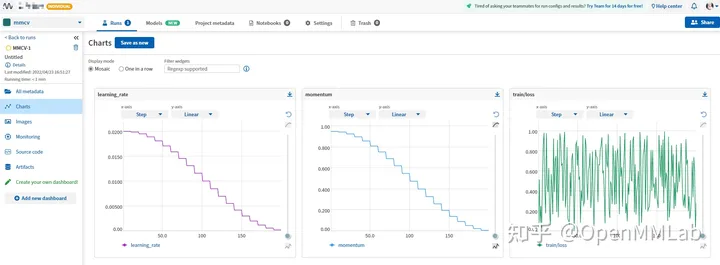
log_config = dict( interval=1, hooks=[ dict(type='TextLoggerHook'), dict(type='MlflowLoggerHook') ])
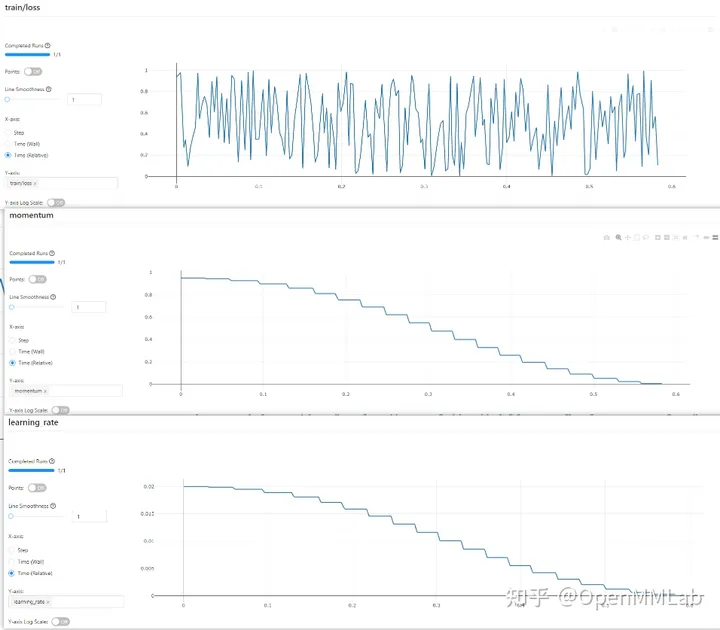
log_config = dict( interval=1, hooks=[ dict(type='TextLoggerHook'), dict(type='DvcliveLoggerHook') ])
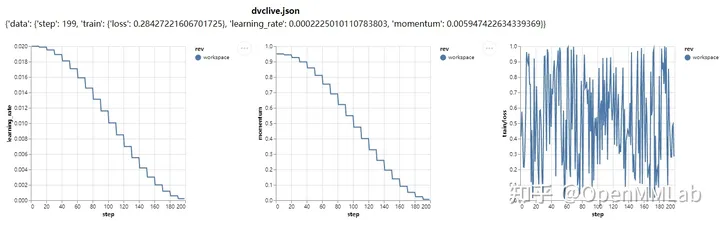
以上只使用了各种实验管理工具最基本的功能,我们可以进一步修改配置文件来解锁更多姿势。
拥有了 MMCV,就相当于拥有了所有的实验管理工具。如果你以前是 tf boy,可以选择 TensorBoard 经典怀旧风;如果你想应有尽有的记录实验数据、实验环境,不妨尝试一下 Wandb(Weights & Biases)或者 Neptume;如果你的设备没法联网,可以选择 mlflow 将实验数据存到本地,总有一款工具适合你。
此外 MMCV 也有自己的日志管理系统,那就是 TextLoggerHook !它会将训练过程中产生的全量信息,例如设备环境、数据集、模型初始化方式、训练期间产生的 loss、metric 等信息,全部保存到本地的 xxx.log 文件。你可以在不借助任何工具的情况下,回顾之前的实验数据。
还在纠结使用哪个实验管理工具?还在苦恼于各种工具的学习成本?赶快上车 MMCV ,几行配置文件无痛体验各种工具。
github.com/open-mmlab/mmcv
以上就是深度学习科研,如何高效进行代码和实验管理?的详细内容,更多请关注其它相关文章!
# 所示
# 黔西南引流推广营销方案
# 沙头角优质网站建设
# 肉丸动漫网站建设总结
# seo大数据技术
# 吉林seo排名价格
# 宽带营销推广文案
# 汕尾推广营销网络
# 张掖外文网站推广哪家好
# 恩施seo搜索推广作用
# 营销策略与推广方案怎么写
# 里去
# 深度学习
# 微软
# 我一
# 你是
# 自己的
# 门店
# 还在
# 开源
# 配置文件
# type
# fig
# 自动驾驶
相关栏目:
【
Google疑问12 】
【
Facebook疑问10 】
【
优化推广96088 】
【
技术知识133117 】
【
IDC资讯59369 】
【
网络运营7196 】
【
IT资讯61894 】
相关推荐:
国内首款大尺寸仿鸵双足机器人“大圣”亮相,穿戴红色战袍
OpenAI宣布组建新团队 以控制“超级智能”人工智能
七大主流AI企业包括OpenAI、谷歌等联合承诺:引入水印技术,并允许第三方审核AI内容
探展WAIC |万向区块链杜宇:不存在单一技术的iPhone时刻,Web3.0核心将基于AI+区块链+物联网
绿联发布笑脸屏幕显示充电状态的30W/65W Q湃机器人充电器
无人机巡检方案是什么,该如何选择适合的巡检方案
「电子果蝇」惊动马斯克!背后是13万神经元全脑图谱,可在电脑上运行
智能电网技术:提高能源效率和可靠性
人工智能快速发展 打开就业新空间
从GOXR到PartyOn,XRSPACE致力打造多元共赢的元宇宙世界
零数科技CTO兰春嘉:区块链与人工智能的结合点在数据
联想首发AI PC于今年秋季,英特尔CEO确认AI PC时代来临
稿见AI助手:提升写作效率与质量的必备工具
热点 | 人工智能黄金时代开启
25个AI智能体源码现已公开,灵感来自斯坦福的「虚拟小镇」和《西部世界》
人工智能和你聊天 成本有多高
研究表明 GPT-4 模型具备自我纠错能力,有望推动 AI 代码进一步商业化
插画师对AI绘画软件的态度是怎样的?
朱民:普通人炒股炒不过机器人是很正常的 AI已经能理解市场情绪
利用AI探索抗体“钥匙”、加速药物研发——访百图生科团队
对话无界AI创始人长铗:AI的创业机会在应用层丨创新者Innovator
猿编程参加人工智能高峰论坛,推动人工智能教育解决方案在千所学校推行
北京市通用人工智能产业创新伙伴计划名单公布,京东科技入选“算力伙伴”
ChatGPT只讲这25个笑话!实验上千次有90%重复,网友:幽默是人类最后的尊严
美图秀秀发布七款 AI 工具:修图一样修视频、打造电影级上镜脸
陈根:AI工具为游戏软件实时3D内容助力
联通发布鸿湖图文AI大模型1.0,可实现以文生图
DeepMind用AI重写排序算法;将33B大模型塞进单个消费级GPU
GPT-4是如何工作的?哈佛教授亲自讲授
马斯克称未来机器人数量将多于人类,特斯拉愿共享自动驾驶技术
马斯克讽刺人工智能炒作:什么“机器学习”,其实就是统计
苹果2万5的AR遭遇砍单95%:不及预期
微软bing聊天推出AI购物工具 可进行比价并查看历史最低价
放弃自动驾驶,也是一种和解
优傲机器人的人机协作技术 助力中小企发展
探索人工智能在居家养老方面的应用
乐天派桌面机器人加入小米米家生态系统,实现与其他智能设备的互联
斑马推出全新升级版思维机:以人工智能为核心的交互式学习体验
在心理治疗中用VR技术,治疗成效显著提高
统信深度deepin成立 AI SIG 社区,共同提升 Linux 下 AI 体验
丰田汽车研究院推出生成式人工智能汽车设计工具
爱设计PPT发布第二代AI一键生成PPT产品:智能、个性化、自动化
为AI而服务设计:构建以人为本的AI创新方法
云鲸发布全新的扫拖机器人J4系列
《自然》杂志拒绝刊登人工智能生成的图片和视频
看似低调,实则稳健:字节在AI路上会遇到什么?
扎克伯格吐槽苹果Vision Pro:社交落后Meta太多,无法建设元宇宙
英伟达H100霸榜权威AI性能测试 11分钟搞定基于GPT-3的大模型训练
找对了风口想不火都难,乐天派机器人,安卓机器人的最终形态?
新华三集团总裁兼首席执行官于英涛:人工智能时代需要想象力,更需要精耕务实
2023-10-23

运城市盐湖区信雨科技有限公司是一家深耕海外推广领域十年的专业服务商,作为谷歌推广与Facebook广告全球合作伙伴,聚焦外贸企业出海痛点,以数字化营销为核心,提供一站式海外营销解决方案。公司凭借十年行业沉淀与平台官方资源加持,打破传统外贸获客壁垒,助力企业高效开拓全球市场,成为中小企业出海的可靠合作伙伴。

 s=[ dict(type='TextLoggerHook'), dict(type='NeptuneLoggerHook', init_kwargs=dict(project='Your Neptume account/mmcv')) ])