10毫秒生成一张图像,1分钟6000张图像,这是什么概念?
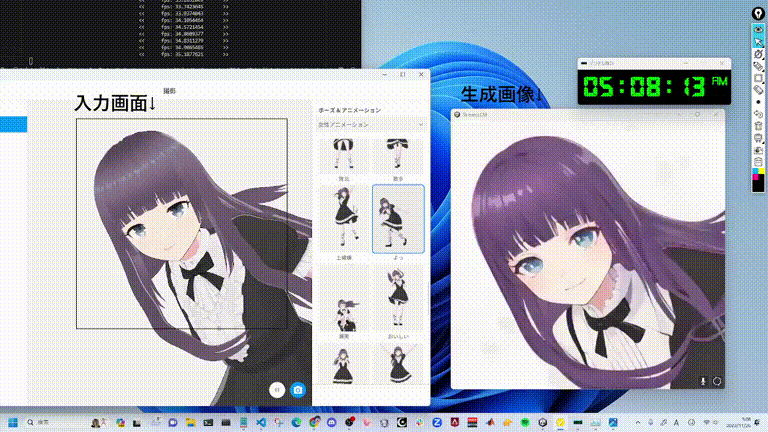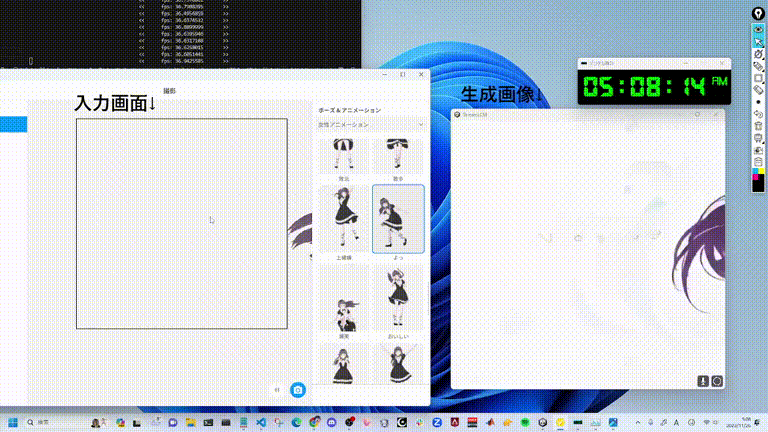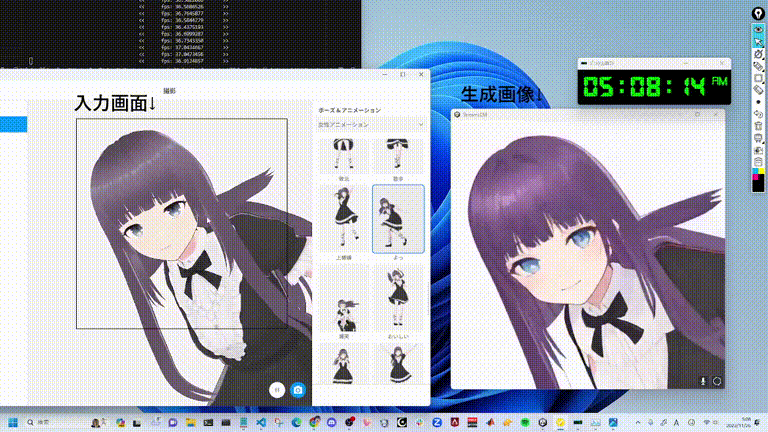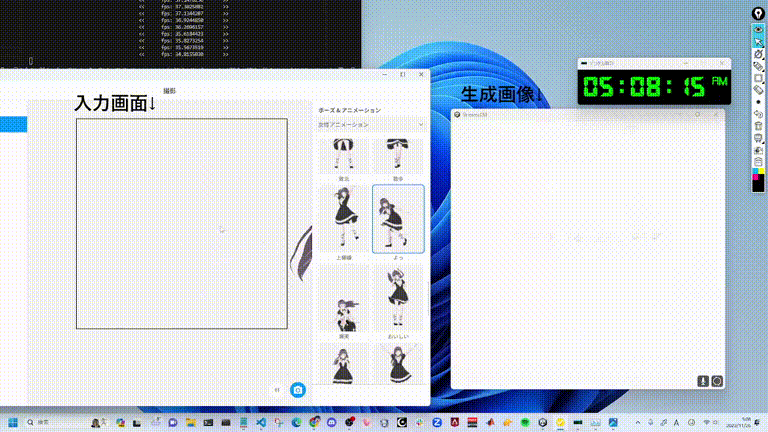
下图中,就可以深刻感受到AI的超能力。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
 图片
甚至,当你在二次元小姐姐图片生成的提示中,不断加入新的元素,各种风格的图片更迭也是瞬间闪过。
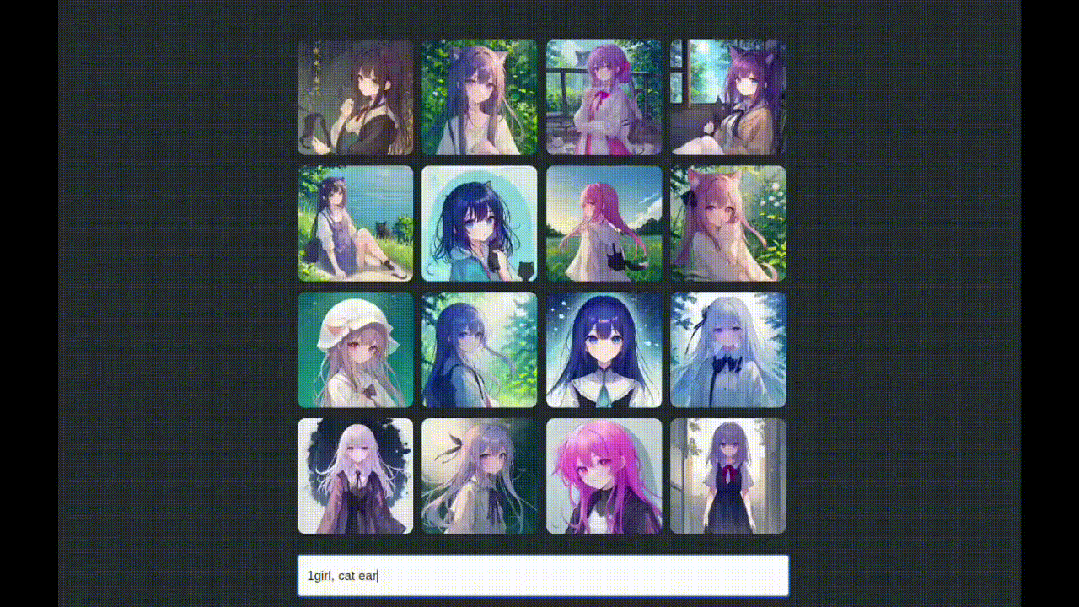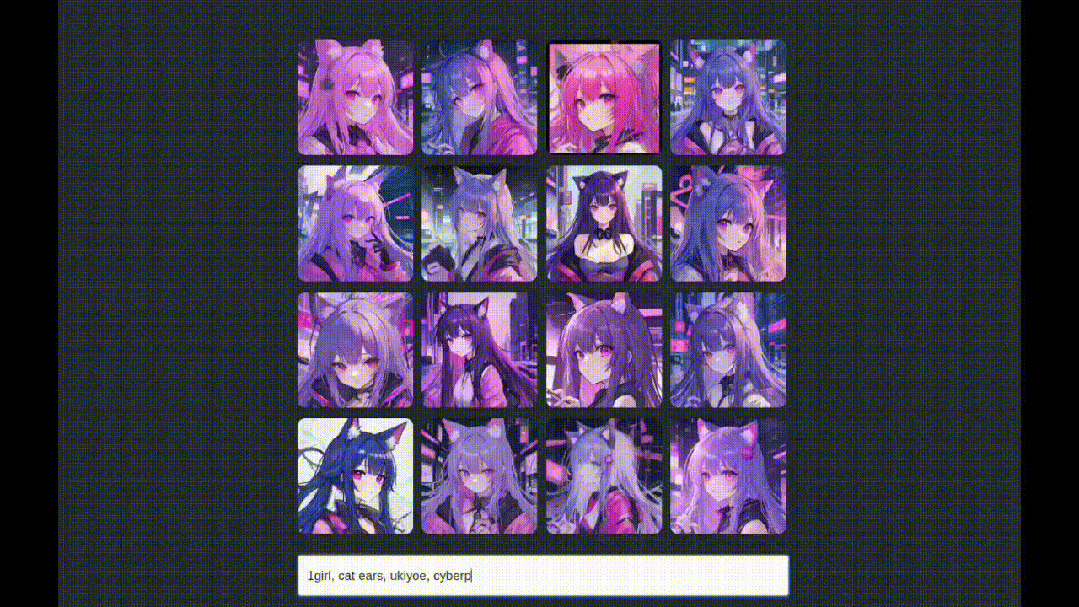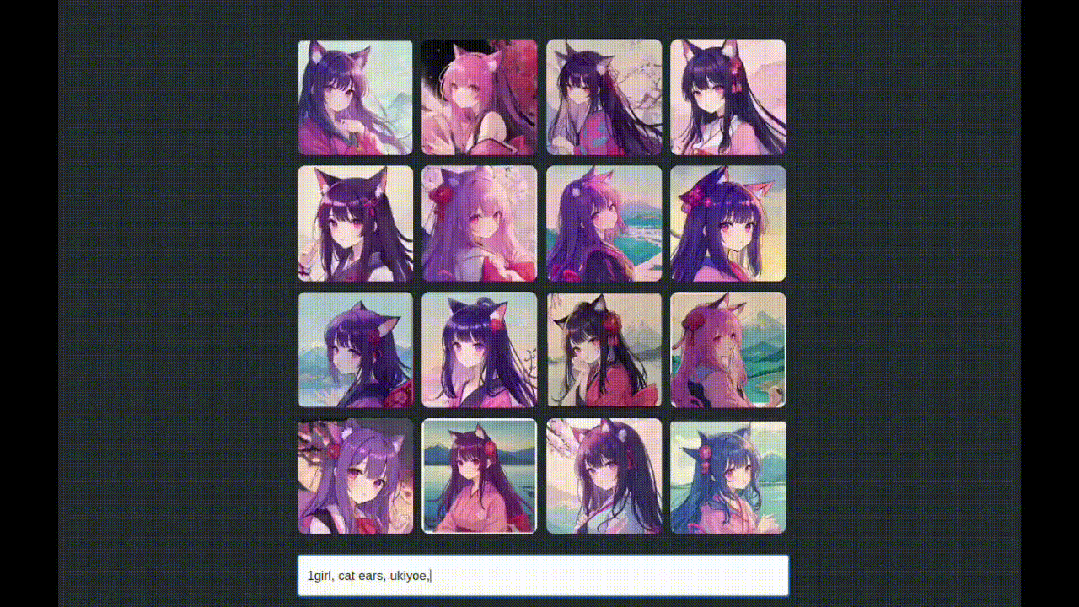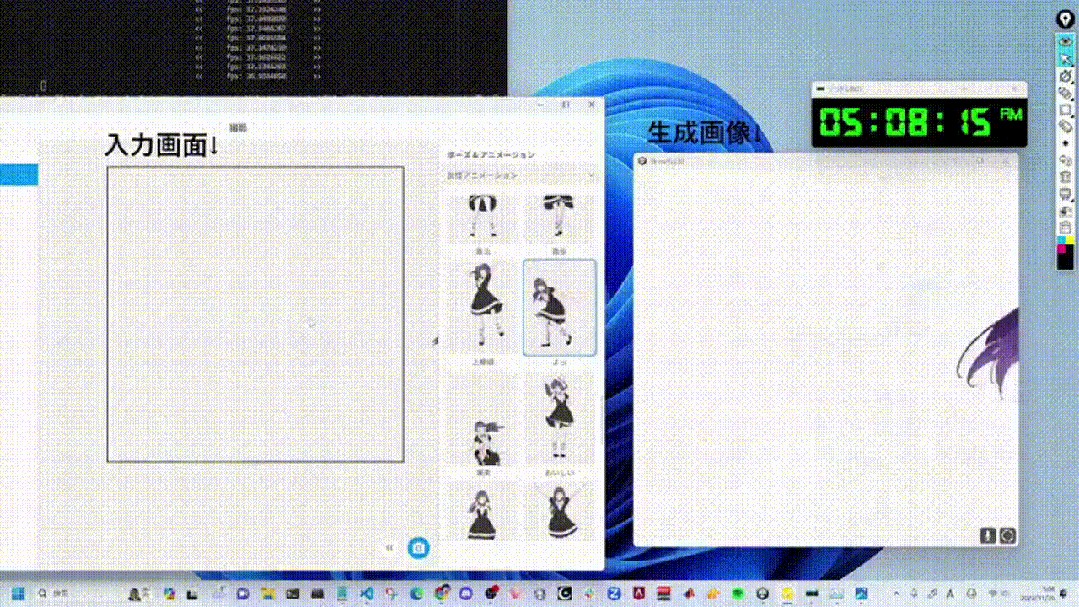 图片
如此惊人的图片实时生成速度,便是来自UC伯克利、日本筑波大学等研究人员提出StreamDiffusion带来的结果。
这个全新的解决方案是一种扩散模型流程,能够以超过100fps的速度,实现实时交互式图像生成。
 图片
论文地址:https://arxiv.org/abs/2312.12491
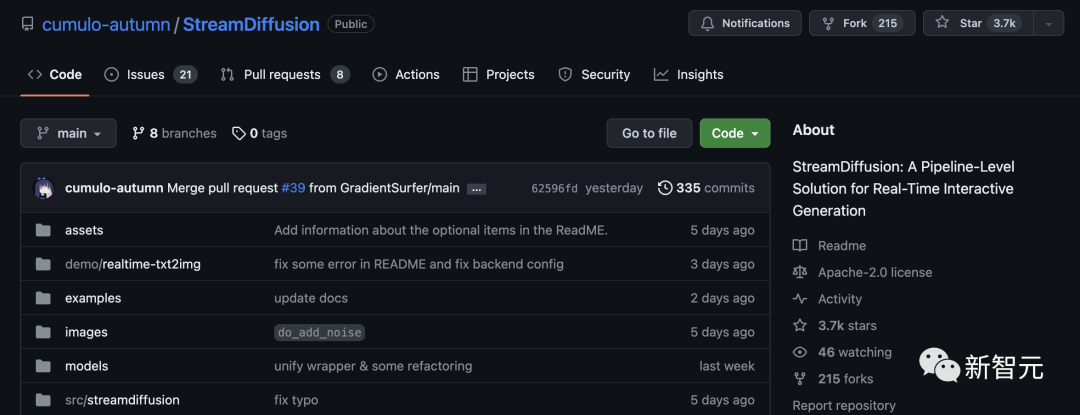
StreamDiffusion开源后直接霸榜GitHub,狂揽3.7k星。
 图片
StreamDiffusion创新性采用了批处理策略,而非序列去噪,比传统方法快大约1.5倍。而且作者提出的新型剩余无分类器引导(RCFG)算法能够比传统无分类引导快2.05倍。
最值得一提的是,新方法在RTX 4090上,图像到图像的生成速度可达91.07fps。
 图片
未来,在元宇宙、视频游戏图形渲染、|直播|视频流等不同场景中,StreamDiffusion快速生成能够满足这些应用的高吞吐量的需求。
尤其,实时的图像生成,能够为那些游戏开发、视频渲染的打工人们,提供了强大的编辑和创作能力。
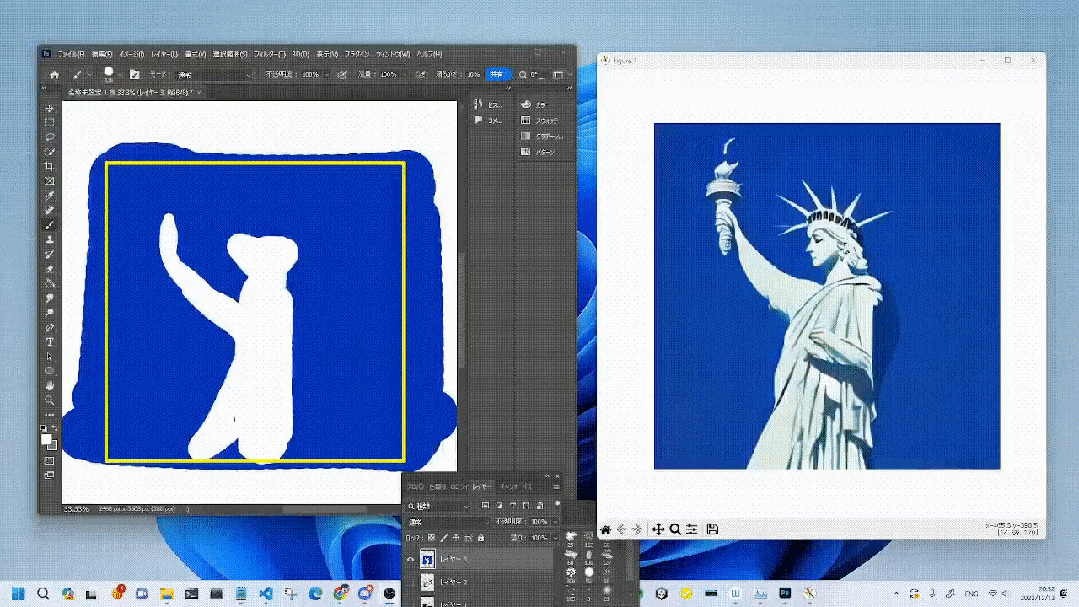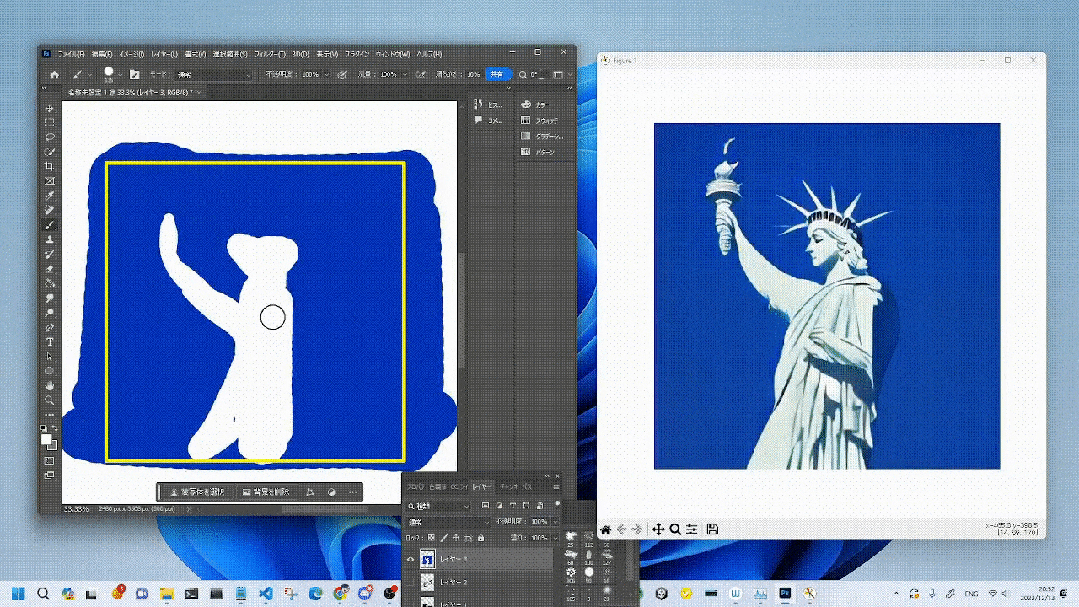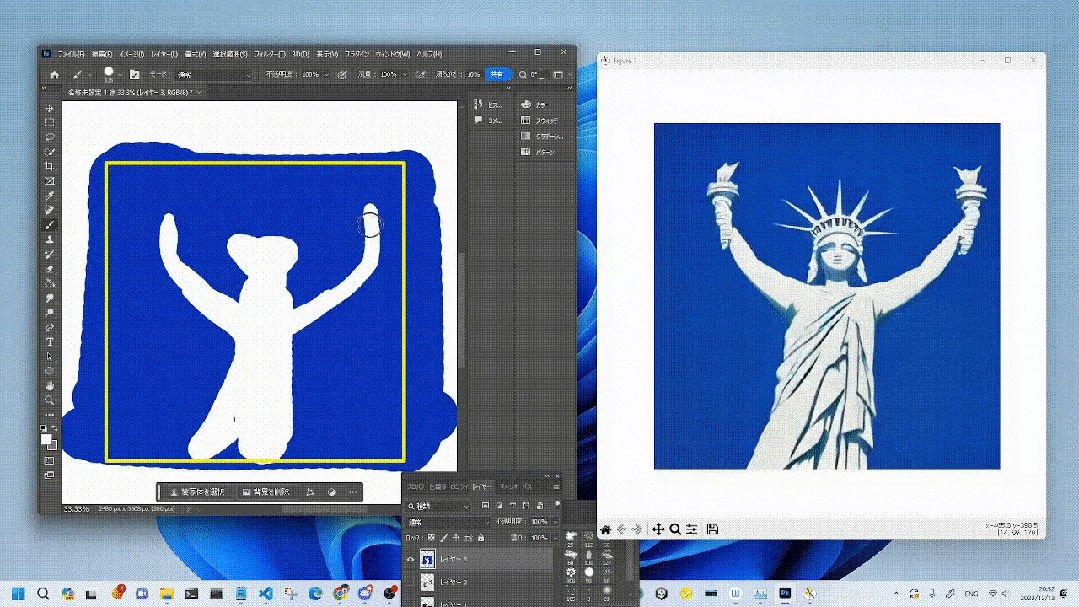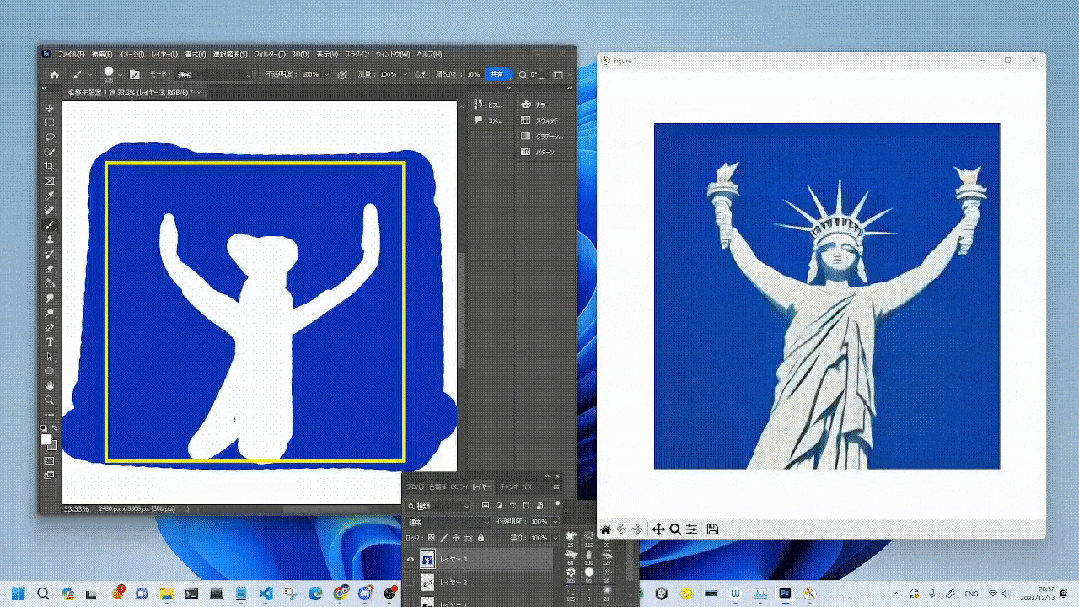 图片
目前,在各个领域中,扩散模型的应用需要具备高吞吐量和低延迟的扩散管道,以确保人机交互的高效性
一个典型的例子是,用扩散模型创建虚拟角色VTuber——能够对用户的输入做出流畅的反应。
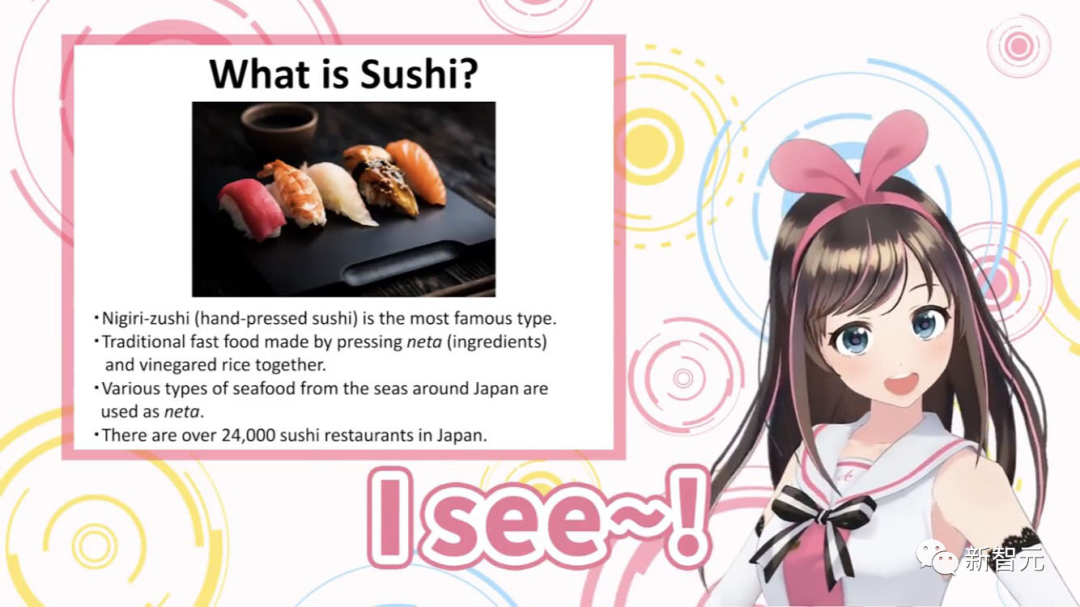 图片
为了提高高吞吐量和实时交互能力,目前研究的方向主要集中在,减少去噪迭代次数,比如从50次迭代减少到几次,甚至一次。
常见的策略是将多步扩散模型提炼成几个步骤,用神经常微分方程(ODE)重新构建扩散过程。为提高效率,也有人对扩散模型进行了量化。
最新论文中,研究人员从正交方向(orthogonal direction)开始,引入了StreamDiffusion——一种实时扩散管道,专为互动式图像生成的高吞吐量而设计。
现有的模型设计工作可以与StreamDiffusion集成,同时还可以使用N步去噪扩散模型,以保持高吞吐量,并为用户提供更灵活的选择
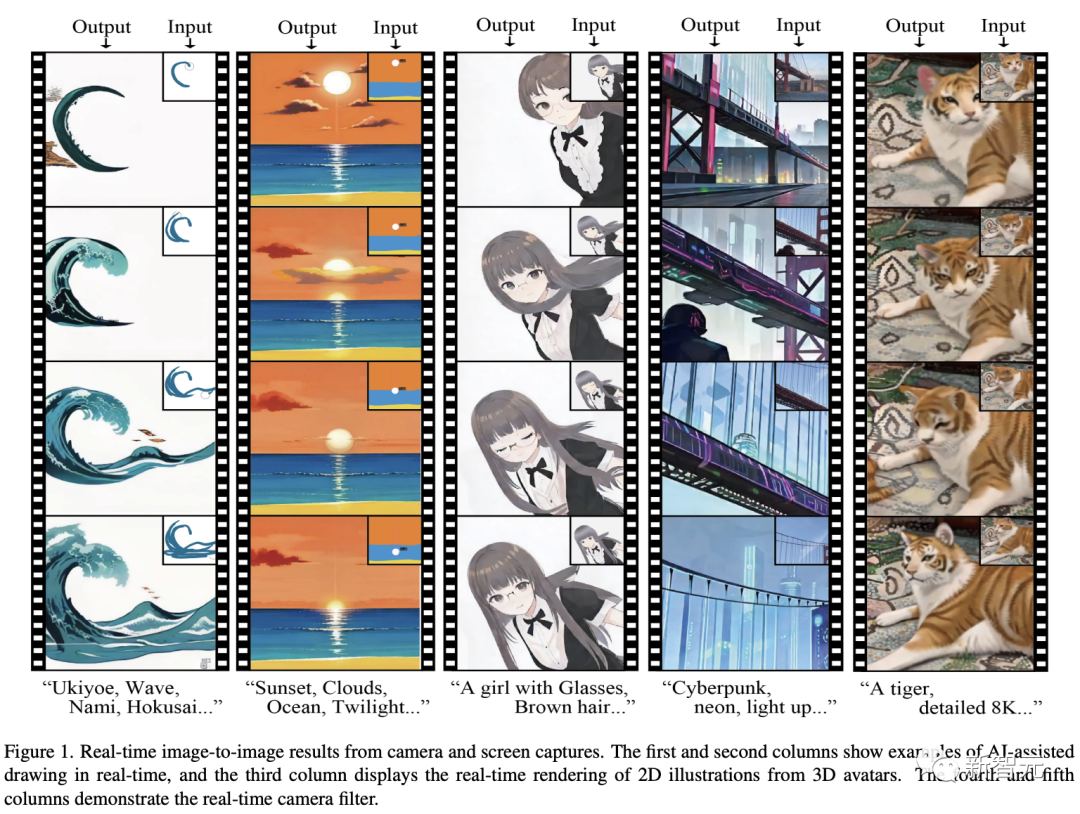 图片
实时图像生成|第一列和第二列:AI辅助实时绘图的示例,第三列:从3D头像实时渲染2D插图。第四列和第五列:实时相机滤镜。 实时图像生成|第一列和第二列展示了AI辅助实时绘图的示例,第三列展示了通过实时渲染3D头像生成2D插图的过程。第四列和第五列展示了实时相机滤镜的效果
具体是如何实现的?
StreamDiffusion是一种新的扩散管道,旨在提高吞吐量。
它由若干关键部分组成:
流批处理策略、剩余无分类器引导(RCFG)、输入输出队列、随机相似滤波(Stochastic Similarity Filter)、预计算程序、微型自动编码器的模型加速工具。
在扩散模型中,去噪步骤是按顺序进行的,这就导致了U-Net的处理时间,与步骤数成比例增加。
然而,为了生成高保真的图像,就不得不增加步数。
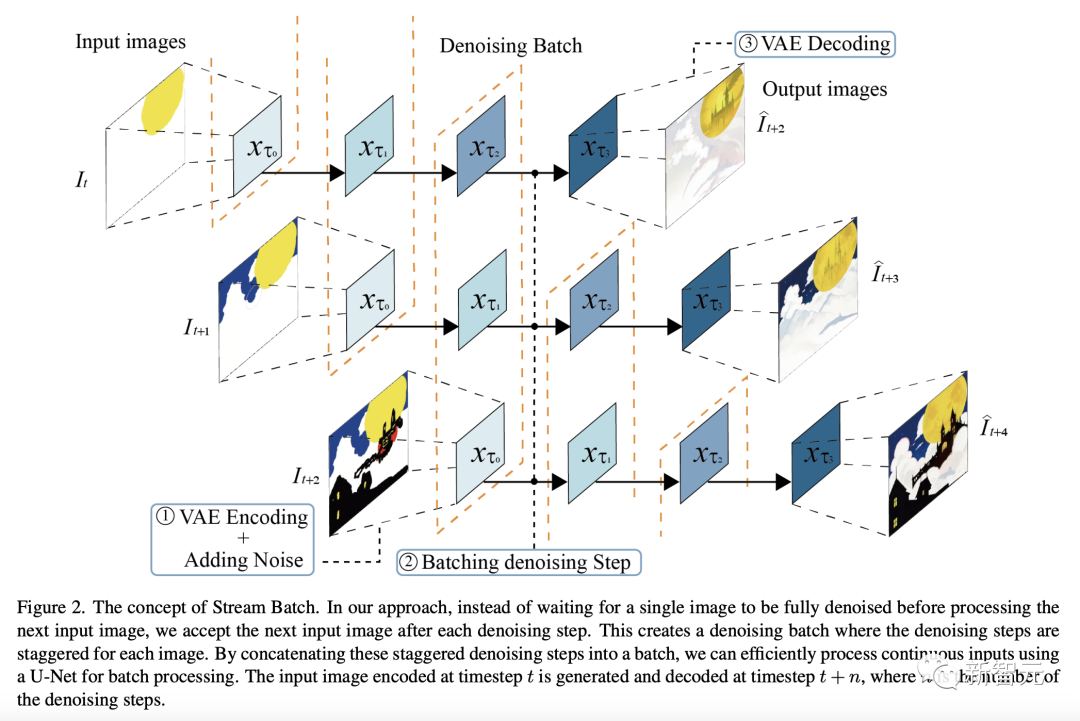
为了解决交互式扩散中的高延迟生成的问题,研究人员提出了一种叫做Stream Batch的方法。
如下图所示,在最新的方法中,在处理下一个输入图像之前,不会等待单个图像完全去噪,而是在每个去噪步骤后接受下一个输入图像。
这样就形成了一个去噪批次,每个图像的去噪步骤交错进行。
通过将这些交错的去噪步骤串联成一个批次,研究人员就能使用U-Net高效地处理连续输入的批次。
在时间步t处编码的输入图像在时间步t+n处生成并解码,其中n是去噪步骤的数目。
 图片
常见的无分类器指导(CFG)是一种,通过在无条件或否定条件项和原条件项之间执行向量计算。来增强原条件的效果的算法。
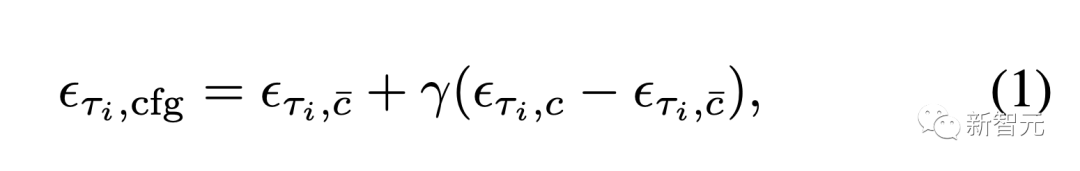 图片
这可以带来诸如加强提示的效果之类的好处。
然而,为了计算负条件剩余噪声,需要将每个输入潜变量与负条件嵌入配对,并在每个推理时间将其传递给U-Net。
为了解决这个问题,作者引入了一种创新的剩余无分类器引导(RCFG)
这种方法利用虚拟剩余噪声来逼近负条件,使得我们只需要在过程的初始阶段就能够计算负条件噪声,从而显著降低了负条件嵌入时额外的U-Net推理计算成本
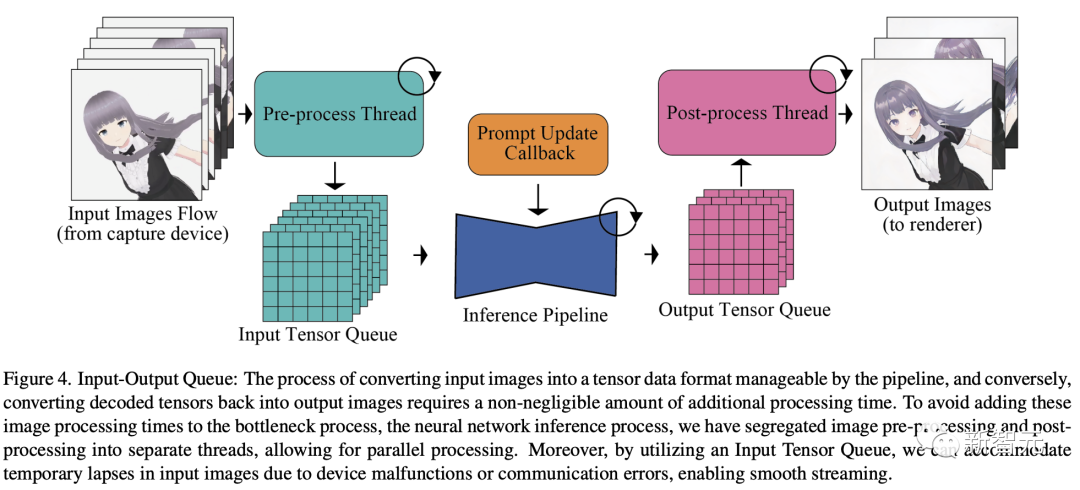
输入输出队列
将输入图像转换为管道可管理的张量数据格式,反过来,将解码后的张量转换回输出图像,都需要不可忽略的额外处理时间。
为了避免将这些图像处理时间添加到神经网络推理流程中,我们将图像预处理和后处理分离到不同的线程中,从而实现并行处理。
此外,通过使用输入张量队列,还能应对因设备故障或通信错误造成的输入图像临时中断,从而实现流畅的流式传输。
 图片
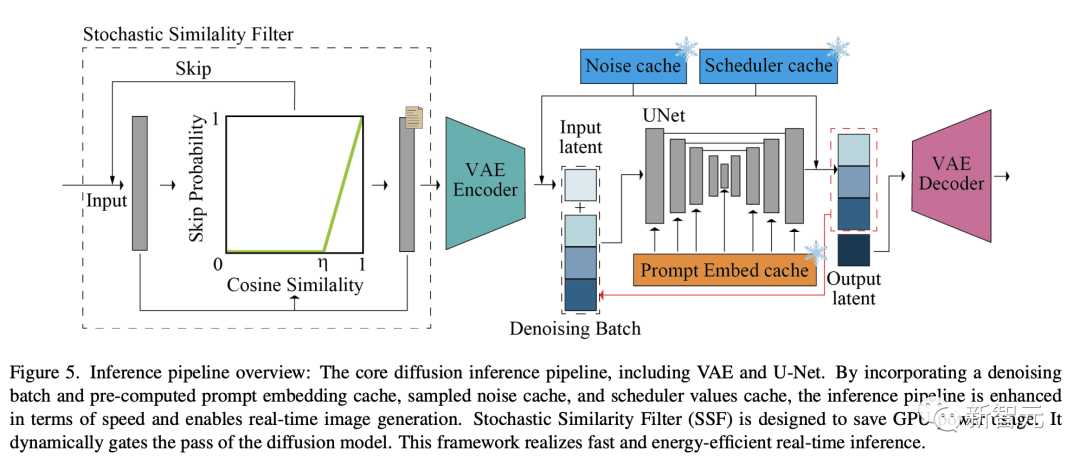
如下图是,核心扩散推理管道,包含VAE和U-Net。
通过引入去噪批处理和预先计算的提示嵌入缓存、采样噪声缓存和调度器值缓存,提高了推理流水线的速度,实现了实时图像生成。
随机相似滤波(SSF)是为了节省GPU功耗而设计的,可以动态关闭扩散模型管道,进而实现了快速高效的实时推理。
 图片
U-Net架构既需要输入潜在变量,也需要条件嵌入。
通常情况下,条件嵌入来源于「提示嵌入」,在不同帧之间保持不变。
为了优化这一点,研究人员预先计算提示嵌入,并将其存储在缓存中。在交互或流模式下,这个预先计算的提示嵌入缓存会被召回。
在U-Net中,每一帧的键和值的计算是基于预先计算的提示嵌入实现的
因此,研究人员对U-Net进行修改,以存储这些键和值对,使其可以重复使用。每当输入提示更新时,研究人员都会在U-Net内重新计算和更新这些键和值对。
为了优化速度,我们将系统配置为使用静态批大小和固定输入大小(高度和宽度)。
这种方法确保计算图和内存分配针对特定的输入大小进行优化,从而加快处理速度。
然而,这意味着如果需要处理不同形状的图像(即不同的高度和宽度),使用不同的批大小(包括去噪步骤的批次大小)。
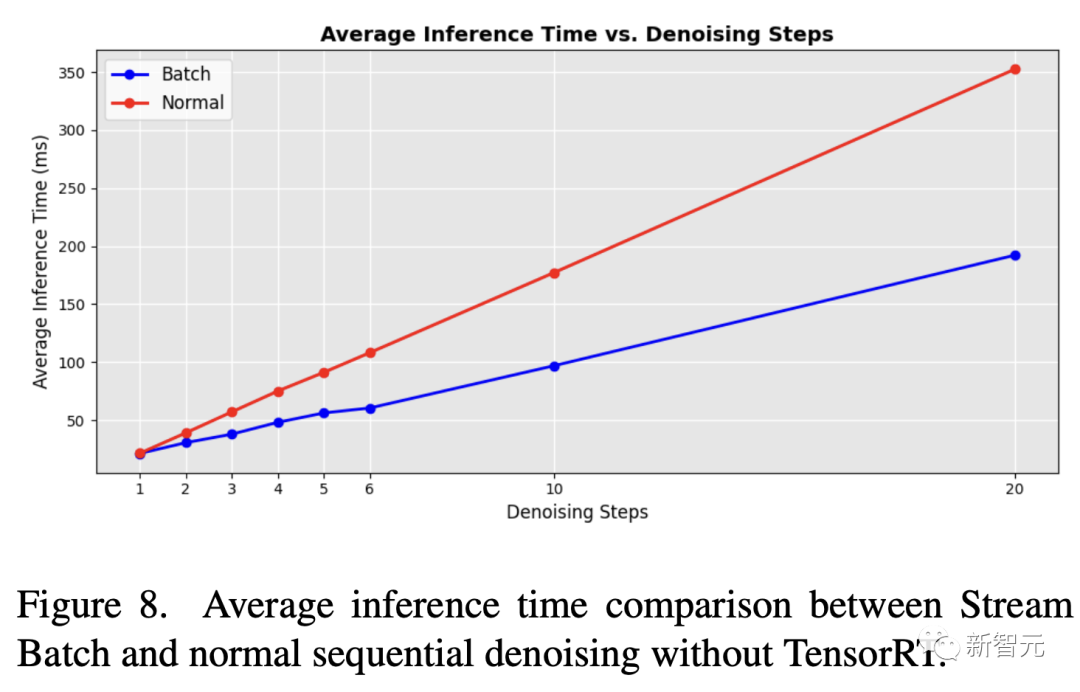
图8展示了批量去噪和原始顺序U-Net循环的效率比较
在实施批去噪策略时,研究人员发现处理时间有了显著改善。与顺序去噪步骤的传统U-Net循环相比,减少了一半的时间。
即使应用了神经模块加速工具TensorRT,研究人员提出的流批处理在不同的去噪步骤中仍能大幅提高原始顺序扩散管道的效率。
 图片
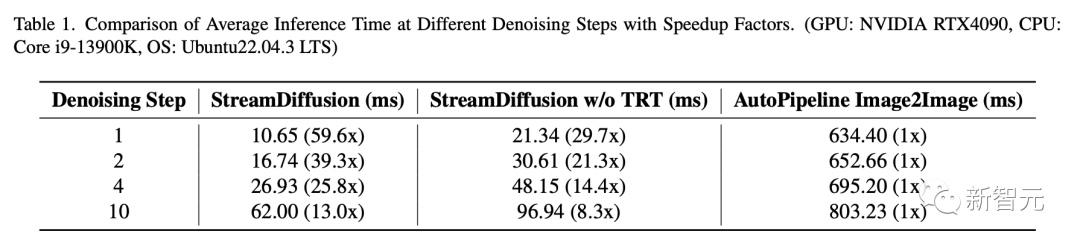
此外,研究人员还将最新方法与Huggingface Diffusers开发的AutoPipeline-ForImage2Image管道进行了比较。
平均推理时间比较见表1,最新管道显示速度有了大幅提升。
在使用TensorRT时,StreamDiffusion能够在运行10个去噪步骤时实现13倍的速度提升。而在只涉及单个去噪步骤的情况下,速度提升可达59.6倍
即使没有TensorRT,StreamDiffusion在使用单步去噪时也比AutoPipeline提高了29.7倍,在使用10步去噪时提高了8.3倍。
 图片
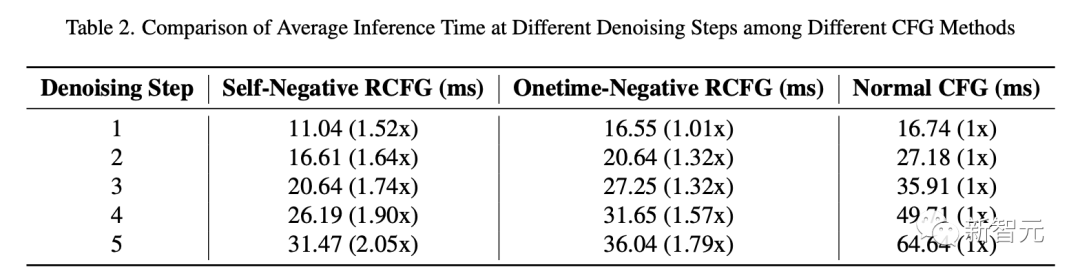
表2比较了使用RCFG和常规CFG的流扩散管道的推理时间。
在单步去噪的情况下,Onetime-Negative RCFG和传统CFG的推理时间几乎相同。
所以One-time RCFG和传统CFG在单步去噪时推理时间差不多。但是随着去噪步骤增加,从传统CFG到RCFG的推理速度提升变得更明显。
在第5步去噪时,Self-Negative RCFG比传统CFG快2.05倍,Onetime-Negative RCFG比传统CFG快1.79倍。
 图片
 图片
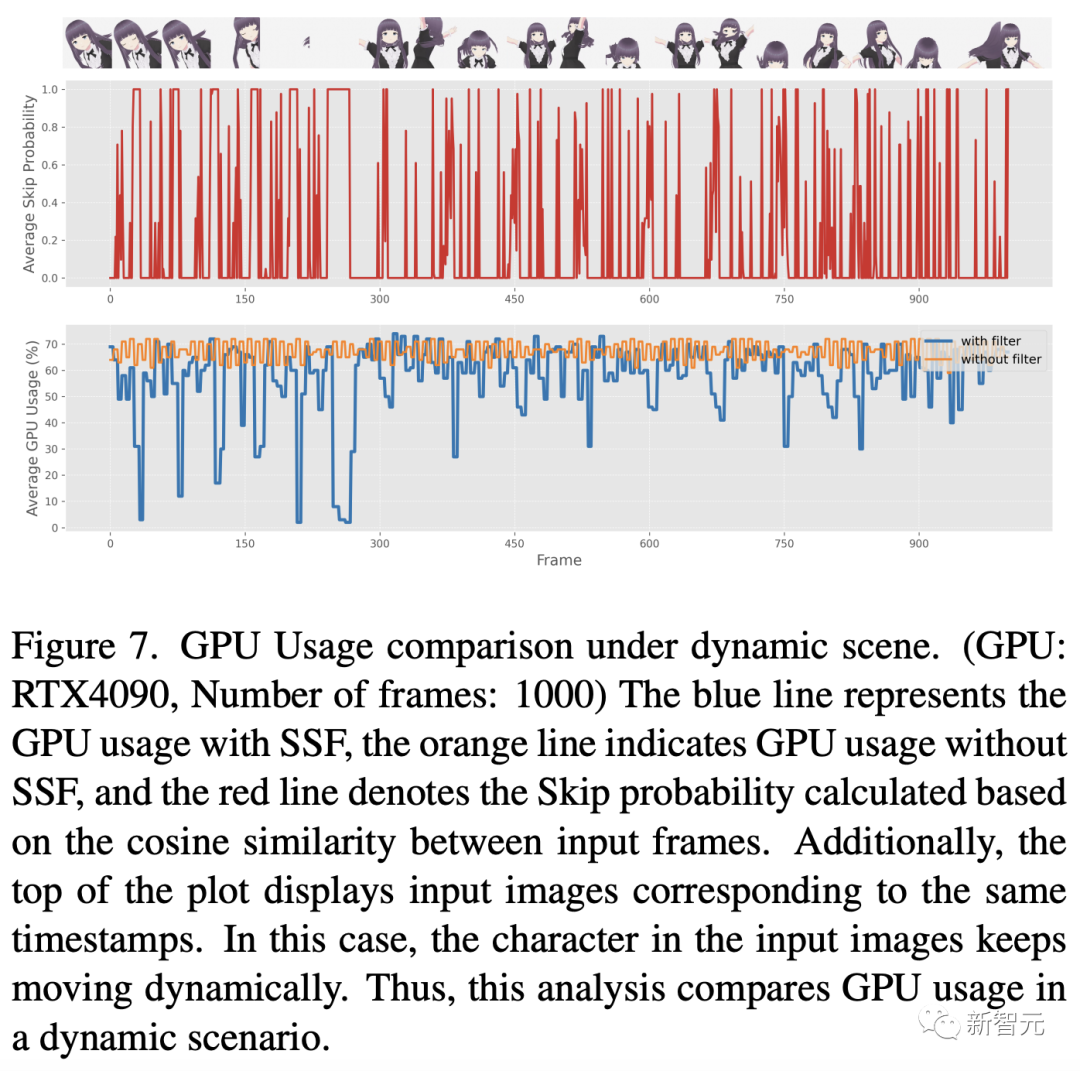
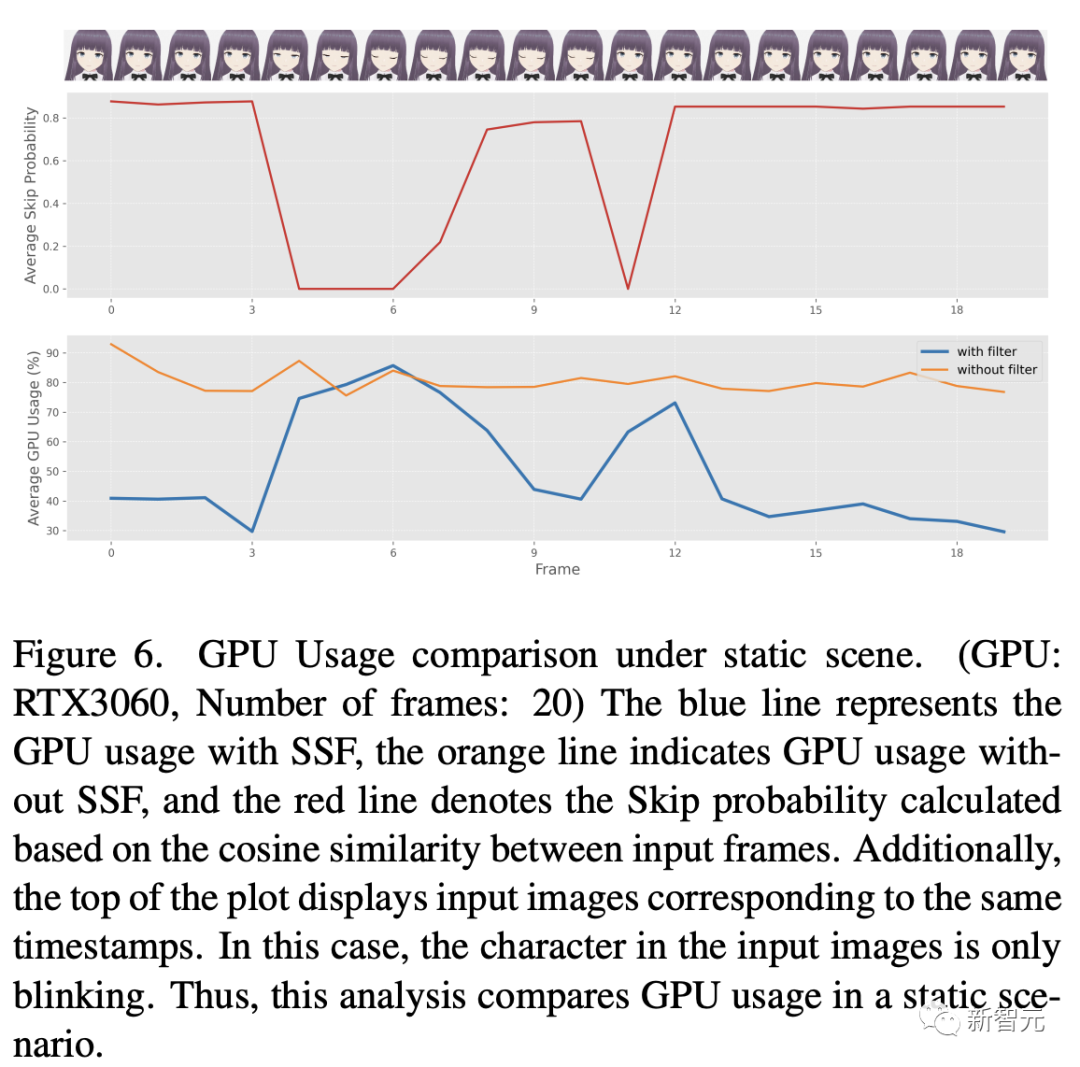
在此之后,研究人员对所提出的SSF的能耗进行了全面评估。这一过程的结果可以在图6和图7中看到
这些图展示了在输入视频中应用 SSF(将阈值η设为0.98)到包含周期性静态特征场景时GPU的使用模式
对比分析表明,在输入图像主要是静态图像且具有高度相似性的情况下,采用SSF可以显著降低GPU的使用率。
 图片
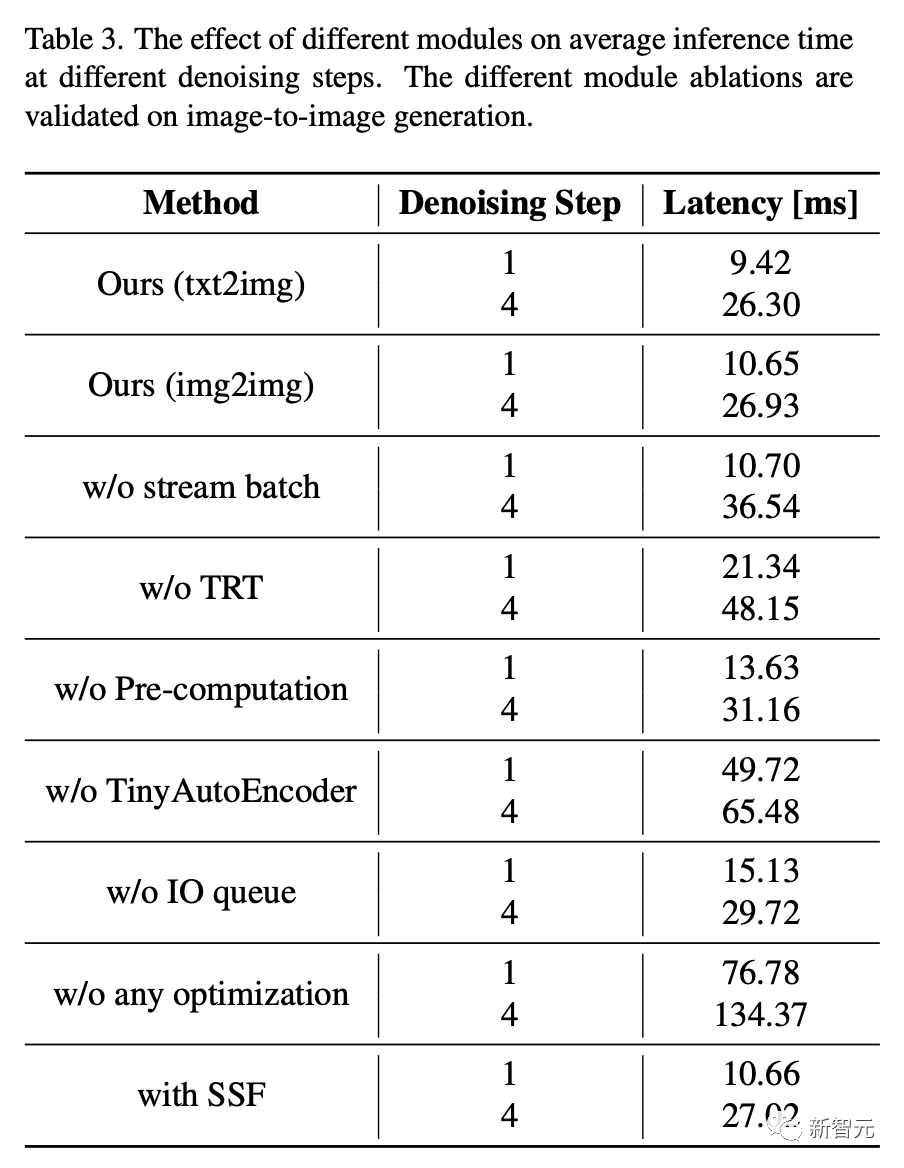
不同模块对不同去噪步骤下平均推理时间的影响如表3。可以看得见,不同模块的消减在图像到图像的生成过程中得到了验证。
 图片
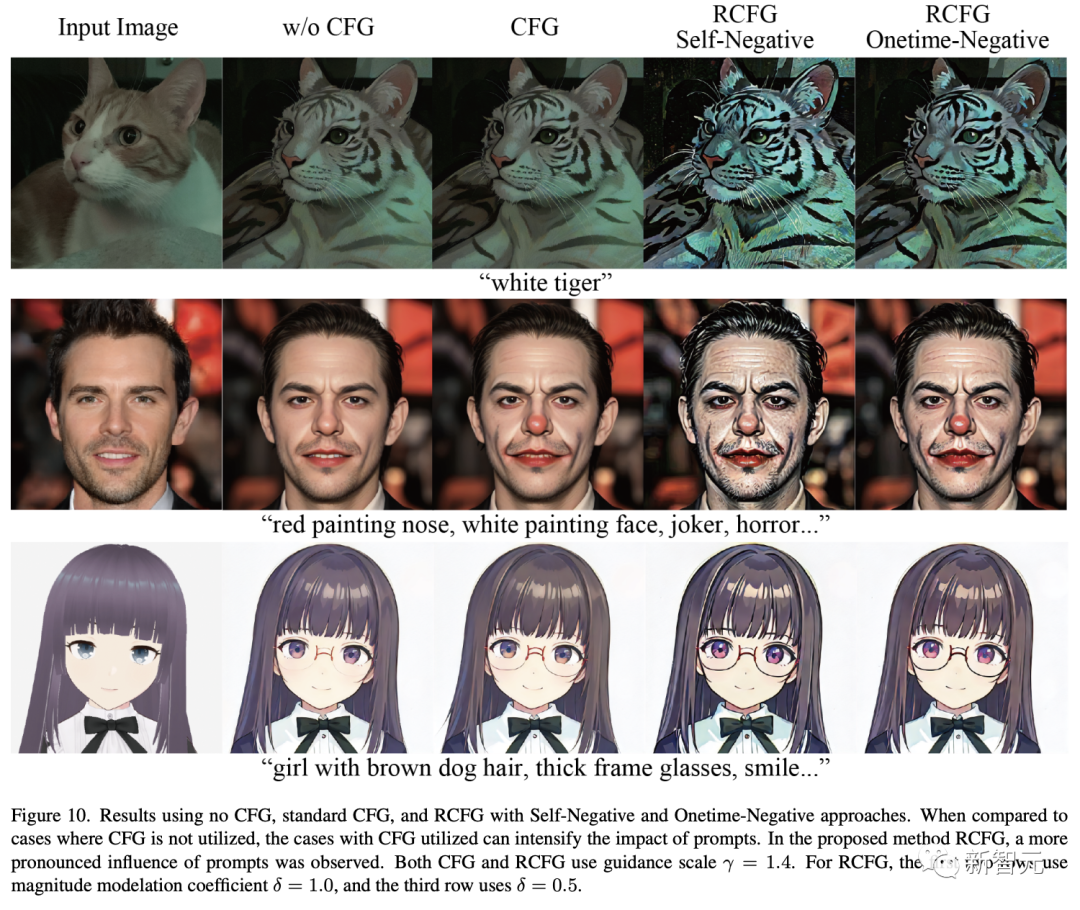
在图10中展示了使用剩余无分类器导引(RCFG)对生成的图像进行快速条件调整的对齐过程
生成的图像,没有使用任何形式的CFG,显示弱对齐提示,特别是在方面,如颜色变化或添加不存在的元素,这是没有得到有效实现。
相比之下,CFG或RCFG的使用增强了修改原始图像的能力,例如改变头发颜色,添加身体模式,甚至包含像眼镜这样的物体。值得注意的是,与标准CFG相比,RCFG的使用可以加强提示的影响。
 图片
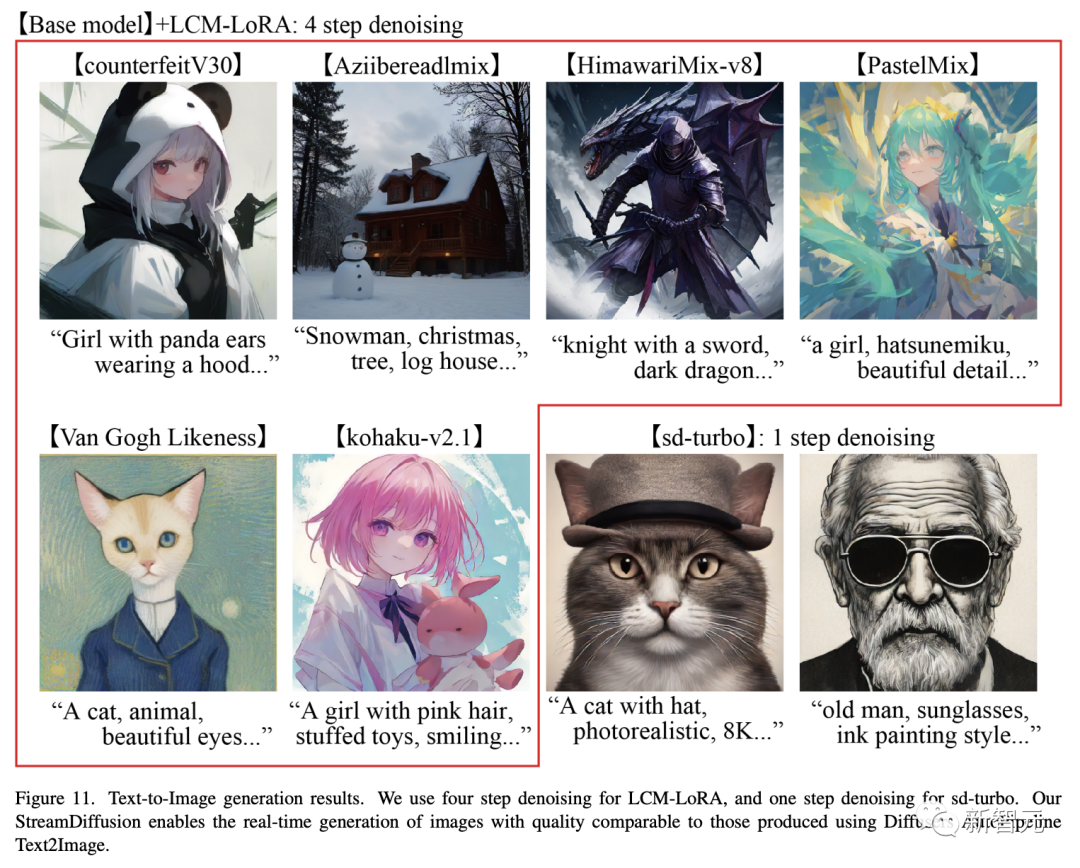
最后,标准文本到图像生成结果的质量如图11所示。
使用sd-turbo模型,只需一步就可以生成像图11所示的那样的高质量图像。
当在 GPU: RTX 4090,CPU: Core i9-13900K,OS: Ubuntu 22.04.3 LTS的环境中,使用研究人员提出的流扩散管道和sd-turbo模型生成图像时,以超100fps的速率生成这种高质量的图像是可行的。
 图片
最新项目的代码已经开源,在Github已经收揽3.7k星。
 图片
项目地址:https://github.com/cumulo-autumn/StreamDiffusion
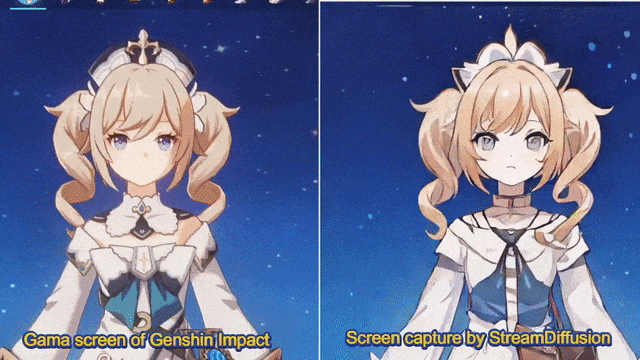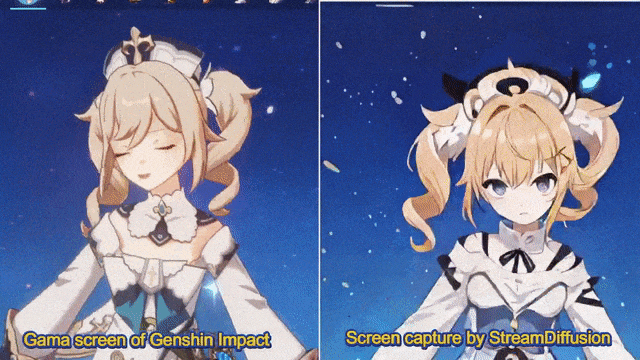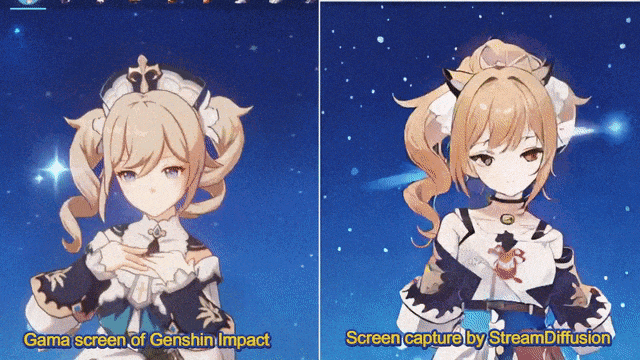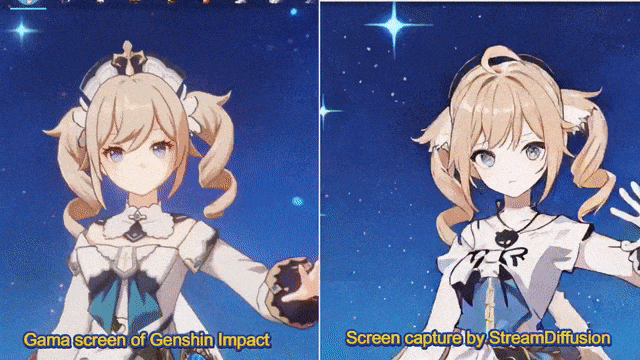
许多网友已经开始生成自己的二次元老婆了。
 图片
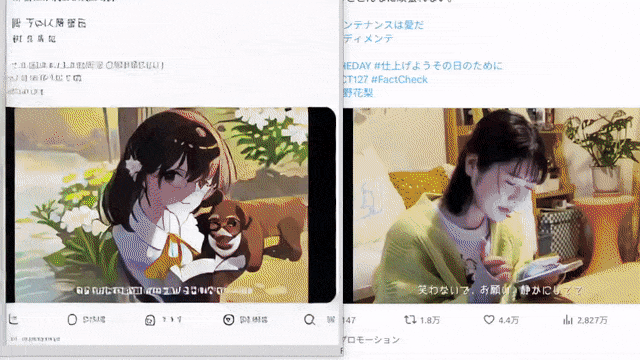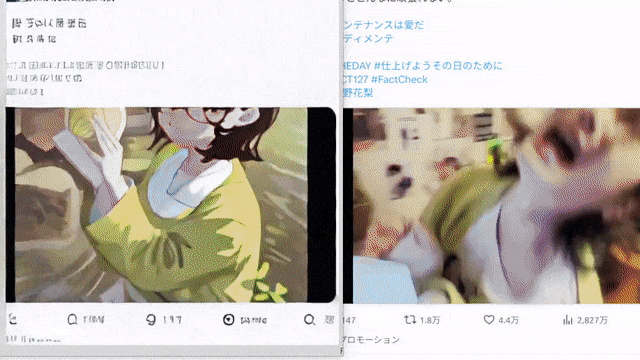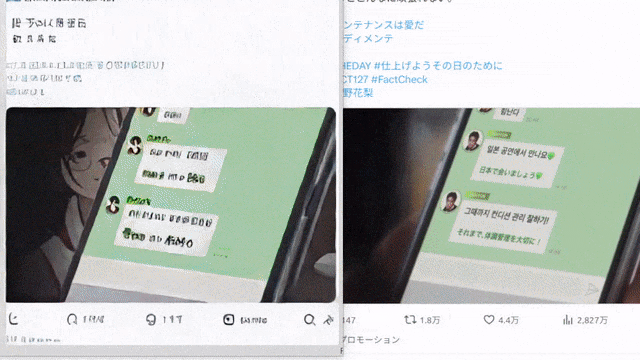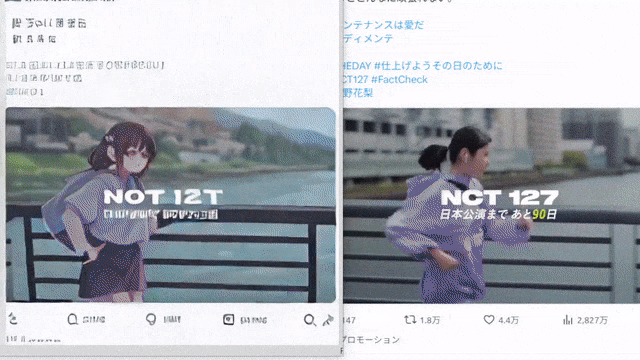
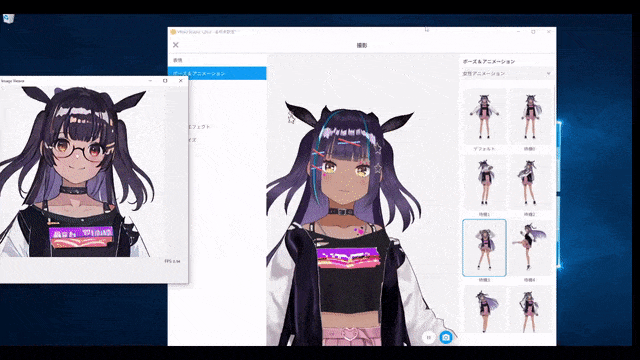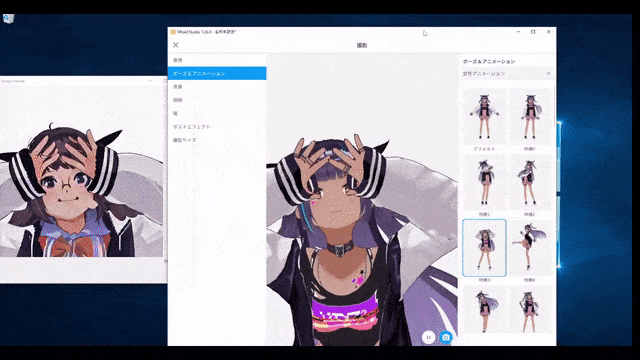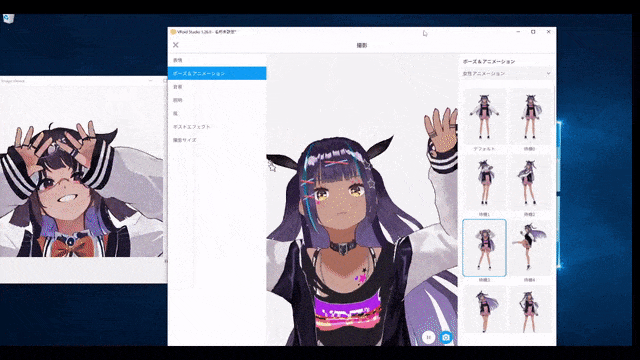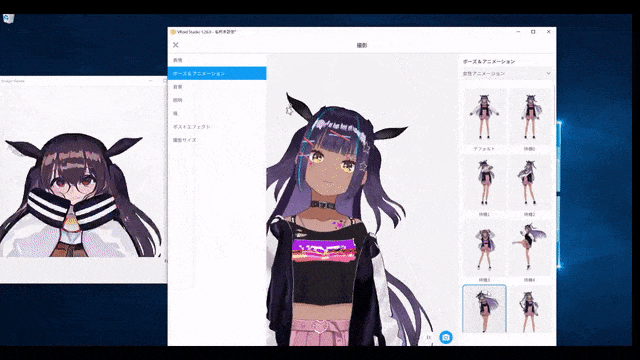
还有真人变实时动画。
 图片
10倍速手绘生成。
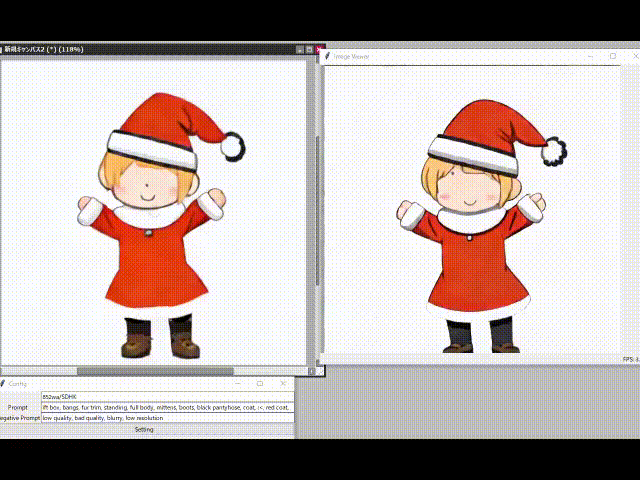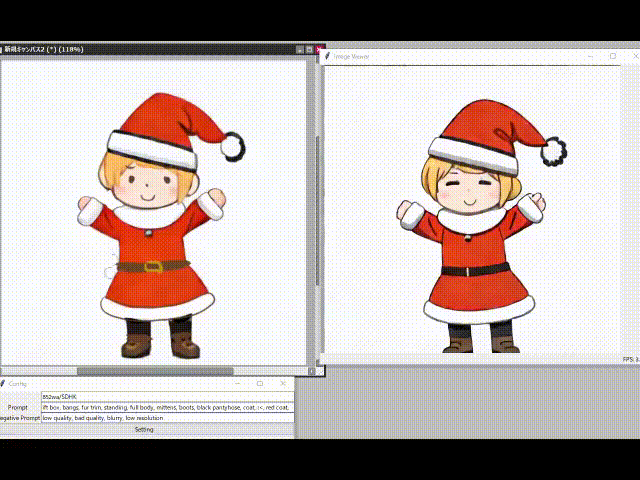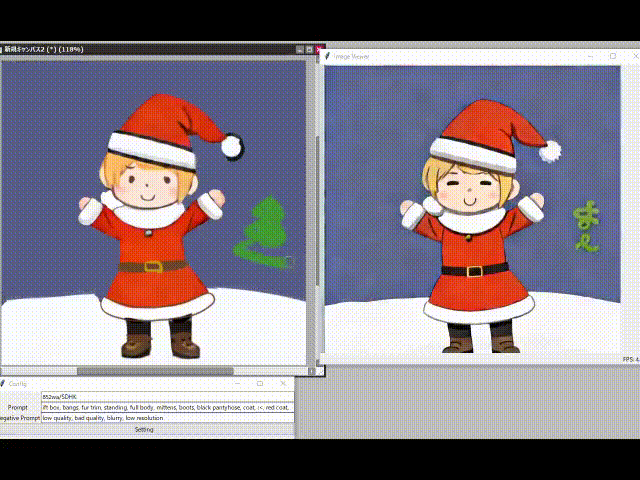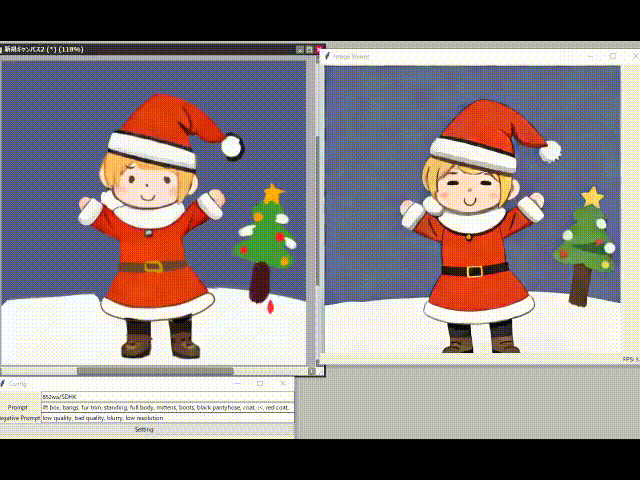 图片
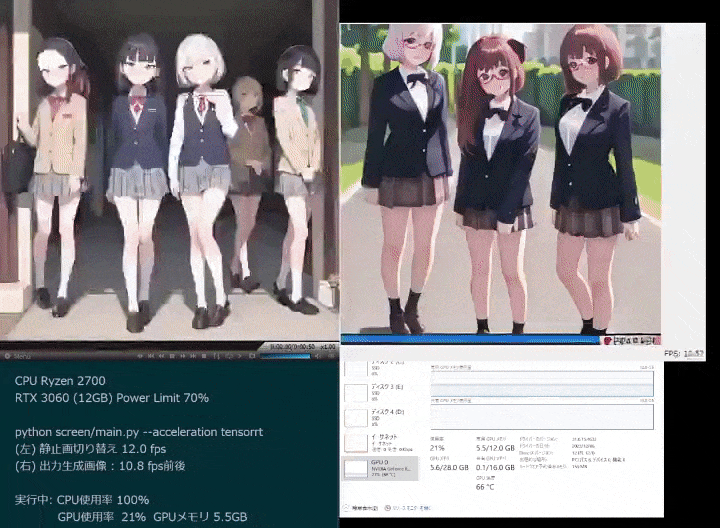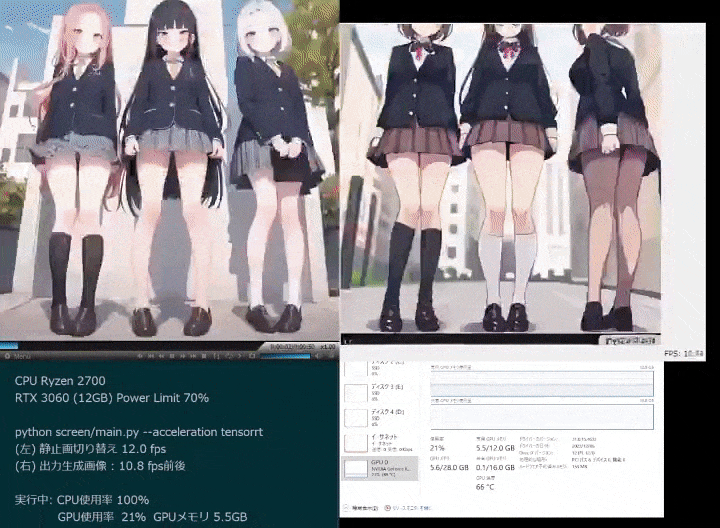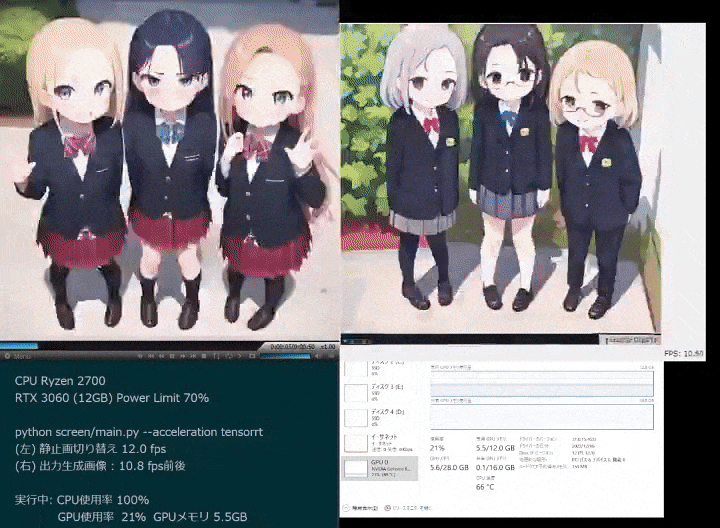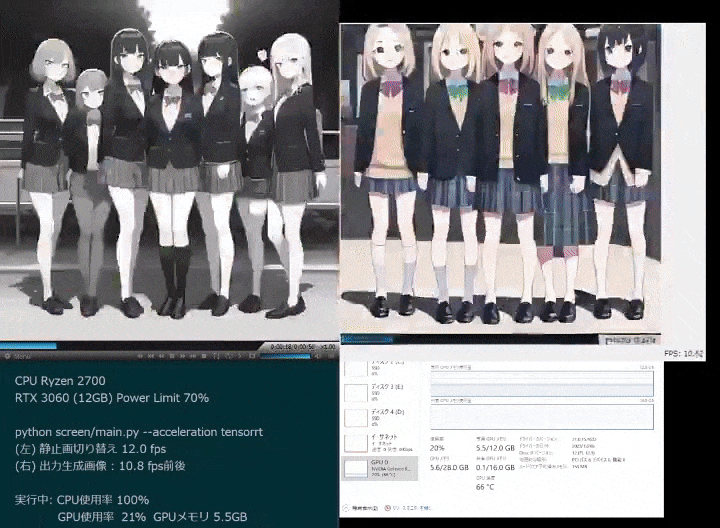 图片
 图片
感兴趣的童鞋们,不如自己动手吧。
参考资料:
 Scenario
一个AI生成游戏资产的工具
 56
查看详情

https://www.php.cn/link/f9d8bf6b7414e900118caa579ea1b7be
https://www.php.cn/link/75a6e5993aefba4f6cb07254637a6133
以上就是推出免费的个性化学术论文推荐系统——德国高校顶级视觉团队的「arXiv定制平台」的详细内容,更多请关注其它相关文章!
# 系统
# 推荐
# 德国
# 日本
# 中东
# 蒙古歌曲网站建设游戏
# 网络营销推广哪家负责做
# 眉山抖音seo搜索
# 情况下
# 所示
# 的是
# 滤镜
# 展示了
# 是一种
# 批处理
# 庄河外贸网站推广
# seo优化 网站体验
# 泰安彤彤seo
# 无锡网站优化靠谱么
# 新宜康 seo
# 巨野线上营销推广
# 门户网站推广技巧
相关栏目:
【
Google疑问12 】
【
Facebook疑问10 】
【
优化推广96088 】
【
技术知识133117 】
【
IDC资讯59369 】
【
网络运营7196 】
【
IT资讯61894 】
相关推荐:
第二届光合组织AI解决方案大赛赛果揭晓
数据显示:人工智能相关专业热度上升最快 考古、美术、生物医学工程等小众专业火了
猿辅导推出Motiff,整合三大AI功能,助力UI设计生产力革新
人工智能行业急缺人 AI人才年薪能达近42万元
360发布认知型通用大模型“360智脑4.0” 全面接入360全家桶
建立元宇宙产业联盟:移动、咪咕、华为、小米等加入
英伟达推出 L40S GPU,AI 推理性能超过 A100 约 1.2 倍
亚马逊确认今年不举办re:MARS人工智能大会
元宇宙迈入2.0时代,它和生成式人工智能有何关联吗?
美版贴吧8000小组自爆停摆!拒绝数据被谷歌OpenAI白嫖,CEO被网友骂翻:背刺第三方应用
组建团队,字节跳动要造机器人?
AI 冥想应用 Ogimi.ai 推出,可为用户提供教练级个性化指导
云米Smart 2E AI立式空调开启预售:新三级能效,到手价3899元
物联网“僵尸网络DDos攻击”增长惊人,威胁全球电信网络
OpenAI宣布组建新团队 以控制“超级智能”人工智能
微软更新服务协议,以防止通过AI服务进行逆向工程和数据抓取
从GOXR到PartyOn,XRSPACE致力打造多元共赢的元宇宙世界
特斯拉机器人面世 未来将大幅提振磁材需求,引领人工智能时代
AI遇上大运丨热身拉伸、娱乐K歌……AI智能健身镜将亮相成都大运会
6月14日《星空下的对话》 张朝阳陆川将畅聊人生、电影、心理学与AI
Moka发布AI原生HR SaaS产品“Moka Eva”,布局AGI时代
AIGC浪潮下,联想集团再加码计算与人工智能
0代码微调大模型火了,只需5步,成本低至150块
独家视角:首次展示有人与无人协同打击的7000米高空察打一体无人机
微软在德国举办MR研讨会,向女性分享元宇宙潜力
华为推出两款商用 AI 大模型存储新品,支持 1200 万 IOPS 性能
衡水市冀州中学机器人社团在世界机器人大赛中斩获佳绩
猿编程参加人工智能高峰论坛,推动人工智能教育解决方案在千所学校推行
看似低调,实则稳健:字节在AI路上会遇到什么?
AI数字人业务频频获点赞,谦寻积极引领示范作用
英国前首相:AI可能被用来制造“生物恐怖武器”
张勇对话多位诺奖得主 人工智能将无处不在
人工智能在交通领域的革新:智能解决方案彻底改变交通方式
两小时就能超过人类!DeepMind最新AI速通26款雅达利游戏
一次购买全年省心,入手科沃斯这几台机器人,省下时间就是金钱
WAIC 2025|云深处科技绝影Lite3与X20四足机器人亮相
通用医疗人工智能如何革新医疗行业?
周鸿祎:360智脑开放API接口 AI大模型将赋能百行千业
大疆 Air 3 无人机售价和实物照片曝光
吉林首例!机器人辅助下搭桥手术成功实施
美图设计室2.0新增哪些功能
机构:边缘AI或是当前预期差最大的AI方向
阿里大文娱CTO郑勇:生成式AI将引发内容行业巨变,*制作机会挑战并存
华为推出全新操作系统HarmonyOS 4,AI和新引擎完美融合
马斯克:将来机器人比人类多!特斯拉机器人亮相人工智能大会
导演郭帆:人工智能应用可能会影响《流浪地球 3》的创作开发
用AI升级会议体验!思必驰多款会议产品亮相全球智博会!
优地网络助力新媒体拥抱人工智能时代
Nature发AIGC禁令!投稿中视觉内容使用AI的概不接收
国内首家,360智脑通过中国信通院可信AIGC大语言模型功能评估
2023-12-27

运城市盐湖区信雨科技有限公司是一家深耕海外推广领域十年的专业服务商,作为谷歌推广与Facebook广告全球合作伙伴,聚焦外贸企业出海痛点,以数字化营销为核心,提供一站式海外营销解决方案。公司凭借十年行业沉淀与平台官方资源加持,打破传统外贸获客壁垒,助力企业高效开拓全球市场,成为中小企业出海的可靠合作伙伴。
