☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜

AIxiv专栏是本站发布学术、技术内容的栏目。 过去几年,本站AIxiv专栏接收报道道约2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道邮箱。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com。
近期,多模态大模型(MLLM)在文本中心的VQA领域取得了显著进展,尤其是多个闭源模型,例如:GPT4V 和 Gemini,甚至在某些方面展现了超越人类能力的表现。但是,开源模型的性能还远远落后于闭源模型,最近许多开创性的研究,例如:MonKey、LLaVAR、TG-Doc、ShareGPT4V 等已经开始关注指令微调数据不足的问题。尽管这些努力取得了显著的效果,但仍存在一些问题,图像描述数据和 VQA 数据属于不同的领域,图像内容呈现的粒度和范围存在不一致性。此外,合成数据的规模相对较小,使得 MLLM 无法充分发挥潜力。
论文标题:TextSquare: Scaling up Text-Centric Visual Instruction Tuning
论文地址:https://arxiv.org/abs/2404.12803
为了减少这一
VQA 数据生成
Square+ 策略方法包括四个步骤:自问 (Self-Questioning)、回答 (Self-Answering)、推理 (Self-Reasoning) 和评估 (Self-Evaluation)。Self-Questioning 利用MLLM 在文本图像分析和理解方面的能力生成与图像中文本内容相关的问题。Self-Answering 利用各种提示技术,如:思维链 CoT 和少样本,提供回答这些问题。Self-Reasoning 利用MLLMs 强大的推理能力,生成模型背后的推理过程。Self-Evaluation 评估问题的有效性、与图像文本内容的相关性以及答案的准确性,从而提高数据质量并减少偏见。
基于 Square 方法,研究者从各种公共来源收集了一组多样化的含有大量文本的图像,包括自然场景、图表、表单、收据、书籍、PPT、PDF 等构建了 Square-10M,并基于这个数据集训练了以文本理解为中心的 MLLM TextSquare-8B。
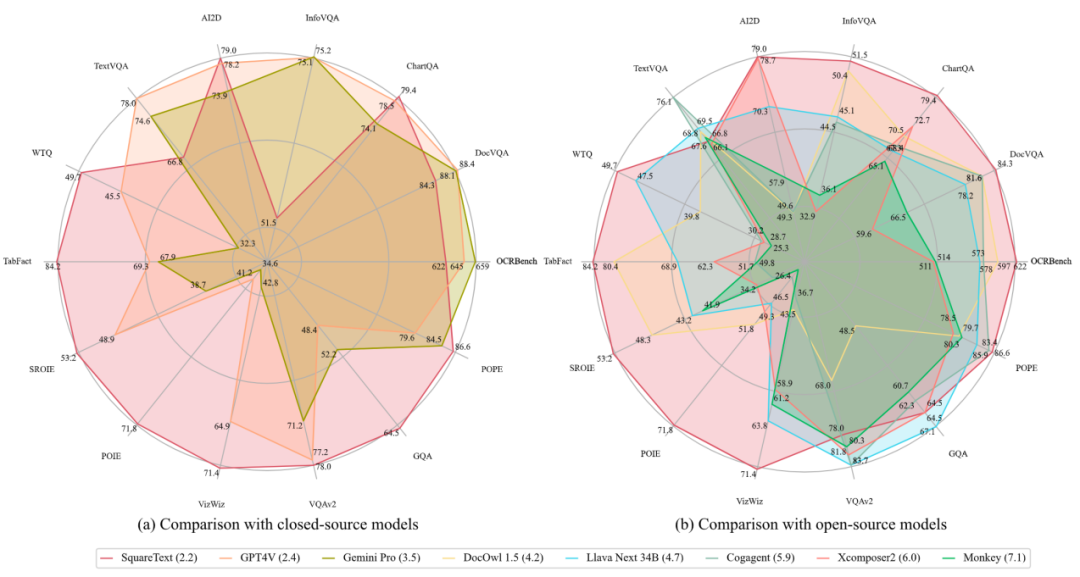
如图 1 所示,TextSquare-8B 在多个 benchmark 可取得与 GPT4V 和 Gemini 相媲美或更优的效果,并显著超过了其他开源模型。TextSquare 实验验证了推理数据对 VQA 任务的积极影响,证明了其能够在减少幻觉的同时提升模型性能。
此外,通过利用大规模的数据集,揭示了指令调整数据规模、训练收敛损失和模型性能之间的关系。尽管少量的指令调整数据可以很好地训练 MLLM,随着指令调整数据的不断扩大,模型的性能能得到进一步增长,指令微调数据和模型之间也存在着相对应的 scaling law。
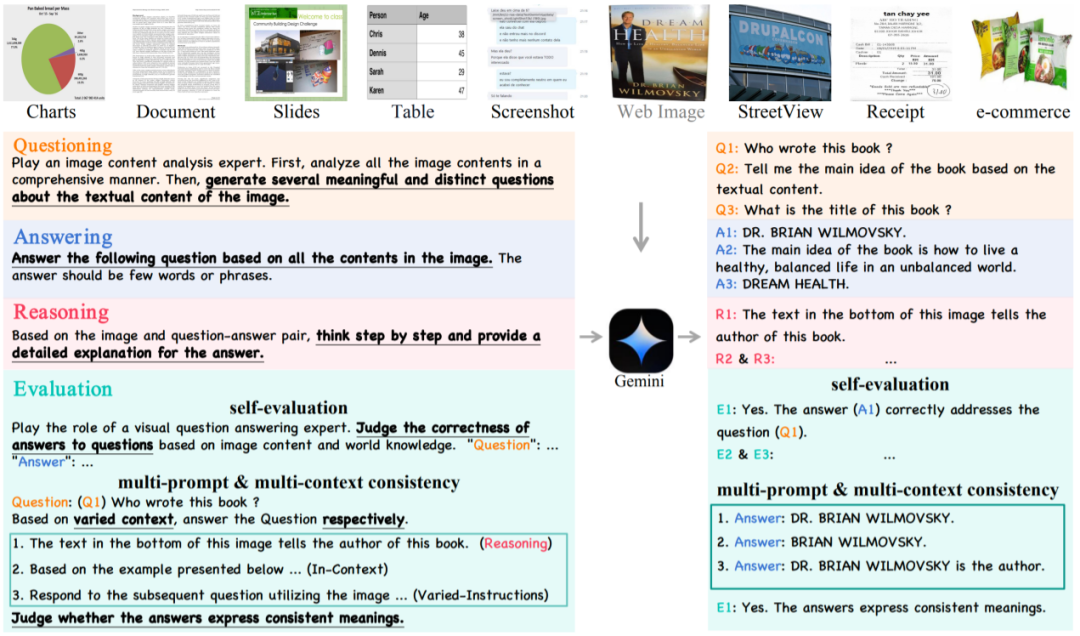
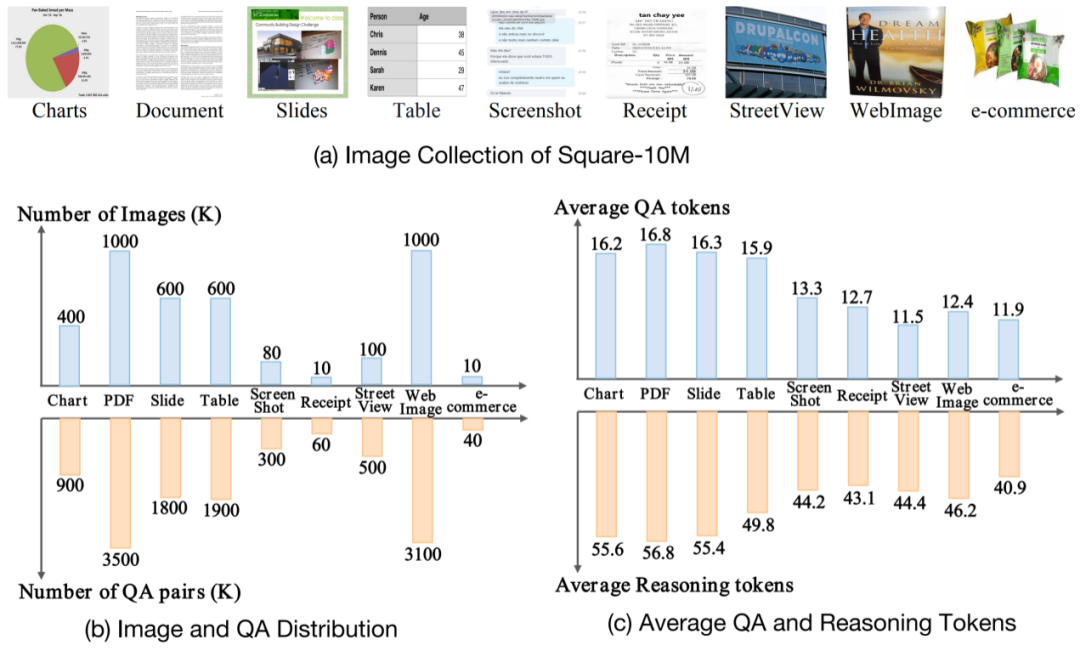
图 3 Square-10M 的图像分布和 QA 分布等详细情况
数据收集
数据收集策略 的主要目标是涵盖广泛的现实世界文本丰富的场景。为此,研究者收集了 380 万张的富文本的图像。这些图像表现出不同的特性,例如,图表和表格侧重于具有密集统计信息的文本元素;PPT、屏幕截图和 WebImage 是为文本和突出视觉信息之间的交互而设计的;文档 / PDF、收据和电子商务包含具有精细和密集文本的图像;街景源于自然场景。收集到的图像形成了现实世界中文本元素的映射,并构成了研究以文本为中心的 VQA 的基础。
数据生成
研究者利用 Gemini Pro 的多模态理解能力从特定数据源选择图像,并通过自问、自答、自我推理三个阶段生成 VQA 及推理上下文对。
Self-Question: 这个阶段会给定一些 prompt,Gemini Pro 会根据这些提示对图像进行全面分析,并根据理解去生成一些有意义的问题。考虑到通用 MLLM 对文本元素的理解能力通常会比视觉模型弱,我们通过专门的 OCR 模型将提取的文本预处理到 prompt 中去。
Self-Answering: Gemini Pro对生成问题会利用思维链 (CoT) 和少样本提示 (few-shot prompting) 等技术丰富上下文信息,提高生成答案的可靠性。
Self-Reasoning: 这个阶段会生成答案的详细原因,迫使 Gemini Pro 更多的思考问题和视觉元素之间的联系,从而减少幻觉并提高准确的答案。
数据过滤
尽管自我提问、回答和推理是有效的,但生成的图像 - 文本对可能面临幻觉内容、无意义问题和错误答案。因此,我们设计了基于 LLM 的评估能力的过滤规则,以选择高质量的 VQA 对。
Self-Evaluation 提示 Gemini Pro 和其他 MLLMs 判断生成的问题是否有意义,以及答案是否足以正确解决问题。
Multi-Prompt Consistency 除了直接评估生成的内容外,研究者还在数据生成中手动增加提示和上下文空间。当提供不同的提示时,一个正确且有意义的 VQA 对应该在语义上一致。
Multi-Context Consistency 研究者通过在问题前准备不同的上下文信息来进一步验证 VQA 对。
TextSquare-8B
TextSquare-8B 借鉴了 InternLM-Xcomposer2 的模型结构,包括 CLIP ViT-L-14-336 的视觉 Encoder,图像分辨率进一步提升至 700;基于 InternLM2-7B-ChatSFT 的大语言模型 LLM;一个对齐视觉和文本 token 的桥接器 projector。
TextSquare-8B 的训练包括三阶段的 SFT:
第一阶段,以 490 的分辨率全参数 (Vision Encoder, Projector, LLM) 微调模型。
第二阶段,输入分辨率增加到 700,只训练 Vision Encoder 以适应分辨率变化。
 Canva AI
Canva平台AI图片生成工具
 1374
查看详情

第三阶段,进一步以 700 的分辨率进行全参数微调。
TextSquare 证实,在 Square-10M 数据集的基础上,具有 8B 参数和正常大小图像分辨率的模型可以在以文本为中心的 VQA 上实现超过了大多数的 MLLM,甚至是闭源模型 (GPT4V、Gemini Pro) 的效果。
实验结果
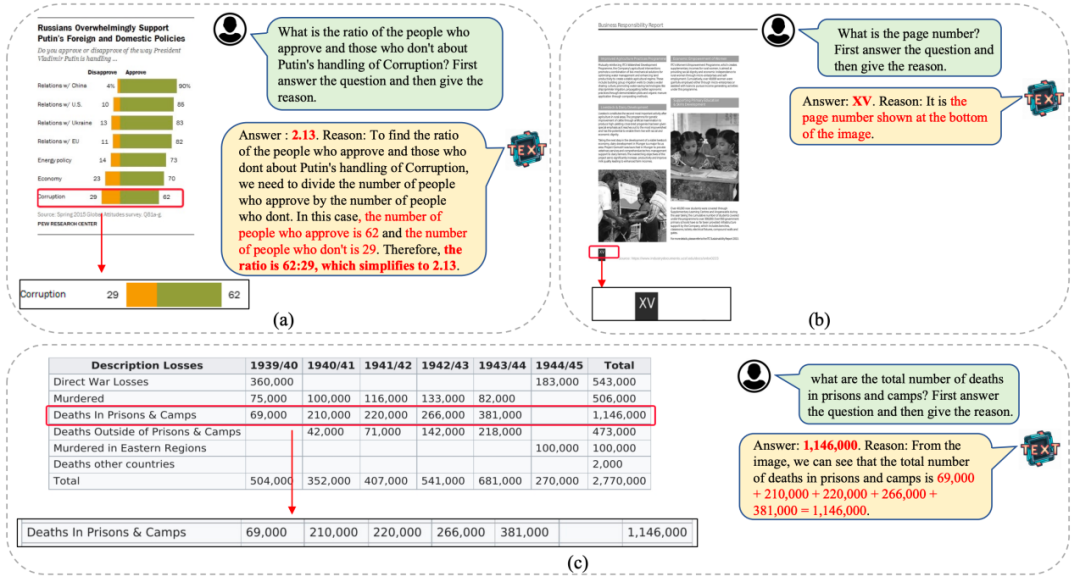
图 4(a)显示 TextSquare 具有简单的算术功能。图 4(b)显示了理解文本内容并在密集文本中提供大致位置的能力。图 4(c)显示了 TextSquare 对表格结构的理解能力。
MLLM Benchmark
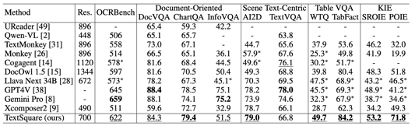
Document-Oriented Benchmark 在文档场景的 VQA Benckmark (DocVQA、ChartQA、InfographicVQA) 上平均提升 3.5%,优于所有开源模型,在 ChartQA 数据集上略高于 GPT4V 和 Gemini Pro,该模型分辨率仅 700,小于大多数面向文档的 MLLM,如果分辨率进一步提高,相信模型性能也将进一步提高,Monkey 已证明这一点。
Scene Text-centric Benchmark 自然场景的 VQA Benchmark (TextVQA、AI2D) 中取得了 SOTA 的效果,但与 baseline Xcomposer2 相比没有较大改进,可能是因为 Xcomposer2 已经用了高质量的域内数据进行了充分优化。
Table VQA Benchmark 表格场景的 VQA Benchmark (WTQ、TabFact) 中取得到远超 GPT4V 及 Gemini Pro 的效果,分别超过其他 SOTA 模型 3%。
Text-centric KIE Benchmark 文本中心的关键信息提取 KIE 任务的 benchmark (SROIE、POIE),将 KIE 任务转换成 VQA 任务,在两个数据集都取得了最佳的性能,平均提升 14.8%。
OCRBench 包括文本识别、公式识别、文本中心 VQA、KIE 等 29 项 OCR 相关的评估任务,取得了开源模型的最佳性能,并成为第一个 10B 左右参数量达到 600 分的模型。
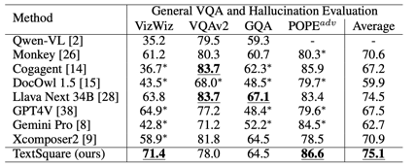
General VQA and Hallucination Evaluation Benchmark 在通用的 VQA Benchmark (VizWiz VQAv2、GQA、POPE) 上 TextSquare 相较于 Xconposer2 没有显著退化,仍然保持着最佳的性能,在 VisWiz 和 POPE 表现出显著的性能,比各最佳的方法高出 3.6%,这突出了该方法的有效性,能减轻模型幻觉。
消融实验

TextSquare 相较于 Xcomposer2 在各 benchmark 平均提升 7.7%。
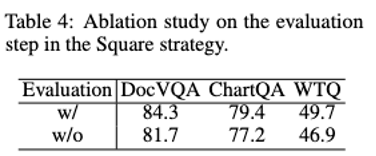
加入自评估后,模型性能有了明显提升。
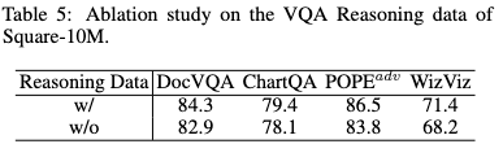
加入推理数据后有助于显著提升性能以及减轻幻觉生成。
数据规模和收敛 loss & 模型性能关系
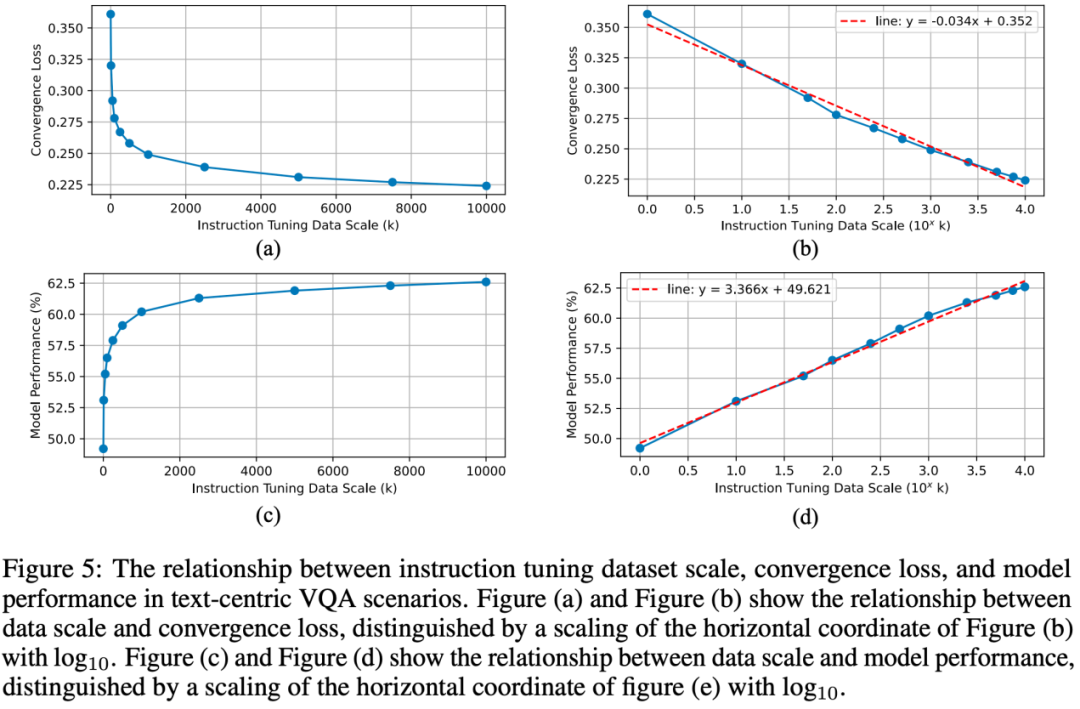
随着数据规模的增长,模型的 loss 继续减少,而下降速度逐渐变慢。收敛损失和指令调整数据尺度之间的关系近似符合对数函数。
随着指令调优数据的增长,模型的性能越来越好,但增长速度继续放缓,也大致符合对数函数。
总体而言,在以文本为中心的 VQA 场景中,在指令调整阶段存在相应的缩放定律,其中模型性能与数据缩放的对数成正比,可以指导潜在更大数据集的构建并预测模型性能。
总结
在本文中,研究者提出了构建高质量的以文本为中心的指令调优数据集(Square-10M)的 Square 策略,利用该数据集,TextSquare-8B 在多个 benchmark 上实现了与 GPT4V 相当的性能,并在各种基准测试上大幅优于最近发布的开源模型。
此外,研究者推导了指令调整数据集规模、收敛损失和模型性能之间的关系,以便为构建更大的数据集铺平道路,证实了数据的数量和质量对模型性能至关重要。
最后,研究者指出,如何进一步提高数据数量和质量以缩小开源模型与领先模型之间的差距,被认为一个有高度希望的研究方向。
以上就是8B文字多模态大模型指标逼近GPT4V,字节、华师、华科联合提出TextSquare的详细内容,更多请关注其它相关文章!
# 更大
# 高要网站建设优化
# 赣州网站建设软件
# 亳州网站seo优化推广
# 公司用营销推广违法吗
# 南通标准网站优化优势
# 蓬莱网页网站建设
# 政府网站建设的规范
# 烟台个人网络营销推广
# 来宾营销推广项目名称
# 啤酒的创意营销推广方案
# 取得了
# 并在
# 工程
# 进一步提高
# 有意义
# 高质量
# 多个
# 开源
# 华师
# 多模
# type
# gemini
# composer
# square
相关栏目:
【
Google疑问12 】
【
Facebook疑问10 】
【
优化推广96088 】
【
技术知识133117 】
【
IDC资讯59369 】
【
网络运营7196 】
【
IT资讯61894 】
相关推荐:
2025世界人工智能大会成功召开
亚马逊确认今年不会举办 re:MARS 机器人和人工智能大会
无人机协助盐城交通执法的协同训练
马斯克反讽人工智能AI炒作:“机器学习”本质就是统计
美图设计室2.0什么时候上线
联想戴炜:以全栈AI加速CT与IT融合,共建高质量算力网络
Unity 推出面向开发者的 AI 软件市场 AI Hub,股价飙涨 15%
大脚攀爬者车主福利!无人机、运动相机大奖等你来挑战
13条咒语挖掘GPT-4最大潜力,Github万星AI导师火了,网友:隔行再也不隔山了
人形机器人概念大热!这些产业链标的或受提振
刊·见 | 捕捉人工智能领域最新动态?收藏Applied Artificial Intelligence
AI教父Bengio:我感到迷失,对AI担忧已成「精神内耗」!
人工智能和神经网络有什么联系与区别?
联想举办2025创新开放日,展出260余项算力及AI产品技术
当人工智能开始写高考作文?作家陈崇正、朱山坡谈文学与未来
苹果式 AI 哲学:不着一字,处处落子
新华三集团总裁兼首席执行官于英涛:人工智能时代需要想象力,更需要精耕务实
实现人工智能和物联网的协同运作
世界人工智能大会高合发表演讲,HiPhi Y即将全球上市
海南科技职业大学第25届中国机器人及人工智能大赛海南赛区荣获一等奖等114项
微软在 Bing 和 Edge 浏览器中拓展网购服务,帮用户选购心仪产品
微软 GitHub Copilot 编程助手被投诉:换口吻改写公共代码来躲版权
网易加速行业AI大模型应用,将覆盖100多个应用场景
华为盘古AI模型实现秒级全球气象预报时间缩短
让AI助手带您轻松愉快地享受写作之旅
Yann LeCun团队新研究成果:对自监督学习逆向工程,原来聚类是这样实现的
杭州举办第19届亚运会,主题为「亚运元宇宙」的发布仪式举行
“苏南 vs 苏北” AI 分胜负,娱乐性比较工具 EitherChoice 上线
“直击”AI新世界,智能机器人再次“火出圈”了
读创正式上线“读创AI聊”功能
人工智能赋能广西自然资源领域监测监管
真全息产品,亮相深圳文博会——dipal数伴拓展元宇宙非沉浸式体验
再度重仓 AI 赛道,SaaS 巨头 Salesforce 扩大 AIGC 风投基金规模
IBM和NASA合作发布可追踪碳排放的开源AI基础模型
腾讯机器狗进化:通过深度学习掌握自主决策能力
SnapFusion技术大幅提升AI图像生成速度
国内阅读行业首款对话式AI应用“阅爱聊”封闭内测
喜马拉雅在国际会议挑战赛中突破语音重叠难题斩获第一 加速AI创新
马斯克“揭秘”人工智能真面目
微软推出人工智能模型 CoDi,可互动和生成多模态内容
人工智能正在弥合认知和表达之间的鸿沟
全新小艺搭载AI大模型,有效提升学生和职场人士的工作效率
特斯拉门店可能启动机器人卖车?也许不是你想的那样
马克龙密会AI专家,法国加入全球人工智能竞赛
视觉中国推出付费AI绘图功能:无版权可用
“智能体动作生成技术”现身WAIC:游戏AI技术为机器人科创注入新动力
大型无人机FH-98国内首次夜航转场成功
WHEE上线时间介绍
南京制造的国产工业机器人:在外资品牌竞争中突围,年销售1.8万台
“踩油门,也要会踩刹车” 互联网企业高管谈人工智能发展
2024-04-25

运城市盐湖区信雨科技有限公司是一家深耕海外推广领域十年的专业服务商,作为谷歌推广与Facebook广告全球合作伙伴,聚焦外贸企业出海痛点,以数字化营销为核心,提供一站式海外营销解决方案。公司凭借十年行业沉淀与平台官方资源加持,打破传统外贸获客壁垒,助力企业高效开拓全球市场,成为中小企业出海的可靠合作伙伴。
