本文系统性地介绍了gpu的工作原理及其在ai基础设施中的核心作用。文章从gpu的历史演进切入,阐述其从图形处理器到通用计算(gpgpu)的转型过程,重点解析cuda编程模型、cpu/gpu异构架构协作机制,并通过10亿级数组加法的性能对比实验直观展示gpu的并行优势。算是个人的一个学习总结,由于非算法背景,可能会有很多地方说的不正确,有任何问题都欢迎指正。
关注PHP中文网开发者,一手技术干货提前解锁?
PHP中文网开发者
PHP中文网官方社区公众号,汇聚技术开发者群体,分享技术干货,打造技术影响力交流社区。
971篇原创内容
公众号
背景
AI 流行的当下,你有没有想过:
图形渲染到GPGPU
为图形而生
GPU最初的使命是加速图形渲染。而渲染一帧图像,本质上就是对数百万个像素点进行相似的计算,这天然就是一种大规模并行任务。
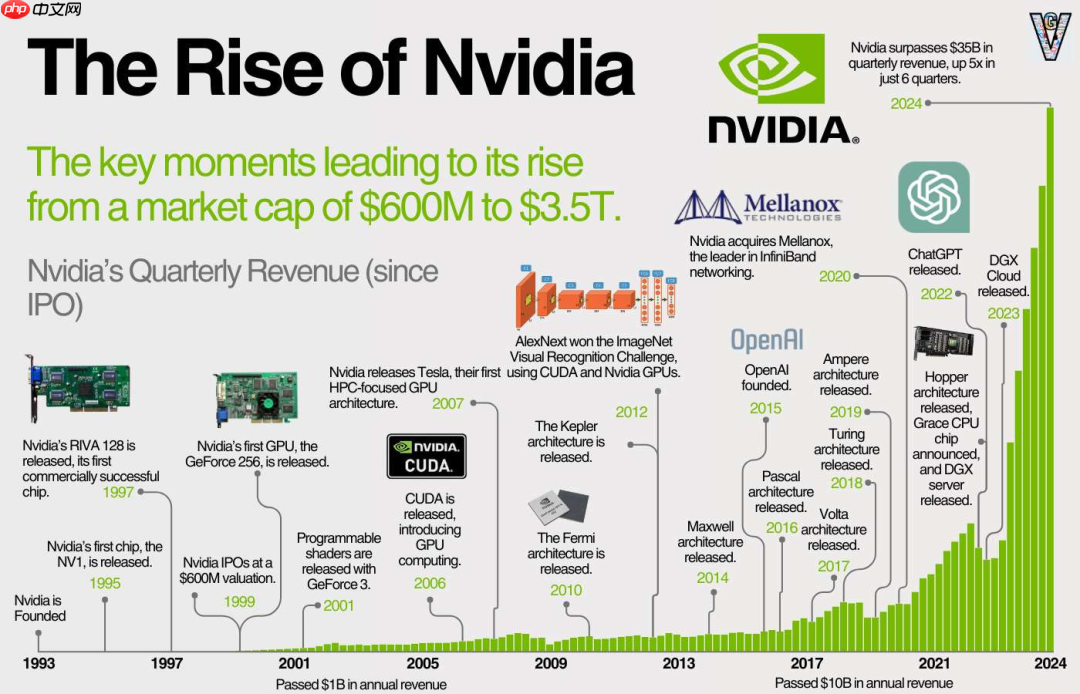
可编程性的开启 (2001)
NVIDIA发布GeForce 3,首次引入可编程着色器 (Programmable Shaders)。实质上允许开发者为 GPU 编写软件,让GPU的众多并行处理单元去同时执行,以精确控制光照和颜色如何加载到显示器上。这是朝着加速计算方向迈出的重要一步,因为它允许开发者直接为 GPU 编写软件。
学术界的探索
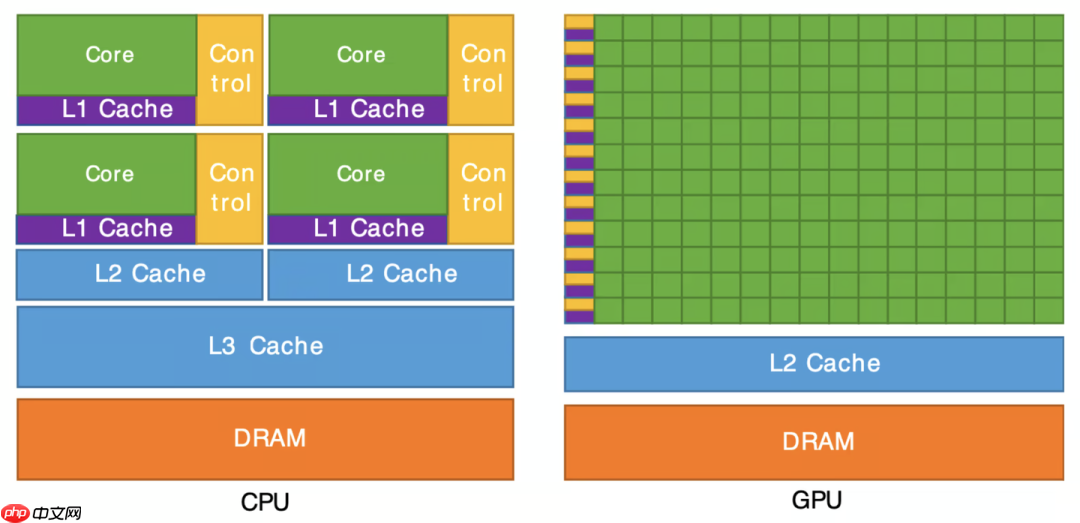
一批敏锐的研究人员意识到,GPU的本质就是一个拥有数百甚至数千个核心的大规模并行架构,其浮点运算吞吐量远超当时的CPU。他们的核心想法是:能不能用GPU进行科学计算?开始探索利用GPU计算科学计算问题,从而利用GPU的算力。这便是GPGPU(通用计算GPU)的萌芽。但是门槛非常高, 需要开发者同时精通图形学和科学计算。
 图片
NVIDIA的抉择
NVIDIA敏锐地捕捉到了GPGPU的发展潜力,开始不再局限于加速图形渲染,主动拥抱GPGPU。
2006年,发布了第一款为通用计算设计的统一架构GPU - GeForce 8800 GTX 显卡(G80架构)。它将GPU内部的计算单元统一起来,形成了一个庞大的、灵活的并行核心阵列,为通用计算铺平了硬件道路。
2007年,NVIDIA正式推出了CUDA平台。CUDA的革命性在于,它提供了一套简单的编程模型,让开发者能用近似C语言的方式,轻松地驾驭GPU内部成百上千个并行核心。 开发者无需再关心复杂的图形接口,可以直接编写在数千个线程上并发执行的程序。至此终结了GPGPU编程的蛮荒时代,让GPU计算真正走下神坛,成为开发者触手可及的强大工具。
随着深度学习的发展与流行,CUDA生态系统目前也成为NVIDIA最深、最宽的护城河。
 图片
参考链接 nvidia-past-present-and-future
CPU/GPU异构计算架构
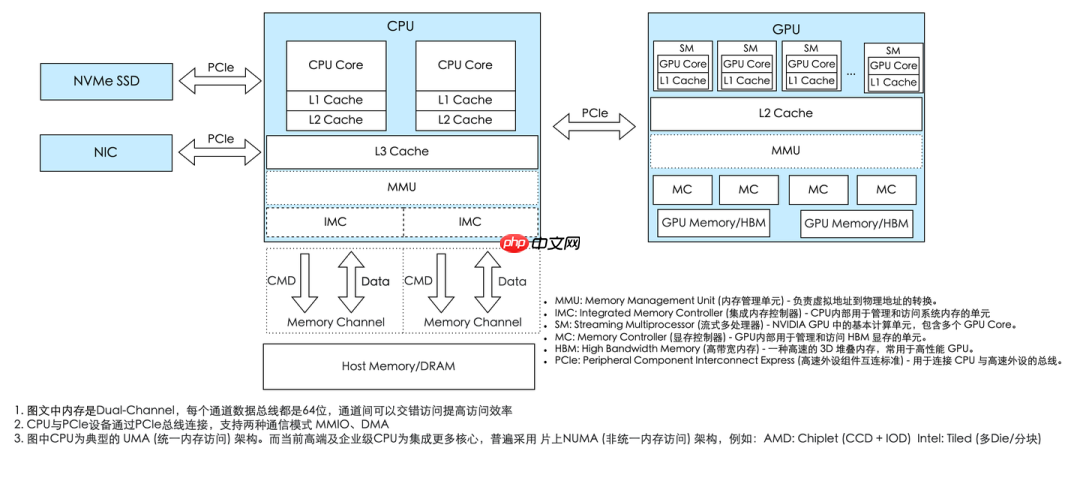
CPU是整个系统的核心,是总指挥,GPU的任务指令是由CPU分配的。
CPU通过PCIe总线给GPU发送指令和数据交互。而PCIe支持DMA和MMIO两种通讯模式:
MMIO(内存映射I/O)由CPU直接控制数据读写,操作系统会把设备地址映射到CPU的虚拟空间中,适合小数据量的指令交互DMA(直接内存访问)则允许设备绕过CPU直接访问系统内存,专为大数据块的高效传输设计。CPU通过IMC和Memory Channel访问内存,为了提升数据传输带宽,高端CPU通常会支持多内存通道,即多IMC和Memory Channel的组合,以满足日益增长的数据处理需求。
 图片
一个简单的应用
讲道理,对于开发来说,再通俗易懂的语言描述都不如一个简单Demo来的实在。
Demo代码来自even-easier-introduction-cuda,可在collab测试运行下述代码。
实现两个长度为 2³⁰ (约10亿) 的浮点数数组的相加。其中,一个数组 (x) 的所有元素初始化为 1.0,另一个数组 (y) 的所有元素初始化为 2.0,我们计算 y[i] = x[i] + y[i]。
4.1 CPU的实现
#include <iostream>#include <math.h>#include <chrono>// function to add the elements of two arraysvoid add(int n, float *x, float *y){ for (int i = 0; i < n; i++) y[i] = x[i] + y[i];}int main(void){ int N = 1<<30; float *x = new float[N]; float *y = new float[N]; // initialize x and y arrays on the host for (int i = 0; i < N; i++) { x[i] = 1.0f; y[i] = 2.0f; } auto start = std::chrono::high_resolution_clock::now(); // Run kernel on 1M elements on the CPU add(N, x, y); auto stop = std::chrono::high_resolution_clock::now(); auto duration = std::chrono::duration_cast<std::chrono::milliseconds>(stop - start); std::cout << "CPU 'add' function execution time: " << duration.count() << " ms" << std::endl; // Check for errors (all values should be 3.0f) float maxError = 0.0f; for (int i = 0; i < N; i++) maxError = fmax(maxError, fabs(y[i]-3.0f)); std::cout << "Max error: " << maxError << std::endl; delete [] x; delete [] y; return 0;}性能表现
g++ add.cpp -o addtime ./addCPU 'add' function execution time: 3740 msMax error: 0real 0m21.418suser 0m15.798ssys 0m4.400s计算耗时:核心的add函数耗时 3740毫秒。总耗时:整个程序从启动到结束(real time)耗时 21.4秒。这额外的时间主要消耗在分配8GB内存(new float[N])以及初始化数组上。
4.2 GPU的实现
这里的代码后面会详细解读,此处看懂含义即可。
分配内存:分别在CPU(Host)和GPU(Device, cudaMalloc)上分配内存。数据传输 (H2D): 将CPU上的输入数据 (h_x, h_y) 拷贝到GPU显存 (d_x, d_y)。执行Kernel函数:在GPU上启动addKernel函数,利用其大规模并行能力进行计算。数据传回 (D2H):将GPU计算完成的结果 (d_y) 拷贝回CPU内存 (h_y) 以便后续使用或验证。#include <iostream>#include <math.h>#define CUDA_CHECK(call) \do { \ cudaError_t err = call; \ if (err != cudaSuccess) { \ fprintf(stderr, "CUDA Error in %s at line %d: %s\n", __FILE__, __LINE__, cudaGetErrorString(err)); \ exit(EXIT_FAILURE); \ } \} while (0)// __global__ 关键字声明的函数被称为Kernel函数__global__void add(int n, float *x, float *y){ int index = blockIdx.x * blockDim.x + threadIdx.x; if (index < n) { y[index] = x[index] + y[index]; }}int main(void){ int N = 1 << 30; size_t bytes = N * sizeof(float); float *h_x, *h_y; h_x = new float[N]; h_y = new float[N]; float *d_x, *d_y; CUDA_CHECK(cudaMalloc(&d_x, bytes)); CUDA_CHECK(cudaMalloc(&d_y, bytes)); for (int i = 0; i < N; i++) { h_x[i] = 1.0f; h_y[i] = 2.0f; } CUDA_CHECK(cudaMemcpy(d_x, h_x, bytes, cudaMemcpyHostToDevice)); CUDA_CHECK(cudaMemcpy(d_y, h_y, bytes, cudaMemcpyHostToDevice)); cudaEvent_t start, stop; CUDA_CHECK(cudaEventCreate(&start)); CUDA_CHECK(cudaEventCreate(&stop)); CUDA_CHECK(cudaEventRecord(start)); int blockSize = 256; int numBlocks = (N + blockSize - 1) / blockSize; add<<<numBlocks, blockSize>>>(N, d_x, d_y); CUDA_CHECK(cudaEventRecord(stop)); CUDA_CHECK(cudaEventSynchronize(stop)); float milliseconds = 0; CUDA_CHECK(cudaEventElapsedTime(&milliseconds, start, stop)); std::cout << "GPU Kernel 'add' execution time: " << milliseconds << " ms" << std::endl; CUDA_CHECK(cudaEventDestroy(start)); CUDA_CHECK(cudaEventDestroy(stop)); CUDA_CHECK(cudaMemcpy(h_y, d_y, bytes, cudaMemcpyDeviceToHost)); float maxError = 0.0f; for (int i = 0; i < N; i++) { maxError = fmax(maxError, fabs(h_y[i] - 3.0f)); } std::cout << "Max error: " << maxError << std::endl; delete[] h_x; delete[] h_y; CUDA_CHECK(cudaFree(d_x)); CUDA_CHECK(cudaFree(d_y)); return 0;}性能表现
nvcc add.cu -o add_cu -gencode arch=compute_75,code=sm_75time ./add_cuGPU Kernel 'add' execution time: 48.6738 msMax error: 0real 0m19.413suser 0m15.308ssys 0m4.014s计算耗时:GPUKernel函数的执行耗时仅为 48.7毫秒。总耗时:程序总耗时为 19.4秒。
性能分析
单看核心计算任务,GPU (48.7ms) 的速度是CPU (3740ms) 的 约75倍。这完美体现了GPU在处理数据并行任务时的绝对优势。CPU需要串行执行10亿次加法(此处只考虑单核场景),而GPU则将任务分配给成千上万个线程同时处理。
但是虽然GPU计算本身极快,但程序的总耗时 (19.4s) 却和CPU版本 (21.4s) 相差无几。这是为什么呢?主要是CPU和GPU通讯的开销。这里下一篇文章会详细介绍。
编译-Fat Binary
nvcc add.cu -o add_cu -gencode arch=compute_75,code=sm_75 上面的例子中,我们看到这个编译指令。add.cu被编译为二进制文件add_cu。它具体是怎么做的呢?
主机代码编译: 将C/C++代码(在CPU上运行的部分)交由系统的主机编译器(如GCC、MSVC)编译成标准的CPU目标代码。设备代码编译: 将在__global__函数(如add)中定义的GPU代码,编译成两种主要格式:SASS (Streaming Assembler): 这是特定GPU架构的原生机器码。例如,为NVIDIA T4 GPU (Turing 架构 代号 sm_75 ) 编译的SASS,只能在该架构上最高效地运行。NVCC可以为多种指定的架构预编译多份SASS代码。PTX (Parallel Thread eXecution): arch=compute_75 指示编译器生成一份 PTX 代码,确保程序能在任何不低于 Turing 架构的新 GPU 上通过 JIT 编译运行(向前兼容性)。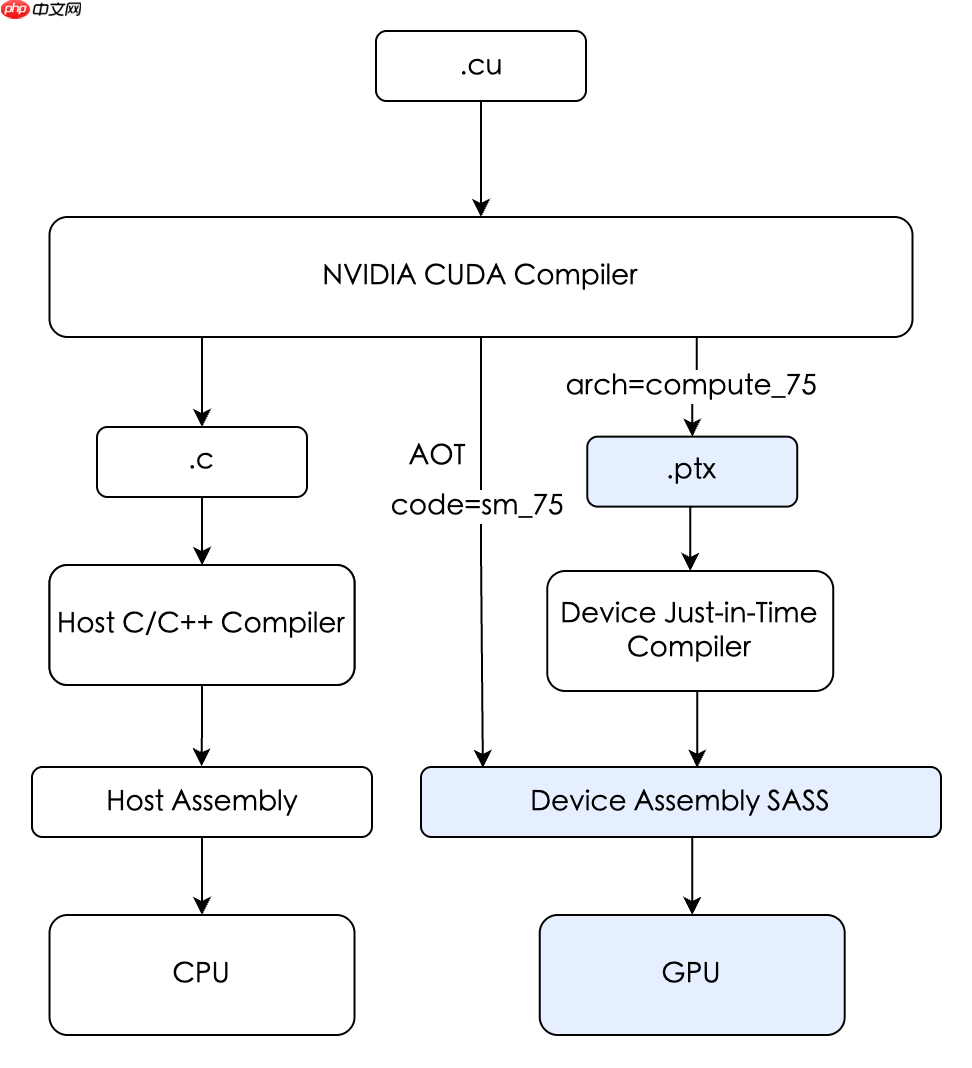 图片
这两种设备代码连同主机代码一起,被打包进一个可执行文件中,形成所谓的胖二进制 (Fat Binary)。它“胖”在包含了一份主机代码和多份针对不同GPU架构的设备代码。
程序加载 - cubin loading
6.1 程序启动
操作系统加载可执行文件,CPU 开始执行主机代码。
6.2 首次 CUDA 调用
当代码第一次调用任何 CUDA API 函数时(比如 cudaSetDevice, cudaMalloc,或者第一个Kernel函数启动),CUDA 运行时库 (CUDA Runtime Library) 会被初始化。
此处就是所谓的GPU上下文初始化/CUDA上下文初始化,主要步骤:
1. 硬件准备与唤醒
从低功耗的待机模式唤醒,进入高性能的计算模式;加载驱动模块(如NVIDIA CUDA Driver或AMD ROCm),并检测可用GPU设备及其属性(如显存大小、计算能力、NVLink连接)。2. CUDA上下文数据结构创建
CPU侧创建上下文信息的数据结构:创建一个统一虚拟地址空间(UVA),这个空间可以将所有的系统内存和所有GPU的内存都映射进来,共享一个单一的虚拟地址空间。(每次cudaMalloc都会增加一条记录)
3. 特定GPU上创建上下文
在显存中为当前进程分配并建立页表结构a. NVIDIA驱动程序(在CPU上)查询其内部维护的、用于管理GPU物理显存的数据结构(即VRAM Allocator,跨进程维护),以找到一个空闲的物理地址。CPU本地软件操作,不涉及与GPU的硬件通信。b. CPU在自己的内存(RAM)里,准备好了要写入的数据内容;c. NVIDIA驱动程序(在CPU上)命令DMA引擎将对应数据复制到显存;分配Pinned Memory命令缓冲区通过MMIO配置GPU的MMU硬件(PMMU 控制寄存器),告诉它页表的起始位置4. 上下文就绪
上下文完全建立,后续的Kernel函数启动、内存拷贝等命令可以通过流 (Stream) 机制提交到其命令缓冲区,由GPU异步执行。
6.3 首次调用add>>()时,进行Kernel函数加载
1. 检测硬件
它会查询当前的 GPU,识别出具体架构。
2. 寻找最佳匹配 (SASS)
然后,它会在 Fat Binary 的设备代码段中进行搜索,寻找有没有预编译好的、针对 sm_75 的 SASS 代码。
3. 没有找到完全匹配的 SASS 代码
如果没有找到完全匹配的 SASS 代码运行时会找到 PTX 中间代码,并调用集成在 GPU 驱动中的 JIT (Just-In-Time) 编译器将其即时编译(JIT)为目标GPU的SASS代码; (cpu上完成);
为了避免每次运行程序都重新进行 JIT 编译,NVIDIA 驱动通常会缓存 JIT 编译的结果。NVIDIA驱动会在用户的home目录下创建一个计算缓存,通常是 ~/.nv/ComputeCache。
4. cubin loading (cubin 是 CUDA binary 的缩写)
a. 将准备好的 SASS 代码(无论是来自 Fat Binary 还是 JIT 编译的结果)申请显存空间;通过DMA复制到显存;
b. 驱动程序在其内部的表格中,将Kernel函数 add 与其在 VRAM 中的地址关联起来。后续调用 add>>() 时,运行时会将一个包含该 VRAM 地址的启动命令提交到流中,由 GPU 异步执行
程序执行 - Kernel Launch
一个常见的误解是CPU会直接、实时地控制GPU。实际上,考虑到CPU和GPU是两个独立的处理器,并且通过PCIe总线连接,直接的、同步的控制会带来巨大的延迟和性能开销。因此,现代GPU采用了一种高效的异步通信模型,其核心就是 命令缓冲区(Command Buffer)与门铃(Doorbell)机制。这也是CUDA Streaming的底层通讯机制。
7.1 Command Buffer + Doorbell 机制
cpu先把需要执行的命令写到ring buffer命令缓冲区(Pinned Memory,位于主机内存); 更新w_ptr在适当的时候通过MMIO设置Doorbell Register,告诉GPU有新任务需要处理;GPU上的DMA引擎将ring buffer命令缓冲区[r_ptr, w_ptr)复制到显存中,然后开始执行;(其中w_ptr和r_ptr可以理解为相对于 Ring Buffer 基地址 (Base Address) 的偏移量。)下面对于部分由代表型的API的执行逻辑进行单独阐述。
7.2 CPU 执行到cudaMalloc
cudaMalloc 是一个同步阻塞调用,它不使用上述的流式命令缓冲区机制。(CUDA 11.2+支持cudaMallocAsync可实现异步分配)
CPU 线程调用 cudaMalloc()。CUDA 运行时库将此请求转发给 NVIDIA 驱动程序;驱动程序向物理VRAM Allocator请求物理内存,向 UVA Manager 请求虚拟地址,更新UVA映射表;(物理VRAM Allocator是跨进程的,维护整个GPU 物理显存的使用情况);更新 GPU page table[Command Buffer + Doorbell方式,特定的、高优先级的通道,非默认的Stream],刷新TLB;返回虚拟内存指针。与malloc的不同之处
Lazy Allocation vs. Eager Allocationmalloc支持overcommit,实际物理内存的分配发生在访问时(Lazy Allocation),通过缺页中断(Page Fault)按需映射到物理内存;而cudaMalloc是同步分配连续的物理显存(Eager Allocation),保证了后续使用的确定性,但初始开销更高。system call overheadcudaMalloc直接陷入内核,调用GPU驱动分配物理内存;而malloc本身是C库函数(用户态), 向操作系统“批发”大块内存,然后在用户程序请求时“零售”出去。避免内存分配时昂贵的系统调用和缺页异常开销: 申请=128KB内存时,会直接通过mmap系统调用向操作系统申请内存,free时也会直接释放。 cudaMalloc直接陷入内核,调用GPU驱动分配物理内存;释放策略cudaFree会直接释放,而free对于brk/sbrk分配的内存不会直接释放(物理内存和虚拟内存都不释放,为了避免Page Fault引入的性能开销就没有释放物理内存),用户态维护freelist,同时会合并连续空闲的虚拟地址空间,有效减少内存碎片(coalescing)。7.3 CPU 执行到 cudaMemcpy、cudaMemset
通过Command Buffer + Doorbell 机制提交命令到GPU; 然后同步或者异步等待。
7.4 CPU 执行到Kernel函数add>>()
CPU侧:命令打包与提交
驱动将Kernel函数启动所需信息打包成一个命令。命令包括:启动Kernel函数,Kernel函数对应的add SASS 代码的入口地址,执行配置(Grid 维度、Block 维度、共享内存大小等)、参数指针(GPU虚拟地址)将命令写入主机端的 Pinned Memory Ring Buffer;通过 MMIO 写 Doorbell 寄存器,通知 GPU。GPU侧: 命令获取与运行
1. 通过 DMA 从 Pinned Memory 读取Ring buffer部分内容。
2. 命令解码GPU 的命令处理器 (Front-End) 从其内部队列中取出命令包。它开始解码这个命令包,识别出这是一个“Kernel函数启动”任务,并解析出所有的执行参数(Grid/Block 维度、Kernel函数地址等)。
3. 工作分发
int blockSize = 256; int numBlocks = (N + blockSize - 1) / blockSize; add<<<numBlocks, blockSize>>>(N, d_x, d_y);
4. 线程块调度与执行
__global__void add(int n, float *x, float *y){ int index = blockIdx.x * blockDim.x + threadIdx.x; if (index < n) { y[index] = x[index] + y[index]; }}5. 完成与资源回收当一个线程块完成了所有计算,它所占用的 SM 资源(如寄存器、共享内存)会被释放,SM 可以接收新的线程块。当整个 Grid 的所有线程块都执行完毕,这个Kernel函数启动任务就算完成了。
Grid、Thread Block、Warp、Thread、SM这些概念到底是干啥的。下面结合GPU的硬件架构详细介绍。
 Playground AI
AI图片生成和修图
 99
查看详情

GPU的硬件架构
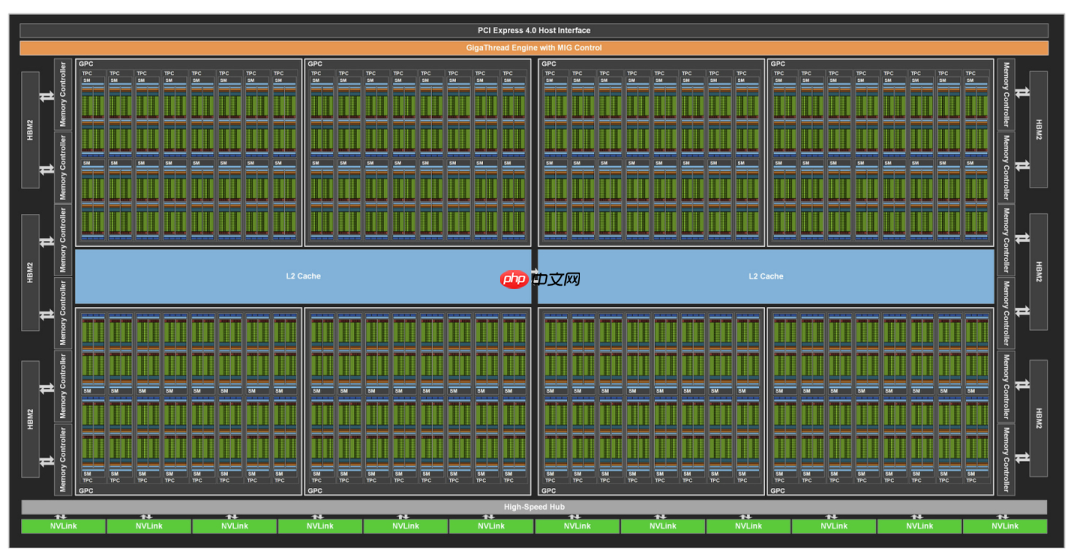
如上是NVIDIA GA100 GPU的架构图:
 图片
A100 GPU 架构图。
8.1 计算单元
GPC
Graphics Processing Cluster, 一个GPU包含多个GPC, 一个GPC包含多个TPC
TPC
Texture Processing Cluster, 一个TPC包含多个SM
SM
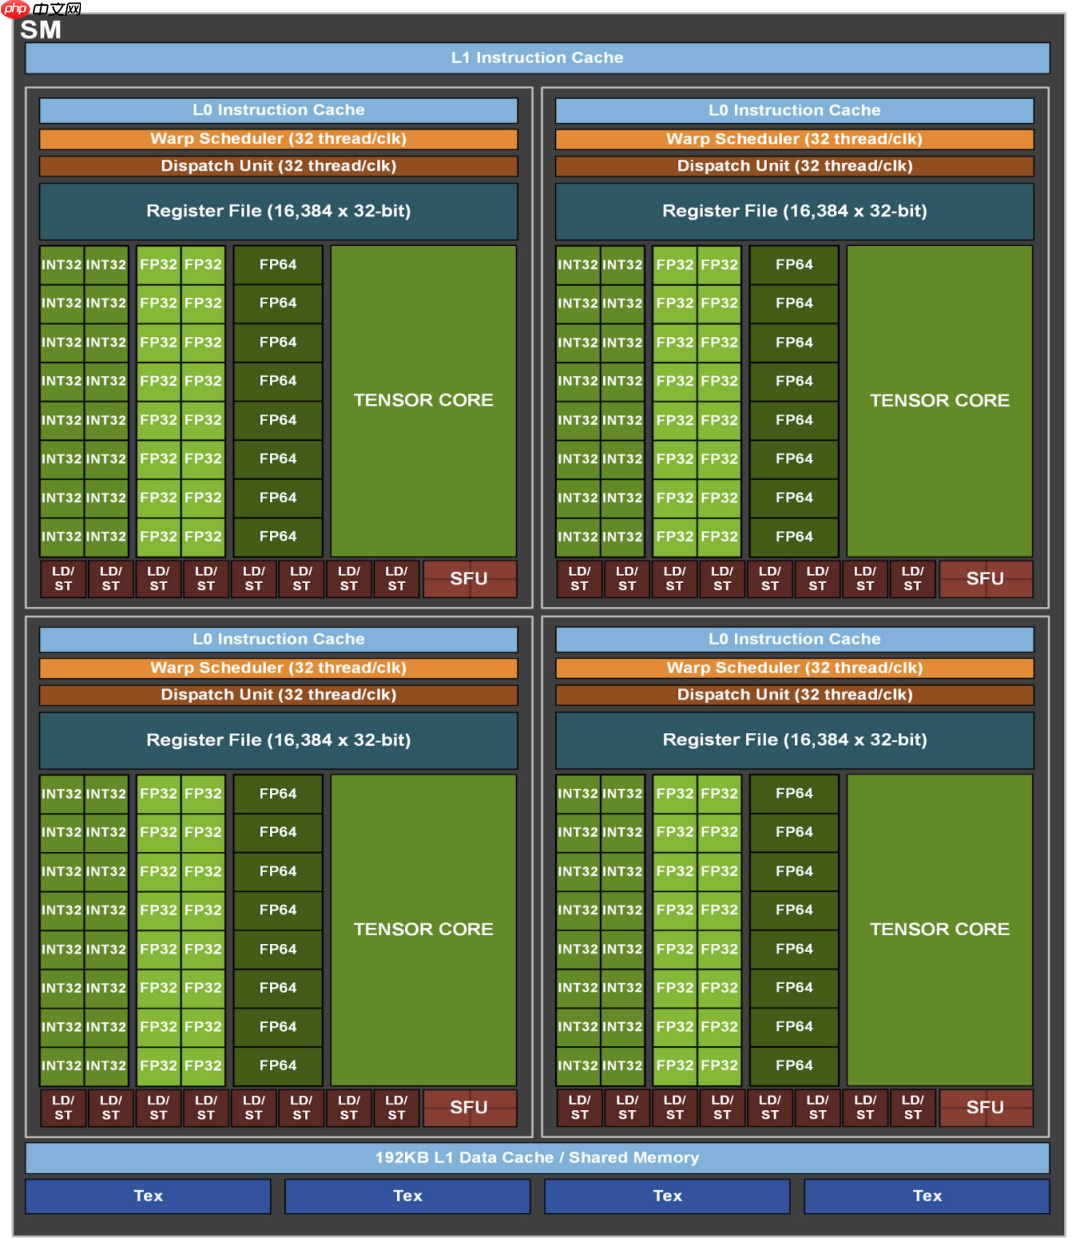
Streaming Multiprocessor, SM是GPU执行计算任务的核心单元,它是
CUDA Cores (执行FP32/INT32等通用计算的ALUs/FPUs)、Tensor Cores一个硬件单元,专门处理**FMA(Fused Multiply-Add)**操作,能在一个时钟周期内完成一个小的矩阵乘加运算(一个4x4的FP16矩阵相乘后累加到另一个4x4矩阵上)深度学习绝大部分的计算都是FMA操作,NVidia工程师为此专门设计专用计算单元。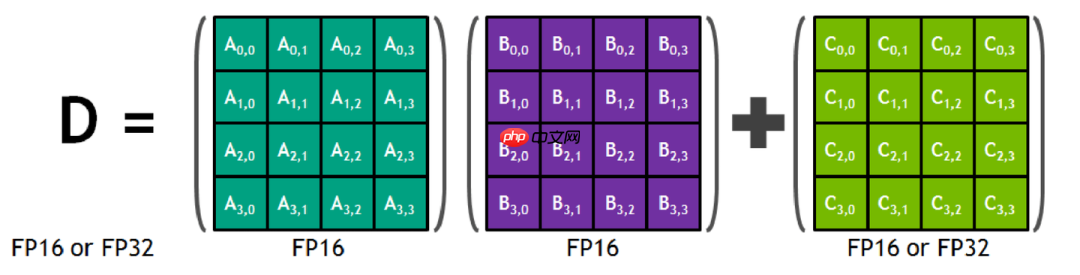 图片
单个SM的架构图如下:
 图片
8.2 接口
PCIe 负责CPU与GPU的通讯,DMA模式。NVLINK 负责GPU间的通讯。8.3 内存与缓存
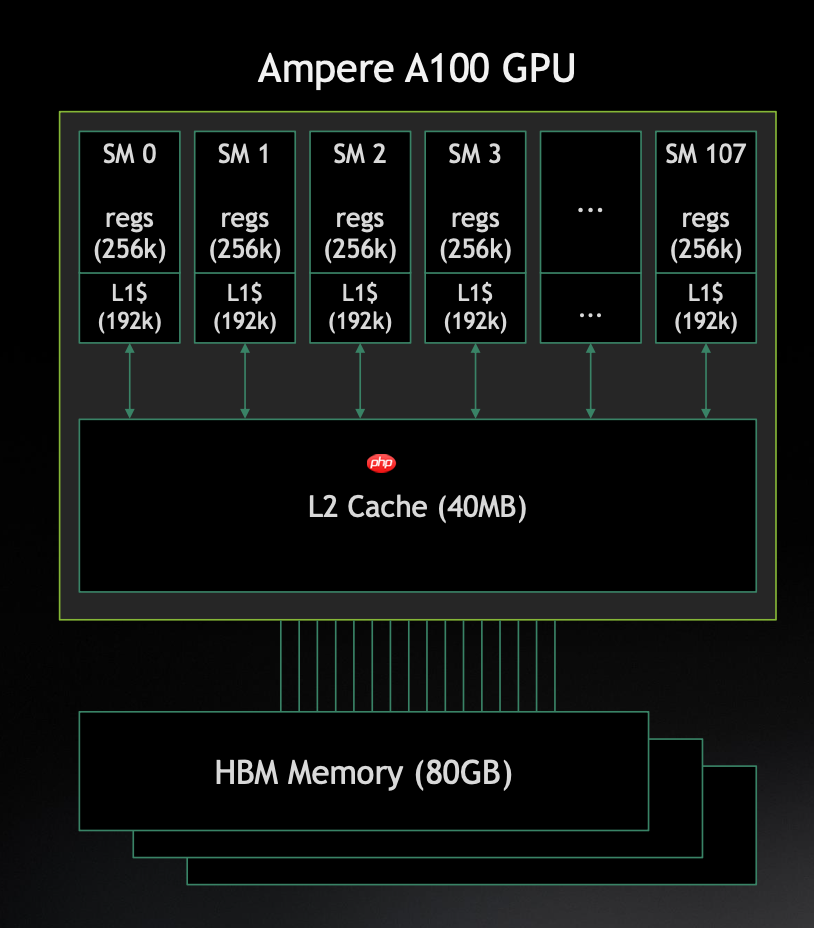
其中HBM和L2 Cache是整个GPU共享的;
而L1 Cache/Shared Memory则是SM维度独享的;
Shared Memory是每个SM内部的一块高速、可编程的片上缓存。同一线程块(Block)内的所有线程都可以访问它,速度远快于访问全局显存(HBM)。它是实现Block内线程高效协作和数据交换的核心,对于矩阵乘法等需要数据复用的算法至关重要。
 图片
速度由快到慢依次为 寄存器 -> L1 Cache -> L2 Cache -> HBM -> DRAM(主机内存)。
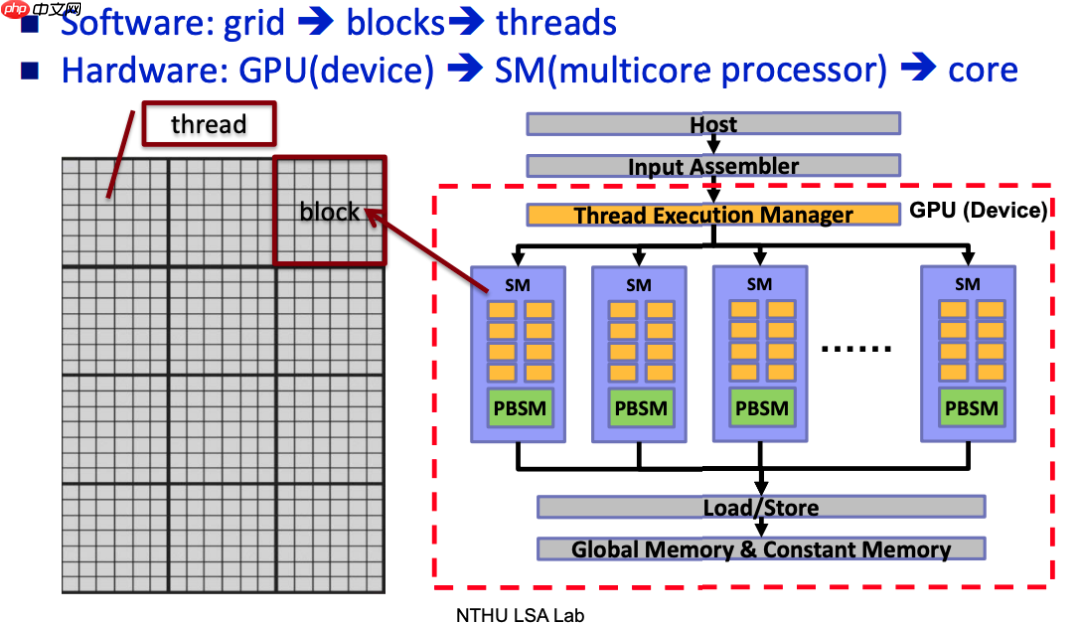
编程模型 vs 硬件执行模型
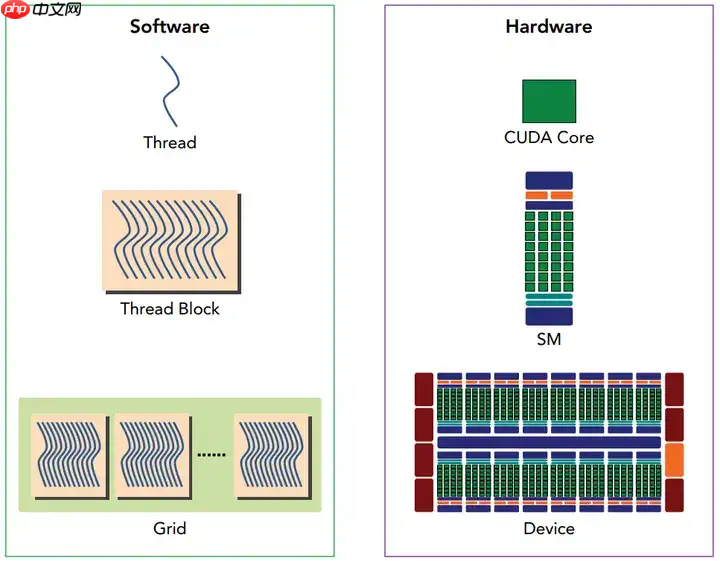
 图片
9.1 编程模型
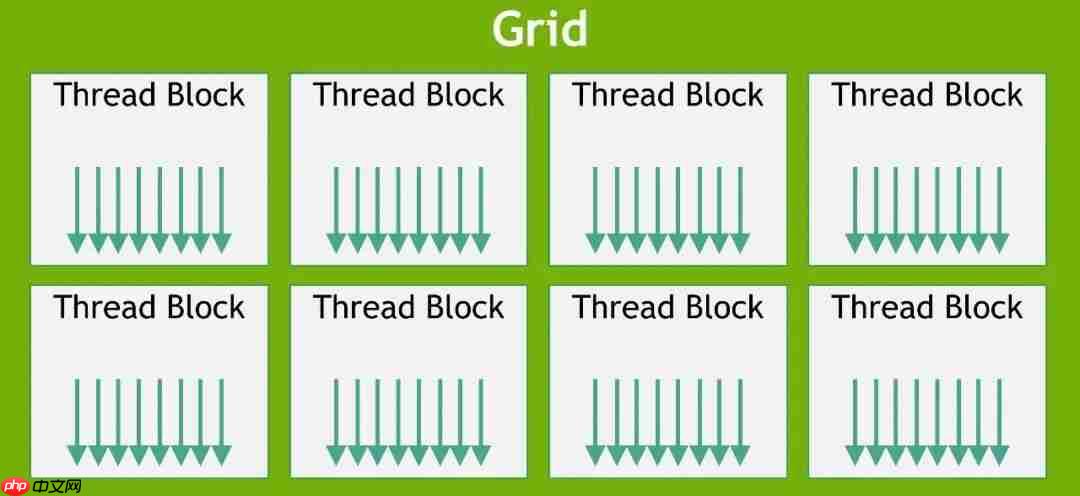
将一个待批量并发的数据组织成Grid、Thread Block、Thread的结构。
 图片
Grid和Thread Block可以是1维的也可以是2维或者3维的。这里这么设计,感觉主要是为了让程序员可以根据实际处理的结构能够更自然的思考,同时可以覆盖数据局部性需求,比如,我要处理一个1维数据,自然的我们就可以把Grid和Thread Block定义为1维的。比如上面例子中计算1维数组的加法,就可以用1维的Grid和Thread Block。
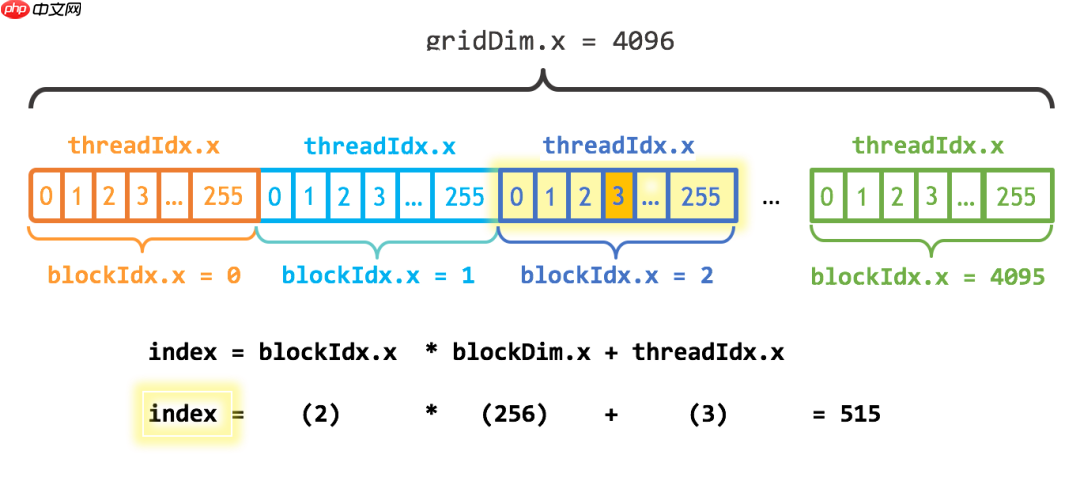
int blockSize = 256;int numBlocks = (N + blockSize - 1) / blockSize;add<<<numBlocks, blockSize>>>(N, d_x, d_y);__global__void add(int n, float *x, float *y){ int index = blockIdx.x * blockDim.x + threadIdx.x; if (index < n) { y[index] = x[index] + y[index]; }}Grid视图:
 图片
这行代码是CUDA编程的基石(SIMT),它将软件层面的线程坐标映射到数据上的全局索引。
threadIdx.x: 当前 Thread 在其 Block 内的 x 坐标。范围是 0 到 blockDim.x - 1。blockDim.x: 每个 Block 在 x 维度上有多少个 Thread。(在我们例子中是256)。blockIdx.x: 当前 Block 在 Grid 中的 x 坐标。范围是 0 到 gridDim.x - 1。gridDim.x: Grid 在 x 维度上有多少个 Block。blockIdx.x * blockDim.x计算出了当前线程块之前所有线程块包含的线程总数(偏移量),再加上threadIdx.x,就得到了当前线程在整个Grid中的全局唯一ID。这保证了10亿个元素,每个都能被一个特定的线程处理到。
这里解释下上面提到的数据局部性: y[index] = x[index] + y[index]; 可以合并访存 (Coalesced Memory Access)。即一个Warp中的32个线程访问连续的32个内存地址,GPU硬件可以将其合并成一次或少数几次宽内存事务,极大提升访存效率。
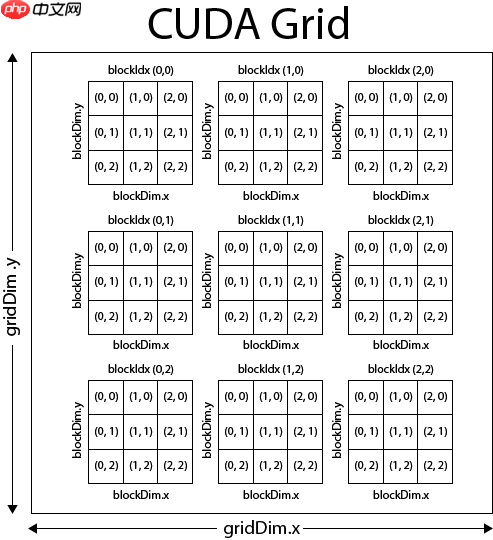
而当我们要处理一个二维矩阵或图像时,最自然的思考方式就是二维的。这时候我们可以用2维的Grid和Thread Block。
dim3 blockSize(16, 16); // 16x16 = 256 线程/块dim3 gridSize((N + blockSize.x - 1) / blockSize.x, (N + blockSize.y - 1) / blockSize.y);__global__ void matrixMulGPU(const float* A, const float* B, float* C, int N) { int row = blockIdx.y * blockDim.y + threadIdx.y; int col = blockIdx.x * blockDim.x + threadIdx.x; if (row < N && col < N) { float sum = 0.0f; for (int k = 0; k < N; ++k) { sum += A[row * N + k] * B[k * N + col]; } C[row * N + col] = sum; }}Grid视图:
 图片
9.2 硬件层面
将整个GPU的运算单元分为 GPU、SM、Warp和Core。
软件层面将grid切分成多个Thread Block是为了对硬件的抽象,这样程序员就不必关心GPU具体有多少个物理核心、多少个SM。
Thread Block是最小的“资源分配与调度”单位,Warp是最小的硬件调度单位。
所以整个编程模型大概就是:
图片一个任务软件层面上被分为Grid和Thread Block,Thread Block被分配给硬件的SM,SM又将Thread Block按照32个Thread为一组分成Warp,分配给Warp scheduler执行。
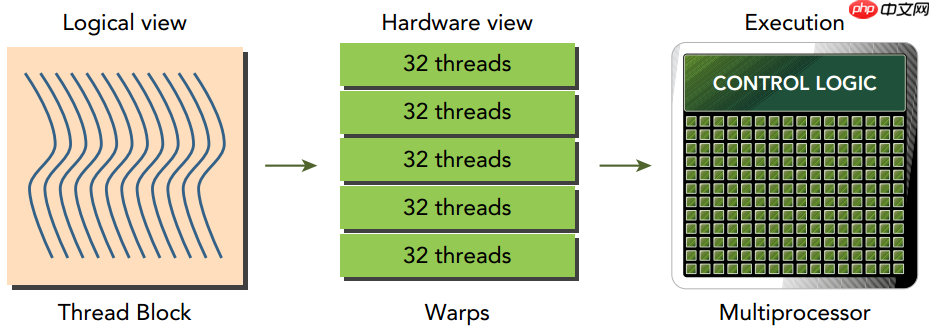 图片
最终的视图大概是这样的:
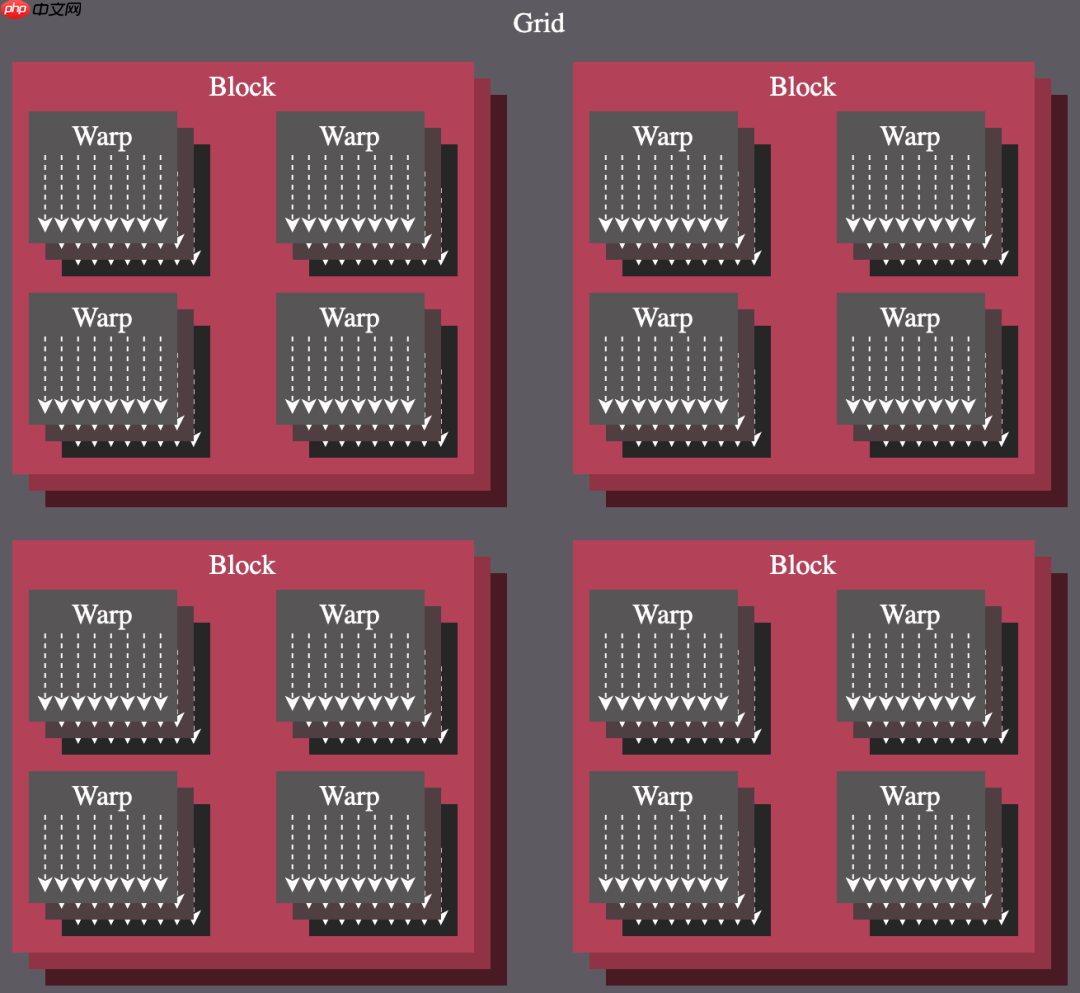 图片
9.3 隐藏延迟 - hide latency
前面已经看到一个计算任务对应一个Grid,一个Grid又由多个Thread Block组成,GPU的全局调度器(GigaThread Engine)将Thread Blocks分配给有空闲资源的 SM。(多个Thread Blocks可以被分配给一个SM,取决于共享内存、寄存器使用的使用情况)
一个Thread Block被分解成多个Warp(例如,一个1024线程的Block被分解成32个Warp)。SM内部的调度硬件,会将这32个Warp分配给它内部的4个Warp Scheduler。通常会尽量均匀分配,比如每个Warp Scheduler分到8个Warp。
而一个Warp Scheduler同一时刻只能运行一个Warp, 当某个正在执行的Warp因为等待内存而暂停时,它可以立刻从剩下的Warp中挑选一个就绪的来执行。这就是所谓的隐藏延迟 (hide latency)。而如何充分利用这个特性呢?给每个Warp Scheduler足够多的可切换的Warp。
每个SM都包含一个巨大、单一的物理寄存器文件,为实现零开销Warp上下文切换的提供了硬件基础。这是与CPU昂贵的上下文切换(需要保存和恢复大量状态)的根本区别。
要让每个 Warp Scheduler (Warp 调度器) 有足够的可切换 Warp,其本质是提高 GPU 的占用率。占用率指的是一个 SM 上实际活跃的 Warp 数量与该 SM 理论上能支持的最大 Warp 数量的比例。
一个 SM 能同时运行多少 Warp(一个 SM 在同一时刻只能为一个 Kernel 服务,但可以同时运行该Kernel的多个线程块(只要资源允许)),取决于以下三个主要资源的限制:
Registers每个线程都需要使用寄存器来存储其局部变量。一个 SM 上的寄存器总数是固定的假设一个 SM 有 65536 个寄存器,最大支持 2048 个线程 (64 Warps)。 每个Kernel需要 64 个寄存器,那么一个 Block (假设 256 线程) 就需要 256 * 64 = 16384 个寄存器。这个 SM 最多可以容纳 65536 / 16384 = 4 个这样的 Block,也就是 1024 个线程 (32 Warps),占用率为 50%。如果 Kernel 每个线程需要 128 个寄存器,那么这个 SM 只能容纳 2 个这样的 Block,占用率就更低了。Shared Memory共享内存是分配给每个线程块 (Block) 的、速度很快的片上内存。一个 SM 上的共享内存总量是固定的。假设一个 SM 有 96KB 共享内存,最大支持 16 个 Block。如果Kernel 每个 Block 需要 32KB 共享内存,那么这个 SM 最多只能同时运行 96KB / 32KB = 3 个 Block。在这个场景下,共享内存成为了主要的限制因素。这就将 SM 上并发的 Block 数量上限从硬件支持的 16 个锐减到了 3 个,从而严重限制了 SM 上的总并发 Warp 数量,降低了占用率。线程块/线程数限制每个 SM 架构本身就有硬件限制,比如一个 SM 最多能同时调度多少个 Block(例如 16 或 32),以及最多能同时管理多少个线程(例如 2048)。这个是硬性上限,无法通过代码改变。不过提高 GPU 的占用率来隐藏延迟也不是万能的,隐藏延迟的有效性,本质上取决于 Warp调度器是否有“就绪态”的Warp可供切换。比如:如果一个Kernel非常简单,每个线程只使用极少的寄存器,并且不使用共享内存,那么一个SM上可能会驻留大量的Warp。但如果这个Kernel的计算是访存密集型且延迟很高的,同时计算/访存指令比例很低,那么即使占用率达到100%,Warp调度器可能依然会“无Warp可调”,因为所有Warp都在等待数据返回。这时候我们就不得不提另外一个概念,访存比(Ratio = Total Bytes / Total FLOPs)或者计算强度(Roofline,I = Total FLOPs / Total Bytes), 说白了,就是看一个程序是计算密集型(Compute-bound)还是IO(内存访问)密集型(Memory-bound)。可以使用NVIDIA Nsight Compute分析Kernel函数的占用率和计算强度。 不过这里不做延伸了,放到下篇性能优化中讲。
SIMD vs SIMT
前面CUDA Demo中我们已经知道Kernel函数add会被启动成茫茫多的线程执行,每个线程通过计算 blockIdx 和 threadIdx 来处理不同的数据。
__global__void add(int n, float *x, float *y){ int index = blockIdx.x * blockDim.x + threadIdx.x; if (index < n) { y[index] = x[index] + y[index]; }}
从程序员的角度看,我们似乎是在编写多线程(Multiple Threads)程序。但从硬件的角度看,它是如何让这么多线程同时执行同一条指令(Single Instruction)的呢?
这种“单指令,多线程”(Single Instruction, Multiple Threads, SIMT)的编程模型,正是CUDA的魅力所在。SIMT通过线程编程模型巧妙的隐藏了底层SIMD的执行细节。而要理解SIMT,就不得不提在CPU中广泛使用的SIMD技术。
 图片
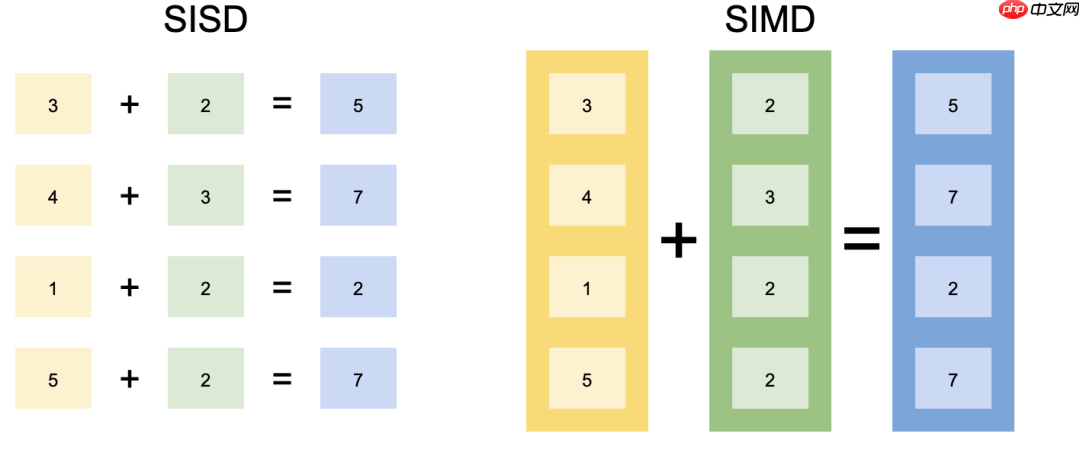
在传统的标量计算模型中,CPU的一条指令一次只能操作单个数据。例如,一次浮点加法就是double + double;
当处理如图形、音频或科学计算中常见的大规模数据集时,这种“一次一个”的模式效率极低,因为我们需要对海量数据重复执行完全相同的操作,这暴露了标量处理的瓶颈。
为了打破这个瓶颈,现代CPU集成了SIMD(单指令,多数据)架构。CPU增加了能容纳多个数据元素的宽向量寄存器(如256位的YMM寄存器),以及能够并行处理这些数据的执行单元。
比如_mm256_add_pd cpu可以同时进行4对double的加法运算(256位的寄存器, 256/64=4)
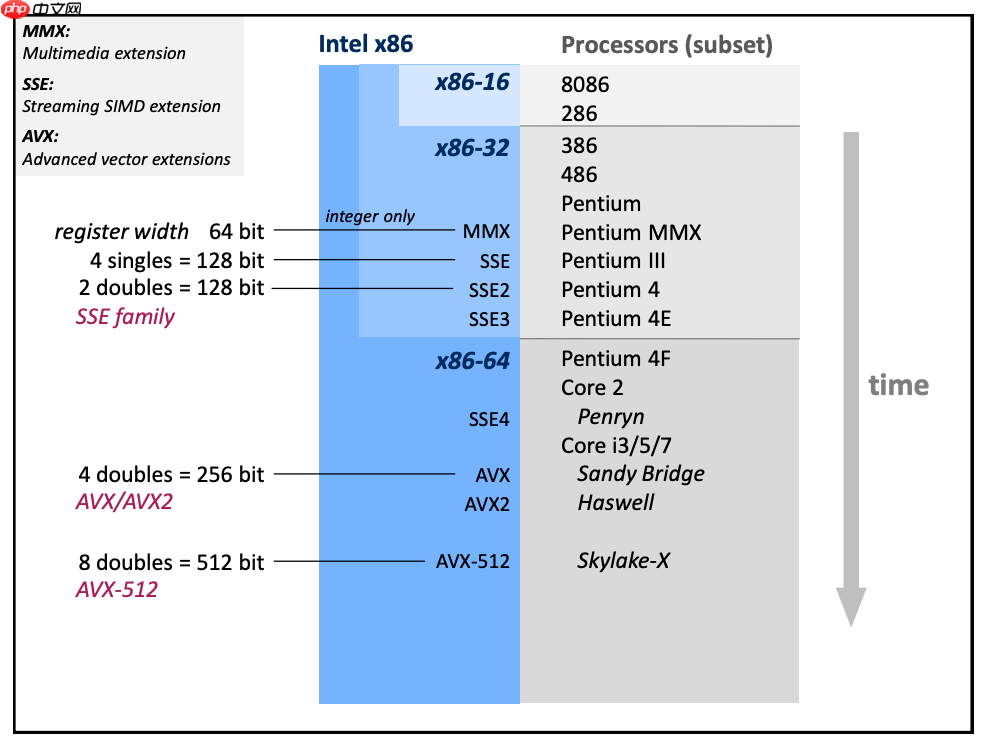 图片
为了加速多媒体和科学计算,Intel不断引入更强大的SIMD指令集,从MMX的64位 -> SSE的128位 -> *X的256位 -> *X-512的512位。
但是SIMD偏硬件底层,编程不友好:
手动打包解包向量。手动处理if else逻辑。10.1 SIMT(Single instruction, multiple thread)
为了解决编程不友好的问题,NVIDIA提出SIMT(Single Instruction, Multiple Threads)。SIMT是CUDA编程的基石,是GPU从一种处理图形计算的专用硬件,进化为GPGPU的基础。
 图片
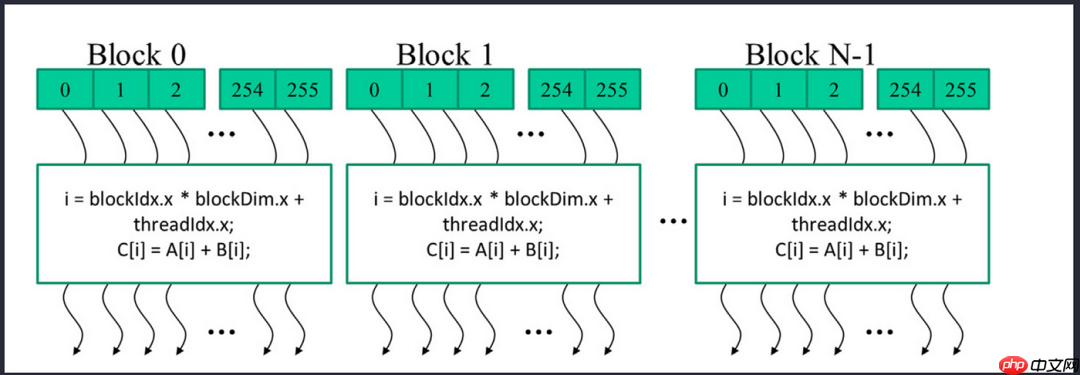
具体实现简单来说就是:同一时刻,Warp调度器只发布一条指令,后端仍然以SIMD的模式执行,而具体哪些线程执行依赖活动掩码控制。(ps: 下图为Pre-Volta的一个示意图,Volta以及之后的架构由于线程独立PC和Stack的出现,SIMT Stack已被淘汰)。
SIMT巧妙的隐藏了SIMD的复杂性,程序员只需要思考单个线程的逻辑,大大降低了心智负担。比如,如下代码每个thread都执行相同的代码,但是由于每个thread都会计算出特有的index,所有其实都在处理不同的数据。
int i = blockIdx.x * blockDim.x + threadIdx.x;C[i] = A[i] + B[i];
 图片
Warp Divergence
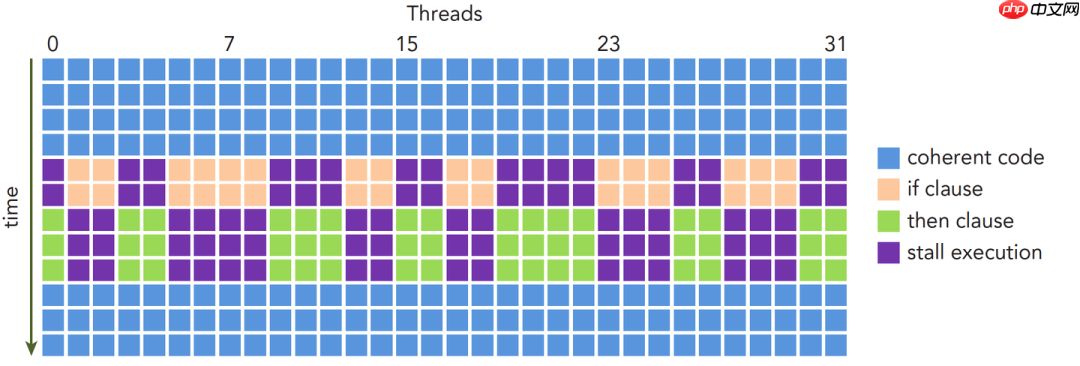
每个Warp中的32个线程必须同步的执行相同的指令序列(SIMT是基于Warp的SIMD),这就导致在处理if-else时,GPU需要串行执行每个分支,导致算力浪费。
Pre-Volta
在Pre-Volta架构中,一个Warp(32个线程)共享同一个程序计数器(PC)。这意味着它们在代码中的位置必须时刻保持一致。
如下图所示:由于硬件需要串行执行不同的代码分支,导致一部分线程在另一部分执行时只能空闲(Stall),造成了严重的并行效率损失。
 图片
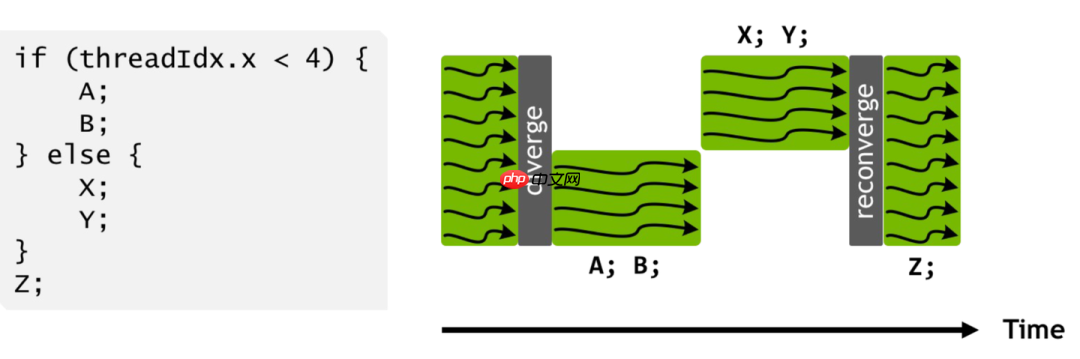
Warp具体是怎么处理分支逻辑的呢? 利用SIMT Stack记录所有可能执行路径的上下文,遇到分支时,通过活动掩码标记需要执行的活跃线程。当前分支执行完时,硬件会去检查SIMT Stack是否还有其他可执行分支。最终所有分支执行完成后,在汇合点(Reconvergence Point)恢复Warp中所有线程的执行。
 图片
这里有个问题,如上图,如果执行B的时候因为等待内存而暂停时,有没有可能切到另外一个分支执行X;Thread层面的隐藏延迟?
在Pre-Volta架构中,答案是不能。因为整个Warp共享一个程序计数器和状态,需要为每个线程配备独立的程序计数器(PC)和栈(Stack)。
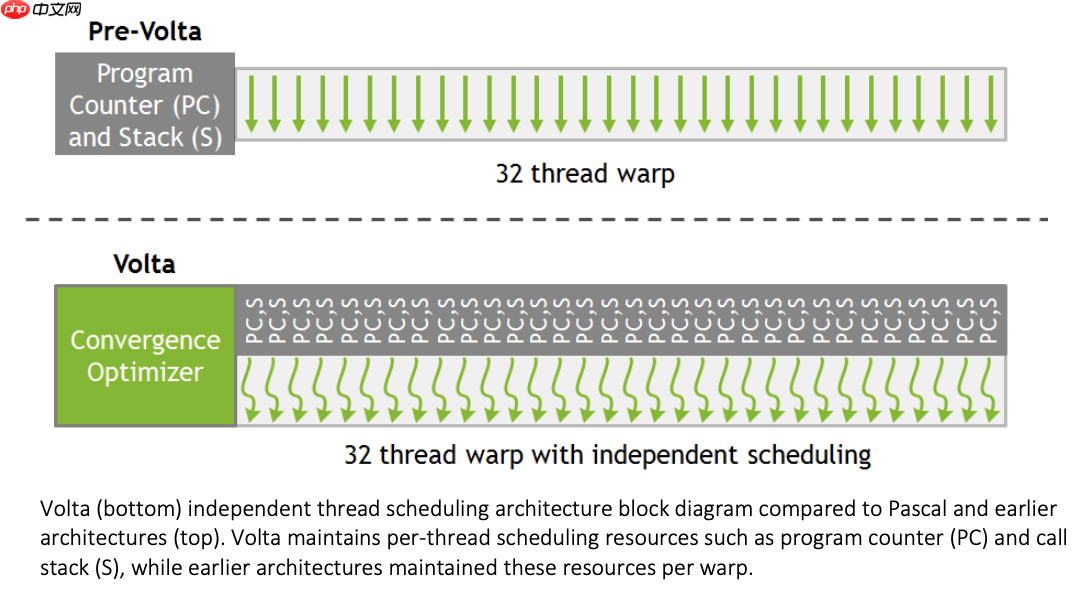
Post-Volta Volta及后续架构
 图片
Volta及后续架构为每个线程配备独立的程序计数器(PC)和栈(Stack)。
但是在任何时刻,Warp调度器还是只发布一条指令,即指令缓存(I-Cache)、指令获取单元(Fetch)、指令解码单元(Decode)都是Warp级别共享的。这意味着,尽管线程拥有独立的PC,但一个Warp内的线程不能在同一时钟周期执行不同的指令。
为什么不能让一个Warp中的32个线程在同一时刻执行32条不同的指令? MIMD,multiple instruction, multiple thread, 恭喜你发明了多核cpu架构。GPU的定位就是并行计算,没必要搞MIMD;另外这样搞导致硬件成本和功耗成本都大幅提升。算是硬件效率与执行灵活性的一个trade-off。
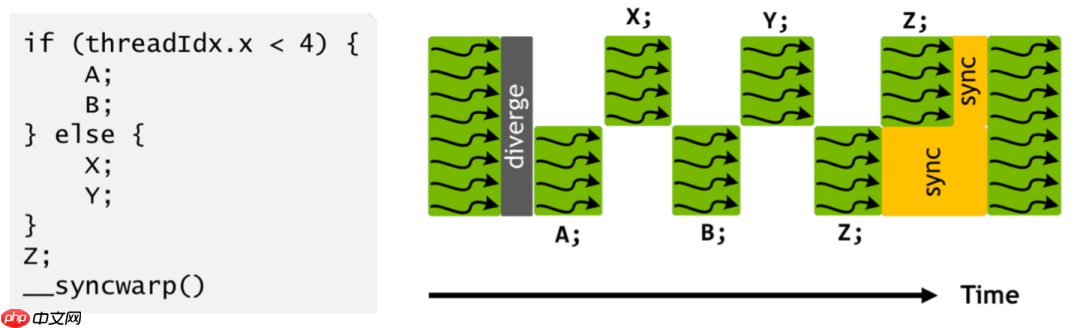
这样Volta及后续架构,在Warp调度器同一时刻只发布一条指令的情况下,利用独立程序计数器(PC)和活动掩码(Active Mask)就可以实现智能调度。硬件通过在不同周期、用不同的“活动掩码”来执行不同的指令,巧妙地"编织"出了多线程独立执行的假象。说白了,就是当一个Warp中的某些线程因为等待内存操作而暂停时,调度器可以切换执行同一个Warp下的其他线程,从而实现所谓的“线程级延迟隐藏”。实际上,这样也难以避免Warp Divergence导致的算力浪费,只是通过thread层面的隐藏延迟减少了部分因等待内存而导致算力浪费。
这里值得一提的是,独立PC和Stack的引入同时也解决Pre-Volta架构可能会死锁的问题。(Pre-Volta架构由于其刚性的SIMT执行模型,在处理Warp内部分线程依赖另一部分线程的场景时,易产生死锁。)
 图片
同步机制
前面提到了Warp层面和thread层面的延迟隐藏,那当我们Warp间或者同一个Warp中的不同thread间需要同步时,怎么办呢?
__syncthreads() 它保证一个Block内的所有线程都执行到这个Barriers后,才能一起继续往下执行。
__syncwarp() 它保证一个Warp内的32个线程都执行到这个Barriers后,才能继续往下执行。
总结
至此,我们大体了解了AI Infra场景下GPU的工作流程与编程模式:
从图形专用到GPGPU演进。CPU和GPU的协作通讯 命令缓冲区(Command Buffer)+ 门铃(Doorbell)。CUDA程序的生命周期。CUDA的编程模型(Grid -> Block -> Thread)与GPU的硬件架构(GPU -> SM -> Warp -> Core)。SIMT通过线程编程模型隐藏了底层SIMD的执行细节。Warp层面和thread层面的延迟隐藏,以及各自层面的同步函数(__syncthreads() 和 __syncwarp())。本文旨在了解单GPU场景下的工作流程,然而AI Infra背景下,单GPU往往是够用的,另外这里Cuda Streams、Unified Memory、MPS都没提,留给后续填坑了。下一篇将详细讲解GPU的性能优化相关知识。
-End-
原创作者|刘斌
以上就是每个程序员都应该了解的GPU工作原理:从硬件到架构的详细内容,更多请关注php中文网其它相关文章!
# 这是
# 网站SEO优化主要评估指标
# 营销短信推广话术技巧
# 陕西公司网站优化建设
# 正阳网站推广哪家好
# 广州市网站优化哪里靠谱
# 百度seo排名智能 乐云seo
# 尼姑福利seo查询
# 建设项目营销推广工作总结
# 建设银行苏州网站
# 黑龙江企业短视频营销推广
# 多少个
# 中文网
# 可编程
# 多线程
# 数据结构
# gpu
# 首次
# 显存
# 多个
# 工作原理
# 深度学习
# ai
# nvidia
# 显示器
# 工具
# 大数据
# 显卡
# 处理器
# 操作系统
# c语言
# php
相关栏目:
【
Google疑问12 】
【
Facebook疑问10 】
【
优化推广96088 】
【
技术知识133117 】
【
IDC资讯59369 】
【
网络运营7196 】
【
IT资讯61894 】
相关推荐:
500元一张的AI艺术二维码制作,详细教程来了!
为AI而服务设计:构建以人为本的AI创新方法
AI进军债券交易,BondGPT来了!
阿里达摩院向公众免费开放100项AI专利许可
Bing Chat 和 Bing Search 正式引入深色模式
九号公司主导制定短途交通和送物机器人领域首个国际标准,标志着零的突破发布
五个IntelliJ IDEA插件,高效编写代码
电力人工智能数据集目录首次发布
给小朋友最好的科技礼物:乐天派桌面机器人
WHEE功能介绍
百亿量化私募:量化投资进入“精耕细作”时代 AI带来行业新变革
亚马逊确认今年不举办re:MARS人工智能大会
2025VR&AR显示技术峰会展示歌尔光学最新一代光学模组
人手一部「*」!视频版Midjourney免费可用,一句话秒生酷炫大片惊呆网友
AI时代,企业需要什么样的员工?
洞穴探险神器?可自主导航的单旋翼自旋无人机,效率更高!
OpenAI 向所有付费 API 用户开放 GPT-4
微软为 AI 初学者推出免费网课:为期 12 周,共 24 节课
华为云发布华为云盘古模型3.0和升腾AI云服务,亮点亮相2025华为开发者大会
李开复:未来几年,人工智能会革了所有人的命,除非你这么做
华为4G5G通信物联网收费标准公布,多年研发成果,十年花费近万亿
特斯拉首发人形机器人“擎天柱”亮相世界人工智能大会
鸿蒙生态带来了哪些新的流量可能性,包括AI、服务分发和原生智能等方面?
普林斯顿大学推出Infinigen AI模型 可生成真实自然环境 3D场景
传字节内测对话式 AI 产品,代号「Grace」;马斯克嘲讽苹果 头显;比亚迪 F 品牌定名「方程豹」
Meta将VR头显最低年龄限制从13岁降至10岁
建立元宇宙产业联盟:移动、咪咕、华为、小米等加入
音乐制作元工具AudioCraft发布开源AI工具
扎克·施奈德新片《月球叛军》曝剧照 机器人首度现身
AI大模型,将为智慧城市带来哪些新变化?
ChatGPT设计出的第一个机器人来了!【附人工智能行业预测】
元宇宙技术带你穿梭“大运河”,江苏书展上的数字阅读馆吸睛小读者
微软 GitHub Copilot 编程助手被投诉:换口吻改写公共代码来躲版权
人工智能颠覆软件测试四大方式
五个出色的人工智能应用实例
五项人工智能尚未能够实现的任务
pixivFANBOX 更新运营规则,禁止通过外链绕开 AI 生成禁令
联想浏览器引入小乐 AI 助手,成功接入百度文心一言大模型,经过实测证实
广州团建公司方案 | 绝密飞行 → X-PLANE无人机团建主题团建
《流浪地球2》里机器人公司的创始人:未来10年,机器人的崛起!
美图吴欣鸿:希望更多人用上AI时代的影像生产力工具
外科医生的智能助手,“机器人手术”得到补充商业医保覆盖
复旦发布「新闻推荐生态系统模拟器」SimuLine:单机支持万名读者、千名创作者、100+轮次推荐
《自然》杂志拒绝刊登人工智能生成的图片和视频
人工智能框架生态峰会即将召开,聚焦AI大模型技术与科学智能探索!
发布最新版本的 PICO OS 5.7.0:支持VR头盔录屏并跨平台分享至微信
Meta发布"类人"AI图像创建模型,能解决多出手指等Bug
OpenAI 为开发者推出 GPT 聊天机器人 API 大更新,同时降低价格
13 个提高生产力的 AI 工具
人工智能的变革之路:通过OpenAI的GPT-4漫游
2025-10-22

运城市盐湖区信雨科技有限公司是一家深耕海外推广领域十年的专业服务商,作为谷歌推广与Facebook广告全球合作伙伴,聚焦外贸企业出海痛点,以数字化营销为核心,提供一站式海外营销解决方案。公司凭借十年行业沉淀与平台官方资源加持,打破传统外贸获客壁垒,助力企业高效开拓全球市场,成为中小企业出海的可靠合作伙伴。

 n) { y[index] = x[index] + y[index]; }}